先说结论:没有最好的轮换方式,只有最合适的
做数据采集、比价监控、批量注册测试的同学,几乎都被同一个问题困扰过:IP要不要换、多久换一次、什么时候该换。换得太勤,IP池消耗飞快、成本直线上升,需要保持登录态的业务还会被踢下线;换得太慢,请求量一集中,目标网站立刻给你返回验证码或者直接封禁。
目前主流的代理IP轮换策略就三种:按请求轮换、按时间轮换、按失败率轮换。这三种方式没有绝对的好坏,差别在于它们解决的是不同的问题。下面把每种策略的触发时机、优缺点、适用场景掰开揉碎讲清楚,最后再告诉你如何组合使用。
策略一:按请求轮换——每发一个请求就换一个IP
这是逻辑最简单、也最容易实现的一种方式:程序每发出一次请求,就从IP池里取出一个新的代理IP。假设你有 1000 个可用IP,那么这 1000 个IP会轮流被使用,相当于把访问压力平摊到所有IP上。
它的优势非常直接:单个IP的请求频次极低,目标网站很难通过访问频率识别出你,抗封能力最强。缺点同样明显——没有会话连续性。同一个任务前后两次请求来自不同IP,登录态、购物车、分页上下文全部丢失,如果目标站点对Cookie和IP有绑定校验,你会频繁被要求重新验证。
另外,按请求轮换对IP池的消耗是最大的。一个任务发出 1 万次请求,就要消耗 1 万个IP调用次数,如果用的是按量计费的产品,成本会很敏感。
# 按请求轮换的简化示意
for url in url_list:
    proxy = ip_pool.get_next()      # 每个请求都取一个新IP
    resp = request(url, proxy=proxy)
    if resp.ok:
        save(resp.text)
    else:
        ip_pool.mark_failure(proxy)
适合谁用:高频、无状态的采集任务,比如商品列表页抓取、搜索结果页遍历、关键词排名监控、公开资讯聚合。这类业务每次请求都是独立的,不依赖上下文,正好发挥按请求轮换的分散优势。
策略二:按时间轮换——每隔一段时间换一批IP
按时间轮换的思路是:一个IP连续使用固定时长(常见的是几十秒到几分钟),时间到了再换下一个。它的好处是在一段时间内保持IP稳定,会话、Cookie、缓存都能延续,特别适合需要翻页、需要登录、需要多步操作的业务流程。
难点在于"这个时间设成多少合适"。设得太短,和按请求轮换区别不大,还多了计时开销;设得太长,单个IP在单位时间内请求数过高,容易被频率规则命中。更麻烦的是,不同目标站点的容忍度差异很大,同一个IP在A网站用 3 分钟没事,在B网站可能 30 秒就触发风控。
实践中比较稳妥的做法是从保守值起步,边跑边调:先用 60 秒左右做一个基准,观察返回码里 403、429 的比例,比例偏高就缩短间隔,比例很低就适当拉长以节省IP。
适合谁用:需要保持会话连续性的任务,比如账号登录后的数据读取、多页商品详情遍历、表单分步提交、需要保持长连接的接口轮询。另外,隧道代理类产品通常可以在后台直接设置"切换间隔",本质上就是按时间轮换的一种托管形式。
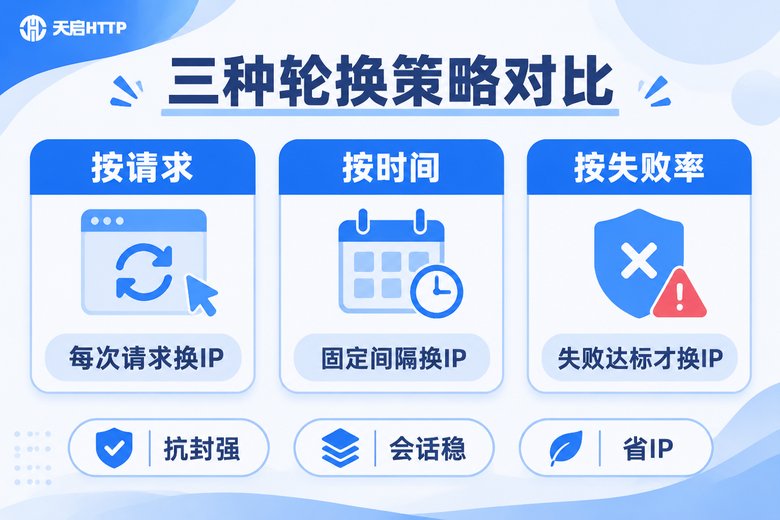
策略三:按失败率轮换——出了问题才换
按失败率轮换属于"自适应"思路:默认让一个IP一直用下去,只有当它的失败次数、连续失败次数或者失败比例超过设定阈值时,才把这个IP剔除并换新的。判定失败的信号包括:连接超时、返回 403/429、返回验证码页面、返回内容为空或者长度异常。
这种方式最大的价值是省钱且贴合真实情况。IP只要还在正常工作就继续用,不浪费调用次数;而一旦目标站点开始收紧风控,失败率上升,系统会自动加速换IP,相当于给采集程序装了一个"油门"。
缺点是实现起来最复杂,而且反应有滞后性——必须等失败真正发生,才知道这个IP不能用了。如果你的采集频率很高,一次风控触发可能已经产生了几十次无效请求。此外阈值定得不合理时,容易出现"一个IP刚被标记失败,重试时又抽到它"的情况。
适合谁用:目标站点相对稳定、追求成本可控、请求量中等的长期任务。比如每天固定跑几次的价格监控、库存监控,用失败率策略能把IP消耗压到很低。
三种策略横向对比
| 对比维度 | 按请求轮换 | 按时间轮换 | 按失败率轮换 |
|---|---|---|---|
| 切换触发条件 | 每发一次请求 | 固定间隔到期 | 失败数达阈值 |
| 抗封能力 | 强 | 中等 | 中等偏强 |
| 会话连续性 | 无 | 好 | 较好 |
| IP消耗量 | 最高 | 中等 | 最低 |
| 实现难度 | 低 | 低 | 较高 |
| 典型场景 | 列表页、搜索页、排名监控 | 翻页、登录态、接口轮询 | 长期监控、成本敏感型任务 |
从表格能看出一个规律:抗封能力强的策略,IP成本一定高;省IP的策略,反应速度一定慢。这就是为什么成熟的采集系统几乎不会只用一种策略。
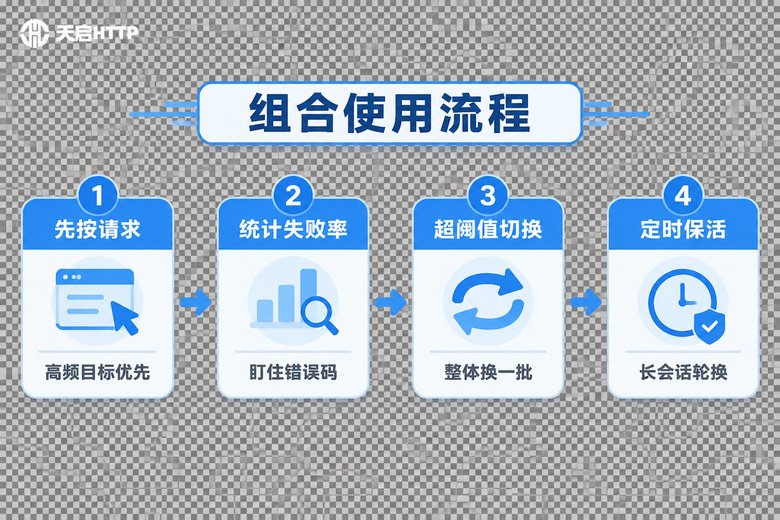
推荐的组合打法:主策略 + 兜底策略
结合上面三种方式的特性,实际项目里比较通用的组合是这样的:
第一步,用按请求轮换打底。大部分列表页、详情页这类无状态请求直接走按请求轮换,把请求压力均匀分散到整个IP池上,这是最省心的默认配置。
第二步,加一层失败率监控。对每个IP记录成功和失败的次数,连续失败达到 2 到 3 次就标记为"冷却中",一段时间内不再分配给它。这一步能显著减少无效重试。
第三步,为需要会话的任务单独开一条通道。登录、翻页、下单这类流程,单独分配一个IP,并设置固定的保活时长,比如 2 到 5 分钟后才允许切换,避免中途被踢出登录态。
第四步,全局失败率报警。如果最近 5 分钟的总体失败率超过某个比例(比如 15%),说明当前IP池质量下降或者目标站点风控升级,这时候应该整体换一批IP,而不是继续在旧IP上重试。
选策略之前,先看看你手里的IP池质量
同样的策略,换在不同质量的IP池上,效果可能天差地别。一个IP可用率只有 60% 的池子,不管你用哪种轮换方式,失败率永远下不来;而一个稳定可用的IP池,哪怕用最简单的按时间轮换也能跑得很顺。
所以调策略之前,建议先做两件事:一是统计IP的可用率和平均响应时间,二是统计不同业务目标的失败构成(到底是连接超时多,还是 403 多)。前者决定你需不需要换服务商,后者决定你的轮换阈值该定在哪里。
天启HTTP 作为国内代理IP服务商,提供短效代理、独享代理、隧道代理等多种产品形态,支持 HTTP、HTTPS、SOCKS5 协议,节点覆盖国内多个城市,并提供 API 提取方式,方便程序按需拉取IP。其中隧道代理支持在后台设置IP切换方式与切换间隔,对于不想自己写轮换逻辑的团队来说,"按时间轮换"这部分可以直接交给服务端托管,程序侧只需要处理失败重试即可。
需要注意的是,天启HTTP 提供的是国内代理IP,适合面向国内网站的业务场景,并不适用于需要访问境外站点的需求。
几个容易踩的坑
坑一:只换IP不换请求头。IP换了,但 User-Agent、请求间隔、Cookie 完全一模一样,风控照样能把你串起来。轮换IP的同时要配合请求头随机化和合理的访问节奏。
坑二:并发数拉得太高。就算IP再多,如果同一秒内并发几百个请求,目标站点的服务器压力监控也会触发拦截。控制并发、加一点随机延时,比换IP更有效。
坑三:失败后立刻用同一个IP重试。很多新手程序在失败后原地重试三次,三次全是同一个IP,等于给目标站点送人头。正确做法是失败后先标记该IP冷却,再从池里取新的IP。
坑四:把所有业务塞进一个IP池。不同目标站点的风控强度不同,被重罚的IP会污染整个池子。建议按业务线拆分IP池,让风险隔离。
常见问题
Q:按请求轮换是不是一定比按时间轮换好?
不是。按请求轮换抗封更强,但没有会话连续性,IP消耗也最大。如果你的业务需要保持登录状态或者连续翻页,按时间轮换反而更合适。判断标准是:这次请求是否依赖上一次请求的上下文。
Q:失败率阈值设多少比较合适?
可以从"连续失败 2 次即冷却 + 单个IP失败率超过 30% 即剔除"开始试,然后根据实际返回码分布调整。如果目标站点风控较松,可以放宽到连续失败 3 次;如果风控很严,1 次失败就可以直接冷却。
Q:按时间轮换的间隔设多久?
先设 60 秒做基准,观察 403 和 429 的占比。占比高就缩短到 30 秒甚至 15 秒;几乎没有报错就适当拉长到 2 到 3 分钟,节省IP消耗。不要凭感觉拍脑袋定一个数字就不管了。
Q:IP池里需要放多少个IP才够?
没有固定答案,取决于你的请求总量和目标站点的容忍度。一个粗略的参考是:用每分钟的请求总数除以单个IP每分钟的安全请求数,再乘 1.5 到 2 倍的冗余系数。比如每分钟 600 个请求、单IP每分钟安全值 10 次,大致需要 90 到 120 个可用IP。
Q:天启HTTP 的隧道代理还需要自己写轮换逻辑吗?
基本的IP切换可以交给隧道代理在后台配置完成,程序侧只需要处理请求失败、超时和重试逻辑。如果需要按失败率自适应调整,仍然建议在业务代码里保留失败计数与IP冷却机制。
Q:这三种策略可以同时用吗?
可以,而且推荐这样用。常见的做法是:无状态请求走按请求轮换,会话型任务走按时间轮换,同时在全局层面用失败率决定整池切换的时机,三层配合起来既省钱又抗封。