为什么"稳定"比"便宜"更值得先看
很多人第一次买代理IP,关注点几乎都落在价格和数量上:多少钱一天、能提多少个。真正用起来才发现,真正让你加班到深夜的不是IP不够用,而是跑着跑着就断、请求一半失败、报错还找不到原因。
一个便宜但掉线率高的代理池,实际成本远高于标价:程序要加重试、任务要重跑、数据要补采、人工要盯着。所以挑选稳定IP代理的正确顺序,应该是先看稳定性指标,再看覆盖与价格。而判断稳定性,绕不开三个词:掉线率、可用率、SLA。
掉线率:最容易被忽略、也最伤业务的指标
掉线率指的是在统计周期内,代理连接失败或中途断开的请求,占总请求数的比例。它和"IP能不能用"是两件事:IP提取出来是有效的,但连上去就断,同样属于掉线。
常见的掉线原因大致有三类:一是代理服务器负载过高,连接被拒绝;二是节点资源被滥用,触发限速或封禁;三是IP本身已经被目标站点标记,握手阶段就被掐断。前两类是服务商侧的问题,第三类则需要你在业务侧做轮换策略。
计算方式很朴素:掉线率 = 失败请求数 ÷ 总请求数 × 100%。但要注意统计口径——有的服务商按"IP数量"统计,一个IP能用就算成功,哪怕它十分钟里断了八次;有的按"请求次数"统计,更贴近真实体验。挑选时一定问清楚口径,否则两个数字根本没法比。
可用率与掉线率不是一回事
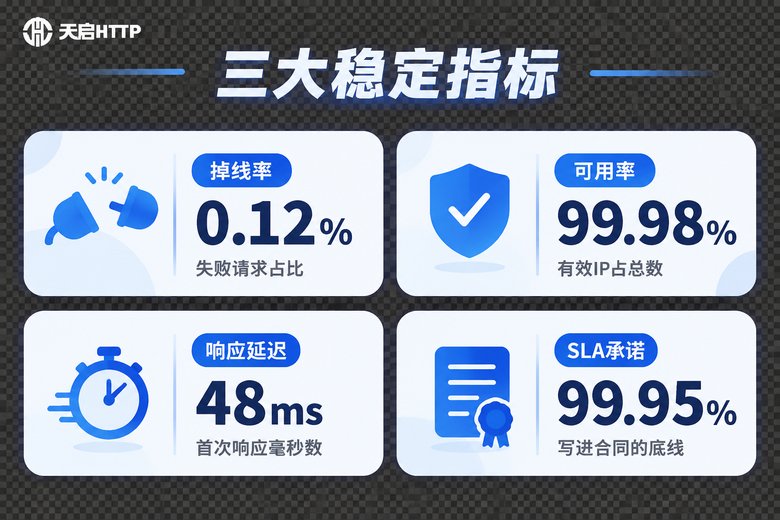
可用率通常指提取到的IP池中,实际能成功建立连接的比例。它反映的是"货够不够纯",掉线率反映的是"用着稳不稳"。一个可用率99%但掉线率10%的服务,体验可能还不如可用率90%、掉线率1%的服务。
| 指标 | 衡量什么 | 常见统计口径 | 对业务的影响 |
|---|---|---|---|
| 可用率 | 提取到的IP里有多少真的能连通 | 可用IP数 ÷ 提取IP总数 | 影响任务启动阶段的浪费率 |
| 掉线率 | 使用过程中连接中断的比例 | 失败请求数 ÷ 总请求数 | 影响长任务、连续操作的成功率 |
| 响应延迟 | 建立连接到返回首字节的速度 | 平均响应时间 / P95 响应时间 | 影响采集速度与并发成本 |
| SLA 承诺 | 服务商愿意写进合同的底线 | 按月度可用率、故障恢复时长计 | 影响出问题时的兜底能力 |
建议把可用率当作"入场门槛",把掉线率和延迟当作"长期体验"。门槛之外,真正决定你能不能安心跑业务的是后两项。
SLA 指标该怎么读,别只看那句"高可用"
SLA(服务等级协议)本质上是服务商给你的书面底线。一份有意义的SLA,至少要说清楚四件事:承诺的可用率是多少、按什么口径统计、出故障后多久响应和恢复、没做到怎么补偿。
读SLA时,重点看这几处:
第一,统计周期。是按自然月统计还是按天?按天统计的要求会严格得多,也更值得信任。
第二,故障响应与恢复时间。只说"7×24技术支持"是不够的,要看有没有明确的响应时限和恢复目标。
第三,补偿方式。没达标的处理方式是延长时长、补发额度还是其他形式,写不写清楚,直接反映服务商对自家稳定性的信心。
第四,例外条款。目标站点反爬策略变更、用户自身网络问题、违规使用导致的封禁,一般都不在承诺范围内,这部分要提前看懂,避免事后扯皮。
自己动手实测:四步算出真实掉线率
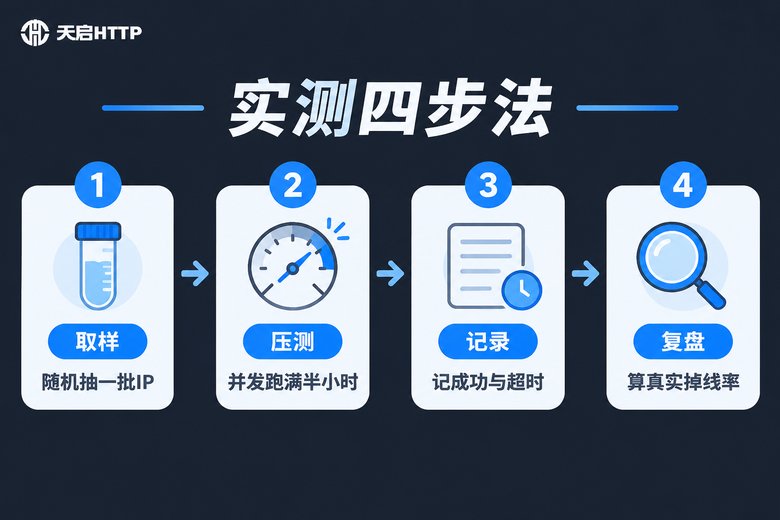
别人的宣传数字只能参考,自己测一遍最靠谱。方法不复杂,准备一段小脚本就够了。
第一步,取样。随机从接口提取一批IP,不要只挑前面几个,也不要人为筛选。
第二步,压测。用固定并发跑一段时间,建议不少于30分钟,覆盖你真实的业务节奏。
第三步,记录。把成功、超时、连接失败分开计数,不要笼统合并成"失败"。
第四步,复盘。算出成功率、平均延迟和P95延迟,再对照业务能接受的水平下结论。
import time
import requests
from concurrent.futures import ThreadPoolExecutor

# 天启HTTP 提取到的代理,格式:http://用户名:密码@服务器地址:端口
PROXIES = ["http://user:pass@proxy1:port", "http://user:pass@proxy2:port"]
TARGET = "http://httpbin.org/ip"   # 换成你自己的测试页更贴近业务
TIMEOUT = 5

stats = {"ok": 0, "timeout": 0, "fail": 0}
latency = []

def probe(proxy):
    conf = {"http": proxy, "https": proxy}
    start = time.time()
    try:
        r = requests.get(TARGET, proxies=conf, timeout=TIMEOUT)
        cost = (time.time() - start) * 1000
        if r.status_code == 200:
            stats["ok"] += 1
            latency.append(cost)
        else:
            stats["fail"] += 1
    except requests.exceptions.Timeout:
        stats["timeout"] += 1
    except Exception:
        stats["fail"] += 1

for _ in range(3):  # 跑3轮,每轮全部IP各测一次
    with ThreadPoolExecutor(max_workers=10) as pool:
        pool.map(probe, PROXIES)

total = sum(stats.values())
drop = (stats["timeout"] + stats["fail"]) / total * 100
latency.sort()
p95 = latency[int(len(latency) * 0.95) - 1] if latency else 0

print(f"总请求 {total},成功 {stats['ok']},超时 {stats['timeout']},失败 {stats['fail']}")
print(f"掉线率 {drop:.2f}%  平均延迟 {sum(latency)/len(latency):.0f}ms  P95 {p95:.0f}ms")
跑完之后,如果掉线率长期高于你的业务容忍度,或者P95延迟波动特别大,说明这条线路不适合承载长时间任务,换服务比加重试更省钱。
挑选稳定IP代理的五个检查点
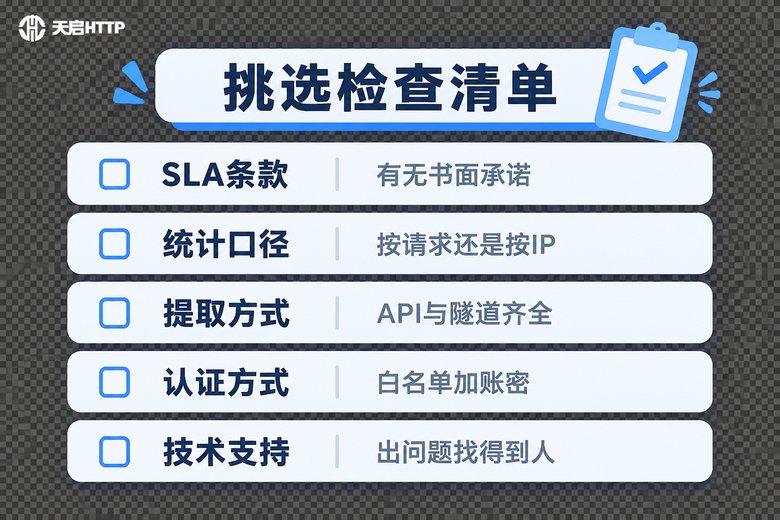
把上面的指标落到选购动作上,可以整理成一张清单:
看SLA条款是否书面化。口头承诺"很稳"没有意义,能落到合同或服务说明里的才算数。
看统计口径是否透明。可用率、掉线率是按请求算还是按IP算,必须问得清清楚楚。
看提取与使用方式是否齐全。API提取适合按需取用,隧道代理适合长期固定出口,两种都能覆盖才灵活。
看认证方式是否安全。白名单和账密认证各有场景,支持两种可以避免把密码硬编码进代码。
看技术支持是否找得到人。稳定性出问题时,响应速度往往比价格更能决定损失大小。
天启HTTP 在稳定性上的几个设计取向
天启HTTP 是国内HTTP代理IP服务商,专注于为国内业务场景提供代理IP服务。在稳定性这件事上,它有几个值得关注的点:
提供API提取方式,程序可以按需拉取IP,配合业务侧的轮换策略使用;同时支持HTTP、HTTPS等常用协议,接入现有代码基本不用大改。
支持白名单与账密两种认证方式,终端IP固定的场景用白名单,多机器或动态IP的场景用账密,避免把认证信息散落在各处。
提供独享类型的代理资源,适合对连续性要求高、不希望和别人共享出口的任务,从源头上减少因他人滥用导致的连带掉线。
配有技术支持和明确的服务说明,遇到连接异常时可以找到人排查,而不是只对着文档猜。
需要说明的是,天启HTTP 面向的是国内IP代理场景,如果你需要的是海外节点,它并不适用;它的产品线里也没有住宅代理这一类资源,选型时请按自己的实际需求对号入座。
常见问题
Q:掉线率多少算合格?
没有统一标准,取决于业务容忍度。短任务、可以轻松重试的场景,掉线率3%以内通常可以接受;长连接、连续操作、对成功率敏感的场景,建议压到1%以内再考虑长期使用。
Q:可用率标称99%,为什么我用起来感觉差很多?
先确认统计口径。有些可用率是按"IP能否建立一次连接"算的,而你的业务是持续跑几十分钟,两者的体验完全不同。建议自己按请求维度实测一遍。
Q:延迟高和掉线率高,哪个更影响效率?
延迟高主要拖慢单次请求速度,表现为"整体变慢";掉线率高会导致任务中断和重试,表现为"不稳定"。一般先解决掉线,再优化延迟。
Q:只有一台机器,还需要关心并发和认证方式吗?
需要。单机也会遇到账号密码写在代码里被泄露的风险,白名单可以规避这类问题;并发限制则直接决定你能不能把任务跑满。
Q:测出来掉线率偏高,是我代码的问题还是代理的问题?
先用同一段脚本、同一个目标地址,分别测代理和直连做对比。如果直连稳定而代理波动大,问题多半在链路侧;也可以把超时、失败分开记录,交给服务商技术支持排查更快。
Q:SLA没写补偿条款,是不是就一定不能选?
不一定,但说明服务商对稳定性的兜底意愿较弱。这类服务更适合做辅助线路或临时任务,不建议承载核心业务。