一、先把结论说清楚:高速IP代理有用,但不是万能加速器
很多人第一次接触代理IP,心里都会有一个疑问:加了代理,速度到底是变快还是变慢?这个问题没有统一答案,因为代理本质上是一个"中转站"——你的请求先从本地发到代理节点的服务器,再由节点转发给目标站点,返回的数据也要原路走一遍。多了一跳,理论上一定会多一点耗时。
那为什么还有人说高速IP代理"很有用"?因为在真实业务里,拖慢速度的往往不是"多了一跳",而是下面这几件事:
本地出口拥堵、被目标站限流、单个IP被频繁请求导致响应变慢、DNS解析绕路、连接反复重建浪费握手时间。这些问题用一条稳定高速的代理链路,是能够明显改善的。
所以更准确的说法是:高速IP代理不是一个"加速开关",而是一条"更可控的通道"。它的价值在于让链路变得可测量、可替换、可优化。你现在跑得慢,到底是本地的问题、节点的问题,还是目标站的问题——有了代理这条可控链路,才有可能定位出来。
二、把速度拆开看:一次请求要经过三段链路
想定位瓶颈,先得知道一次请求的时间花在哪。可以粗暴地分成三段:
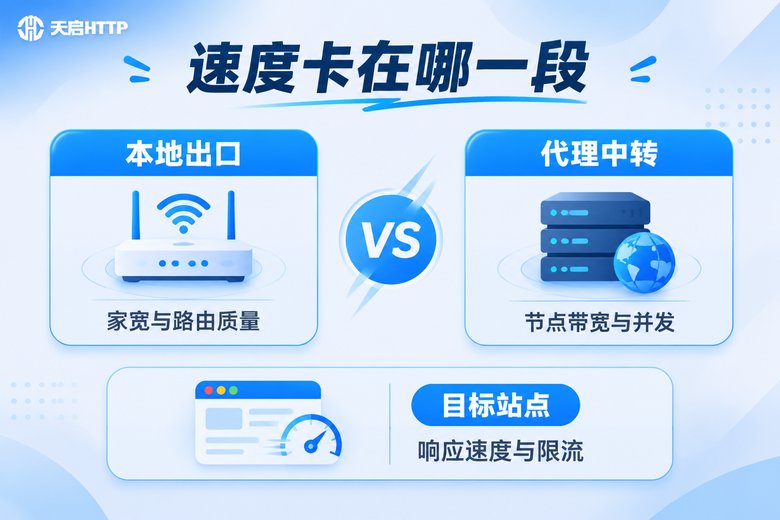
| 链路环节 | 典型耗时 | 常见拖慢原因 | 优化方向 |
|---|---|---|---|
| 本地 → 代理节点 | 几毫秒到几十毫秒 | 跨省节点、本地带宽被占满、WiFi信号差 | 换同城或同省节点、走有线网络 |
| 代理节点 → 目标站点 | 十几毫秒到上百毫秒 | 节点出口带宽不足、节点并发过高、目标站限流 | 换低负载节点、降低并发、控制请求频率 |
| 目标站点处理并返回 | 几十毫秒到数秒 | 目标站本身慢、返回内容大、被风控拖慢 | 压缩传输、减少无用字段、分散IP请求 |
看这张表你会发现一个关键点:如果你的业务本来就慢在第三段,也就是目标站自己响应慢,那换什么代理都没用。这就是很多人"换了高速代理还是不理想"的根本原因。
三、瓶颈定位实操:四步排查法
光靠感觉判断"是不是代理的问题"非常不可靠,必须用数据说话。下面这套四步法,基本可以覆盖大部分场景。
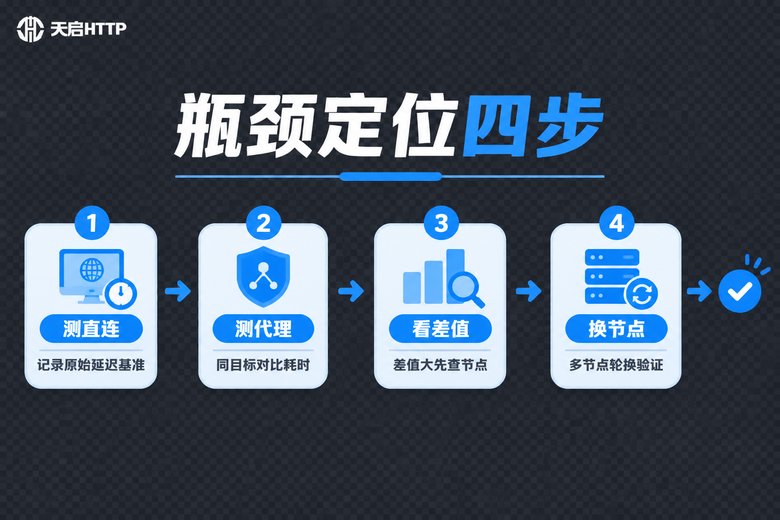
第一步:测直连基线。在不挂代理的情况下,对同一个目标地址连续请求若干次,记录平均耗时和成功率。这一步是"对照组",没有它后面的对比就没有意义。
第二步:测代理链路。挂上代理,对同一个目标地址用同样的请求次数再跑一遍。注意访问的目标地址、请求参数、并发数都要保持一致,只改变"是否走代理"这一个变量。
第三步:看差值。把两次结果相减,差值就是代理链路本身带来的额外开销。一般来说,同城优质节点带来的额外耗时很小;如果你看到差值是几百毫秒甚至上秒级,那基本可以锁定问题在节点或本地出口这一段。
第四步:换节点验证。在同一个服务商里换几个不同城市的节点再测。如果换成某个节点后耗时立刻回落到正常水平,说明是这个节点的负载或线路问题,而不是你的代码或目标站的问题。
下面是一段简单的计时代码,可以直接拿去用:
import time
import requests

# 代理信息换成你自己在后台看到的地址、端口、账号密码
proxy = "http://账号:密码@代理服务器地址:端口"
proxies = {"http": proxy, "https": proxy}

url = "https://你要访问的目标站点/"
headers = {"User-Agent": "Mozilla/5.0"}

def bench(use_proxy=True, times=10):
    costs = []
    ok = 0
    for _ in range(times):
        start = time.time()
        try:
            r = requests.get(
                url,
                headers=headers,
                proxies=proxies if use_proxy else None,
                timeout=10,
            )
            cost = (time.time() - start) * 1000
            if r.status_code == 200:
                ok += 1
                costs.append(cost)
        except Exception as e:
            print("请求异常:", e)
    if not costs:
        return None
    avg = sum(costs) / len(costs)
    print(f"是否走代理={use_proxy} 平均耗时={avg:.0f}ms "
          f"最快={min(costs):.0f}ms 最慢={max(costs):.0f}ms 成功={ok}/{times}")
    return avg

direct = bench(use_proxy=False)
via_proxy = bench(use_proxy=True)

if direct and via_proxy:
    print(f"代理带来的额外开销约为 {via_proxy - direct:.0f}ms")
跑完这段代码,你会得到一个非常直观的数字。额外开销在几十毫秒内,属于正常范围;超过两百毫秒,就值得去查节点了。
四、链路优化的五个实操动作
定位出瓶颈之后,优化才有的放矢。下面这几条是最容易见效的:
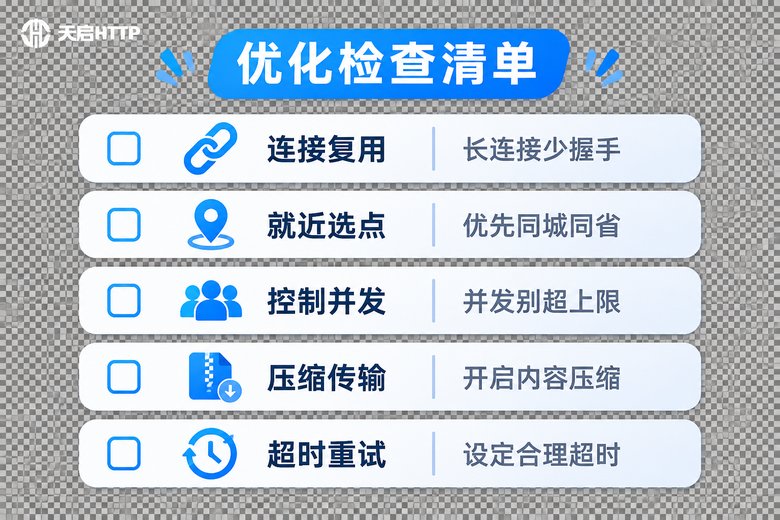
1. 就近选节点。优先选同城或同省的节点。物理距离直接决定网络往返时间,这一条带来的提升往往比换服务商更明显。
2. 连接复用。频繁新建连接意味着每次都要重新握手,开销不小。用会话对象(Session)复用连接,能省掉大量重复的建连时间。
3. 控制并发。并发不是越高越快。当并发数超过节点或目标站的承受能力,延迟会明显上升,成功率反而下降。找到那个"拐点"并发数,比盲目加线程更有价值。
4. 开启传输压缩。返回内容越大,传输时间越长。开启压缩能显著降低传输耗时,尤其是返回结构化文本数据的场景。
5. 设合理的超时与重试。超时设得太长,一个卡住的请求会拖住整批任务;设得太短,正常波动也会被误判为失败。建议先按实测平均耗时的一倍到两倍来设置,再配合有限次数的重试。
另外,协议的选择也值得留意。HTTP、HTTPS、SOCKS5 三种协议适用的场景不同,业务需要什么就选什么,别为了"看起来更高级"而上不必要的封装。
五、这几种情况下,高速IP代理帮不上忙
说真话,代理不是万能的。下面几种情况,换再快的代理也不会有明显改善:
目标站点自身响应慢。对方服务器处理一个请求就要一两秒,你这边再怎么优化链路,总耗时也降不下来。
本地带宽已经跑满。本地出口被下载、视频、其他任务占满,代理链路再快也堵在门口。先看一眼本地的网络占用情况。
问题其实是"IP被封",不是"速度慢"。如果表现是大量请求返回错误页、验证页,而不是单纯变慢,那这是可用性问题,需要调整换IP的策略和请求节奏,而不是一味追求速度。
目标站对同一IP的请求频率有限制。这时候提速反而会更快触发限制。降低频率、分散IP,比提高速度更有效。
六、链路优化这件事,天启HTTP能帮上什么
做链路优化,工具的选择会直接影响你排查的效率。天启HTTP 是国内IP代理服务商,提供 HTTP、HTTPS、SOCKS5 协议的代理服务,节点覆盖国内多个城市,主要能在这几个方面配合你的优化工作:
节点可替换。排查瓶颈最关键的一步就是"换节点验证"。节点资源足够多,才能在发现某个节点延迟异常时快速切走,而不是干等。
按业务形态选产品。短效代理适合需要频繁更换IP的采集类业务,隧道代理适合不想手工维护IP池、希望自动切换的场景,独享代理和静态代理适合对IP稳定性要求较高的业务。选对类型,比反复调参数更省事。
链路可量化。配合上面那套计时代码,你可以对自己的每条链路建立一份基线数据。跑一段时间的对比之后,哪类任务该用哪类节点,心里就有谱了。
需要提醒一句:天启HTTP 提供的是国内IP代理服务,如果你的业务需要访问境外站点,那并不在它的适用范围之内。选工具之前,先把业务边界想清楚。
常见问题
Q:加了代理之后速度变慢了,是不是代理质量不行?
不一定。先用第三部分的四步法测一下额外开销。如果额外开销只有几十毫秒,那慢的原因大概率在目标站或本地网络;如果额外开销达到几百毫秒,再考虑换节点或换服务商。
Q:同一个代理服务商,为什么不同节点速度差很多?
节点所在城市、出口带宽、当前并发量都不同。跨省节点的往返时间天然更长,高峰期节点负载也会上升。优先选就近节点,并且避免只依赖单一节点。
Q:并发开得越高,采集速度就越快吗?
不是。并发超过节点和目标站的承受能力后,延迟会明显上升、成功率下降,整体反而更慢。建议逐步加压,找到成功率开始下滑的那个并发值,然后留一点余量。
Q:短效代理、隧道代理、独享代理该怎么选?
看业务对"IP更换频率"和"IP稳定性"的要求。需要不断换IP、对单IP依赖低的,选短效;不想手工维护IP池、希望自动切换的,选隧道;需要长期稳定使用同一批IP的,选独享或静态。
Q:怎么判断慢是代理的问题还是目标站的问题?
最直接的办法是对比:同一个目标地址,分别测直连和走代理。如果两者都很慢,问题在目标站或本地网络;如果只有走代理慢,问题在节点链路。
Q:优化链路需要改代码吗?
不一定。很多优化点属于配置层面,比如换节点、调并发、设超时。但连接复用、重试逻辑这类改动确实需要动代码,收益也比较明显,建议优先做。