为什么"随手测一下"判断不了IP稳不稳定
很多人测代理IP的方式是这样的:拿到一组IP,打开一个检测网站,挨个访问一遍,能通就记一个"可用"。十分钟后得出结论——这家的IP不错。然后真正上线跑业务,第二天就开始掉线、超时、验证码暴涨。
问题不在于你测错了,而在于测得太少、太集中、太表面。常见的三个坑:
第一,样本太小。一个IP只请求三五次,恰好都成功,不代表它稳定。代理IP的失败往往是间歇性的,可能一百次里错五次,你测五次根本碰不到。
第二,时段单一。你在上午十点测得很顺,但很多线路的问题出现在晚间高峰、凌晨切换批次、或者整点换IP的时间点。只测一个时段,等于只看了半张脸。
第三,只看通不通,不看抖不抖。能用和好用是两回事。一个成功率99%但延迟忽高忽低的代理,在采集、注册、多开这类场景里,实际表现可能比成功率95%但延迟平稳的代理差得多。
所以正确的做法不是"测一次",而是按指标、按时段、连续多天记录。下面这套七天方案,就是按这个思路设计的。
先定指标:稳定性要用数字说话
在开始测之前,先把"稳定"翻译成可以记录的数字。否则七天后你手上只有一堆感觉,没有结论。
| 指标 | 含义 | 参考合格线 |
|---|---|---|
| 请求成功率 | 成功拿到业务数据的次数占比 | 采集/注册类 ≥ 95%,长期挂机类 ≥ 99% |
| 平均响应时间 | 一次完整请求的耗时(毫秒) | 国内线路 300ms 以内比较舒服 |
| P95 延迟 | 100 次里最慢那 5 次的水平 | 不超过平均值的 2 倍 |
| 延迟抖动 | 延迟的标准差,反映波动幅度 | 越小越好,突然放大说明线路有问题 |
| 单 IP 存活时长 | 同一个出口IP连续可用的时间 | 要和你买的IP类型对得上(短效/独享) |
| 并发掉线率 | 并发数提高后失败比例的增幅 | 并发翻倍,成功率下降不超过 2 个百分点 |
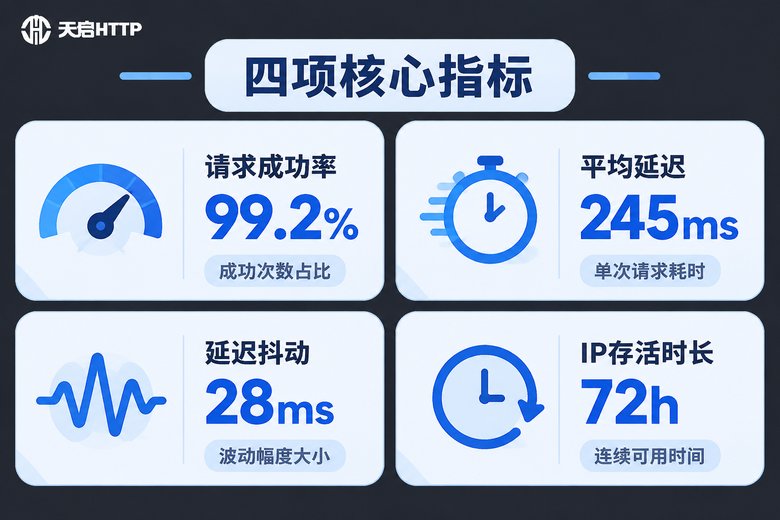
这六项里,成功率和延迟抖动是必测项,其余按你的业务场景取舍。比如做数据采集,P95延迟比平均延迟更有参考价值;做账号类业务,单IP存活时长和并发掉线率更关键。
七天连续监控方案怎么排
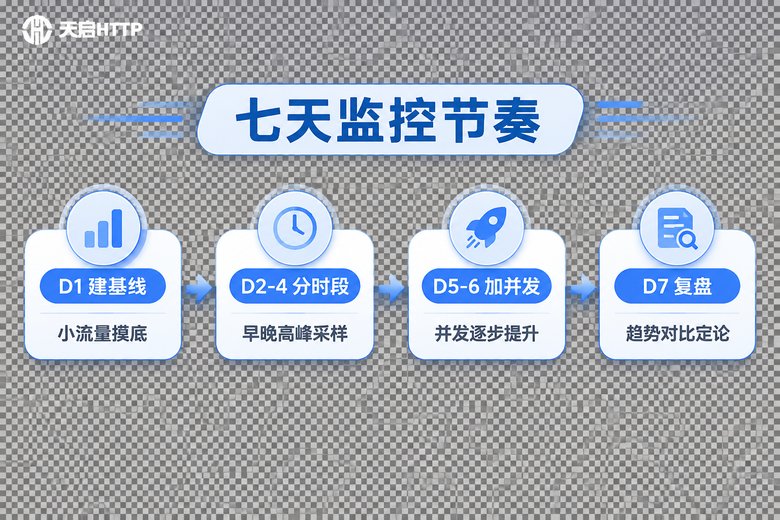
七天的意思不是连续挂机168小时,而是覆盖不同的日期、时段和压力水平。这样得出的结论才经得起推敲。整体节奏可以这样排:
准备工作(D0):准备一个固定的检测地址——最好是你真实业务的接口或者一个返回极快的页面,不要用会变动的第三方页面,否则你分不清是代理的问题还是目标站的问题。同时准备好记录表格或脚本。
第1天:建基线。用低频率连续探测,比如每 60 秒请求一次,跑 2 小时。这一步不是测极限,而是拿到"正常情况下长什么样"的数据,作为后面几天的参照。
第2—4天:分时段采样。每天至少覆盖三个时段——上午 9 点到 11 点、下午 2 点到 4 点、晚上 8 点到 10 点。每个时段跑一轮相同次数的探测。很多线路的差异就藏在这个对比里。
第5—6天:压力观察。在原有频率基础上把并发数往上提,比如从单线程提升到 5 线程、10 线程,看成功率和延迟怎么变化。这里最重要的是找"拐点":并发到多少的时候,成功率开始明显下滑。
第7天:汇总复盘。把七天的数据按天、按时段、按IP分别聚合,看趋势线是平的、下滑的,还是锯齿状的。这时候结论基本就出来了。
如果不想手工点,一个简单脚本就能把整天的数据记下来。下面这段跑在本地即可,只需要替换代理地址和检测地址:
import csv
import time
import requests
from datetime import datetime

PROXY = "http://用户名:密码@代理地址:端口"      # 换成你自己的代理信息
CHECK_URL = "https://你的业务域名/api/ping"     # 换成真实可访问的检测地址
ROUNDS = 60        # 本次跑多少轮
INTERVAL = 60      # 每轮之间间隔多少秒

fields = ["时间", "是否成功", "状态或异常", "耗时ms"]

with open("proxy_stability.csv", "a", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=fields)
    if f.tell() == 0:
        writer.writeheader()

    for i in range(ROUNDS):
        start = time.time()
        ok, note = 0, ""
        try:
            resp = requests.get(
                CHECK_URL,
                proxies={"http": PROXY, "https": PROXY},
                timeout=10
            )
            ok = 1 if resp.status_code == 200 else 0
            note = str(resp.status_code)
        except Exception as e:
            note = type(e).__name__
        cost = round((time.time() - start) * 1000)

        writer.writerow({
            "时间": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
            "是否成功": ok,
            "状态或异常": note,
            "耗时ms": cost
        })
        f.flush()
        time.sleep(INTERVAL)
跑完之后,用几行代码把每天的数据聚合出来,趋势一目了然:
import pandas as pd

df = pd.read_csv("proxy_stability.csv")
df["日期"] = df["时间"].str[:10]

report = df.groupby("日期").agg(
    样本数=("是否成功", "size"),
    成功率=("是否成功", "mean"),
    平均延迟=("耗时ms", "mean"),
    延迟P95=("耗时ms", lambda s: s.quantile(0.95)),
    延迟抖动=("耗时ms", "std")
)
report["成功率"] = (report["成功率"] * 100).round(2)

print(report.round(1))
脚本本身不复杂,关键是每天都跑、字段统一。如果换IP批次或者换供应商,记得在表格里加一列"批次"做区分,否则七天的数据会混在一起,没法归因。
数据记录表怎么设计
不管用脚本还是手工,建议原始记录至少包含下面这些字段。原始记录一定要保留,聚合报表是后面算出来的,原始数据丢了就补不回来了。
| 字段 | 填写说明 |
|---|---|
| 日期时间 | 精确到分钟,方便按天、按时段聚合 |
| IP / 批次 | 记录出口IP和所属批次,便于定位某批IP的问题 |
| 是否成功 | 统一用 1 / 0,别用"还行""可以"这种描述 |
| 异常类型 | 超时、连接被拒、407鉴权失败、403拦截等分开记 |
| 耗时(毫秒) | 从发起到拿到完整响应的总耗时 |
| 并发数 | 这一轮用了几个线程,方便对比拐点 |
| 备注 | 换过IP、重启过脚本、目标站有变动,都写一句 |
有个细节值得强调:异常类型要分开记。超时多,通常是线路质量或带宽问题;407、401这类是鉴权配置错了,属于自己这边的问题;403、429密集出现,多半是被目标站识别了。三种情况对应的处理方式完全不同,混在一起记就只能得出"不好用"这三个字。
三种典型曲线,一眼看出问题在哪
七天数据摆在面前,大多数人会觉得没头绪。其实常见的情况就三种,对应三种结论:
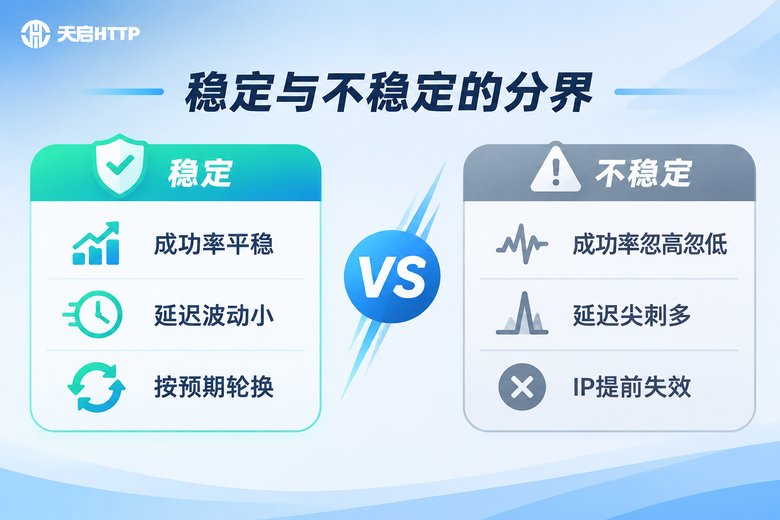
第一种,平稳线。七天的成功率都在同一个区间小幅波动,延迟平均值和P95差距不大,抖动小。这是真正稳定的表现,值得长期用。
第二种,台阶式下跌。前两天很好,第三天开始成功率掉一个台阶,之后维持在新水平。这通常说明是IP批次被消耗或者被目标站特征识别了,不是你用的方式错了。解决办法是换提取策略、缩短IP使用周期,或者干脆换独享IP。
第三种,锯齿状抖动。整体成功率不低,但一天里反复高低起伏,延迟尖刺很多。这多半是线路本身拥挤或者共享资源被抢占导致的,尤其在晚间高峰更明显。这种IP拿来跑对时效敏感的业务会很痛苦。
另外提醒一句,读数据的时候要排除掉自己这边的干扰。比如本地网络在下载大文件、目标站在维护、脚本某天忘记跑了,这些都会污染结论。所以第七天复盘时,先看看每天的样本数是否接近,样本数明显偏少的那天,数据要打折看。
用天启HTTP做这套测试会更省事
上面这套方案对IP服务本身有几个隐含要求:要能稳定提取、要能指定使用时长、要能扛住连续几天不间断的调用、出问题时查得到原因。如果服务商的基础设施不扎实,你测出来的数据其实是在测它的短板,而不是测你业务适配度。
天启HTTP 是国内代理IP服务商,提供短效代理、隧道代理、独享IP、API提取等产品形态,比较适合按上面的方案做长周期验证:
按需提取,方便控制变量。通过API按量提取IP,你能精确记录每一批IP的提取时间和使用范围,测试数据里"批次"这一列才有意义。
隧道代理适合做连续监控。不需要每次手动换IP,入口保持稳定,你的监控脚本可以一直跑,测出来的曲线更能反映真实使用状态。
独享IP适合做稳定性上限测试。排除掉共享资源抢占的干扰,你才知道自己业务的瓶颈到底在哪一端。
国内节点覆盖。天启HTTP 面向国内业务场景,做本地化业务验证时地域匹配度更好。需要提醒的是,它不适用于需要海外网络的场景,产品线中也没有住宅类IP,选型时要先确认你的业务属于哪一类。
具体的产品规格、提取方式和计费口径,建议直接到官网核对最新信息,再对照你的测试方案去选型,不要凭印象下单。
常见问题
Q:七天必须连续跑不停吗?
不必。真正要保证的是"覆盖",即覆盖不同日期、不同时段、不同并发水平。每天跑三段、每段二十分钟,也比连续挂三天只用一种频率更有参考价值。
Q:一天要测多少次才够?
建议至少 300 次以上,成功率这类比例指标样本太少会失真。如果测的是短效IP,单IP本身用不了太久,就把样本量摊到多个IP上统计。
Q:成功率多少才算稳定?
看业务。数据采集、批量注册这类能容忍重试的场景,95% 以上就够用;长期挂机、直播推流、多开托管这类对中断敏感的场景,建议 99% 以上,并且延迟抖动要小。
Q:为什么我测的时候很好,上线就差很多?
大概率是并发和访问频率变了。测试时单线程慢跑,上线后几十个线程同时请求,目标站的行为和线路压力都完全不同。所以第5—6天的压测环节不要跳过。
Q:几个IP都不稳定,是不是服务商不行?
先排除三类自身问题:检测地址是否稳定、鉴权配置是否正确、请求头是否被目标站判定为异常。都排除了,再看是不是IP批次的问题,换一批再测一天做对比。
Q:短效IP怎么测存活时长?
同一个IP反复请求,记录第一次成功和第一次失败的时间差,就是它的实际可用时长。测十几个IP取中位数,比看宣传参数更靠谱。