代理IP延迟高,很多人第一反应是"这家代理不行",其实更常见的情况是:链路某一段绕了远路、节点选得不合适、或者协议和连接方式用错了。延迟是一个可以逐段拆开测量的数字,只要按顺序排查,绝大多数问题都能定位到具体环节并优化掉。下面按链路 → 节点 → 协议的顺序,一项一项说清楚。
一、先搞清楚:延迟究竟花在哪几段
一次通过代理IP发出的请求,耗时会分成四段:本机到网关、本机到代理节点、代理节点到目标站、以及协议握手与重传。四段里任何一段拖慢,你看到的最终延迟都会变高,但原因完全不同。
| 链路分段 | 典型耗时 | 最常见的拖慢原因 |
|---|---|---|
| 本机 → 本地网关 | 1-5ms | Wi-Fi 信号弱、网卡驱动老旧、本机防火墙拦截 |
| 本机 → 代理节点 | 10-40ms | 跨运营商绕路、出口带宽被占满 |
| 节点 → 目标站 | 20-80ms | 机房线路质量差、目标站限速、节点负载高 |
| 握手与重传 | 10-100ms | 每条请求都新建连接、丢包导致重传 |
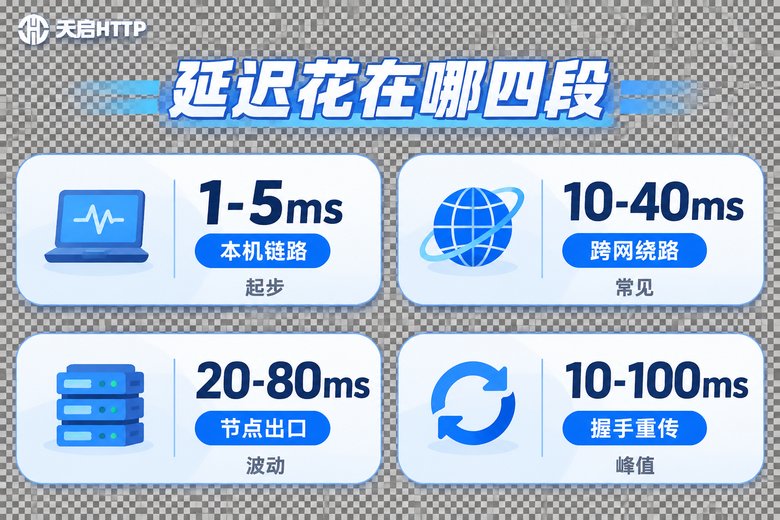
把这条链路记住,后面每一步排查都对照它看,就不会来回瞎猜。
二、链路层优化:先把自家门口的路修好
绝大多数"代理慢"的锅其实在本机。先做三件事:
1. 用有线替代 Wi-Fi。无线丢包会让 TCP 反复重传,延迟曲线会呈现剧烈的锯齿。做批量采集或多开时,网线是性价比最高的优化。
2. 检查连接是否被复用。每条请求都新建一次 TCP + 认证握手,等于每次多付几十毫秒。用连接池或长连接,把握手成本摊薄到几十条请求上,延迟立刻下降一个台阶。
3. 收敛并发。本地出口带宽和代理套餐的并发上限都是有天花板的。100 个线程同时挤 10M 带宽,每个请求的排队时间会比网络耗时还长。把并发压到合理区间,单条延迟反而更稳。
# 分段测延迟:三段分别打一次,立刻知道慢在哪
ping 你的本地网关          # 第 1 段:正常应在 1-5ms
ping 代理节点IP            # 第 2 段:正常应在 10-40ms
tracert 代理节点IP         # 看中间跳数与是否绕到外省出口
如果第 1 段就超过 10ms,问题在本地,换节点没用;如果第 2 段明显偏高而第 1 段正常,说明是运营商到机房的线路绕路了,这时才需要考虑换节点所在地区。
三、节点层优化:不是所有IP都一样快
同样是代理IP,物理位置和承载方式决定了延迟的下限。
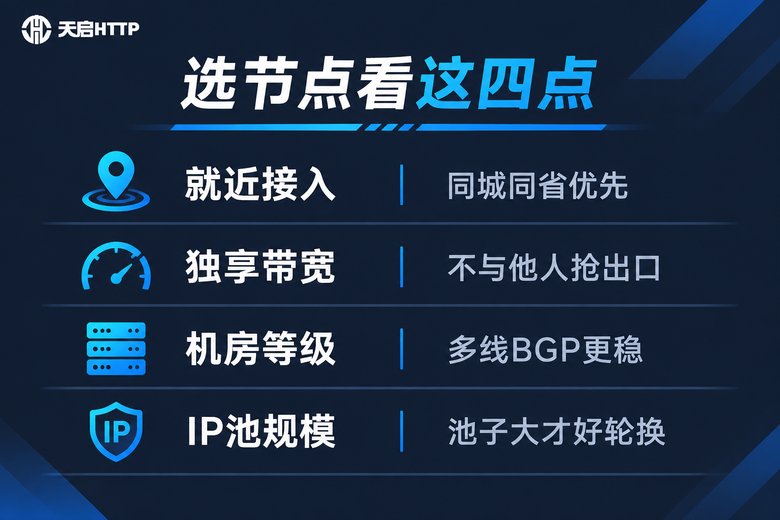
就近接入。目标站和业务数据都在国内时,优先选同城或同省的节点。跨运营商、跨大区的路由跳数一多,光传输距离带来的延迟就无法回避。做全国业务时,可以按地区分组配置节点,让每个分组走最近的出口。
独享优于共享。共享节点的出口带宽是所有用户共用的,高峰期别人跑满,你的延迟就跟着抖。需要稳定延迟的场景——比如多店铺后台操作、接口联调、定时任务——建议用独享IP,出口带宽有保障,延迟曲线更平。
看机房线路。多线 BGP 机房能自动选择更优路径,比单线机房在跨网访问时优势明显。这一点会直接体现在节点到目标站那一段的耗时上。
控制单IP请求频率。目标站对单个IP有隐性的频率限制,超过阈值后响应会变慢甚至排队。用IP池轮换,把请求摊到多个IP上,平均响应时间会明显改善。这也是IP池规模值得关注的原因。
四、协议层优化:选对方式少走弯路
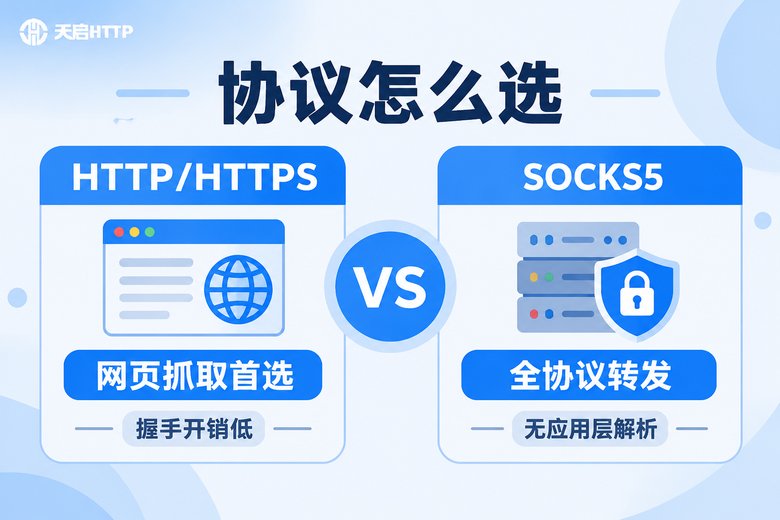
协议本身不产生多少延迟,但协议带来的握手次数和转发方式会。
| 协议 | 握手开销 | 转发能力 | 适合场景 |
|---|---|---|---|
| HTTP | 低 | 仅网页类请求 | 网页抓取、接口调用、后台批量操作 |
| HTTPS | 中(多一次加密握手) | 网页类请求,加密传输 | 需要加密通道的采集与登录场景 |
| SOCKS5 | 低(不做应用层解析) | 全协议转发 | 非网页类请求、多协议混跑、高并发 |
实践中的几条经验:
能复用的连接就别重开。无论是 HTTP 还是 SOCKS5,连接复用都能省下一次完整的握手。做高频请求时,这一项优化带来的收益往往比换节点更明显。
超时设置要短而合理。把超时设成 30 秒,一个坏节点就能拖垮整批任务。设成 3-5 秒,失败快速切到下一个IP重试,整体任务完成时间反而更短。
重试要换IP,不要死磕。同一IP连续超时说明这个出口当时不可用,重试时必须换一个IP,否则只是把等待时间乘以次数。
五、实战排查:用一个脚本定位瓶颈
不要只看平均值,平均值会被少数极慢的请求拉偏。看中位数和 P95,才能反映真实体验。
import time, requests

PROXY = "http://账号:密码@节点IP:端口"
TARGET = "http://你的目标站域名/接口"
HEADERS = {"User-Agent": "Mozilla/5.0"}

session = requests.Session()          # 复用连接,省掉重复握手
session.proxies = {"http": PROXY, "https": PROXY}

costs = []
for _ in range(30):
    t0 = time.perf_counter()
    try:
        session.get(TARGET, headers=HEADERS, timeout=5)
    except Exception:
        costs.append(5000)            # 超时记为 5 秒
        continue
    costs.append((time.perf_counter() - t0) * 1000)

costs.sort()
print(f"平均 {sum(costs)/len(costs):.0f}ms")
print(f"中位 {costs[len(costs)//2]:.0f}ms")
print(f"P95  {costs[int(len(costs)*0.95)-1]:.0f}ms")
拿到数据后按三步对比:先在同一节点测一组作基准;再换同地区另一个节点测一组,判断是不是单个IP的问题;最后把请求分组并发再测一组,判断是不是带宽或并发上限的问题。三组数据一摆,瓶颈基本就锁定了。
六、优化到极限还是慢,就该考虑换服务了
当你已经排除了本地网络、做了连接复用、换了节点和协议,延迟依然在高位抖动,那问题多半出在服务端的资源调度能力上:出口带宽被超卖、节点负载过高、IP 池周转不过来,这些都不是客户端能优化的。
天启HTTP 提供国内多地区的代理IP服务,节点覆盖多个城市与运营商线路,支持 HTTP/HTTPS/SOCKS5 三种协议接入,可按业务需要选择独享IP,出口带宽不与他人争抢。对于多店铺后台操作、数据采集、接口联调这类对延迟稳定性要求较高的场景,独享IP配合就近节点,通常能把响应时间压到比较理想的范围,延迟曲线也更平稳。需要说明的是,天启HTTP 只提供国内代理IP,不适用于需要境外IP的场景。
常见问题
Q:换了节点延迟还是没降,是代理的问题吗?
先做分段测试。如果本机到网关就已经超过 10ms,或者本地出口带宽跑满,换多少节点都没用。只有当"本机→节点"这一段明显偏高,才说明是线路问题。
Q:为什么平均值看起来还行,实际用起来却卡?
平均值会被少量极慢请求拉平。真正影响体验的是 P95 和抖动幅度,建议同时观察中位数与 P95,两者差距大说明链路不稳定。
Q:HTTP 和 SOCKS5 到底该选哪个?
只做网页请求和接口调用,HTTP/HTTPS 就够用;如果还要跑非网页协议或者高并发混跑,SOCKS5 更省心,转发效率也更高。
Q:IP 轮换太频繁会不会反而更慢?
会。每换一个IP都可能触发新的握手和认证,轮换频率应该匹配目标站的风控强度,不要盲目追求"每个请求换一个IP"。
Q:独享IP和共享IP的延迟差在哪?
主要差在稳定性。共享IP在业务高峰期容易因他人占满出口而抖动,独享IP的带宽是专属的,延迟曲线更平,做长时间任务时优势明显。
Q:延迟优化到什么水平算正常?
国内同城节点访问国内目标站,整体响应在几十毫秒到一百多毫秒之间属于正常范围。如果你的业务对时间极敏感,可以把中位数和 P95 同时压进目标区间,而不是只盯着单次最快值。