先搞清楚:稳定不等于"能连上"
很多人测代理IP,方法就一句话:拿一个IP去请求一下网站,通了,就认为"这个代理是稳的"。这种测法的问题在于——它只测到了一个瞬间,而稳定性是一个时间维度的概念。
一个IP可能是这样的:上午10点用着很好,11点开始频繁超时,下午又恢复正常。如果你只在上午10点测过一次,你会觉得它100%稳定;如果你只在11点测过一次,你会觉得它完全不能用。两个结论都是错的。
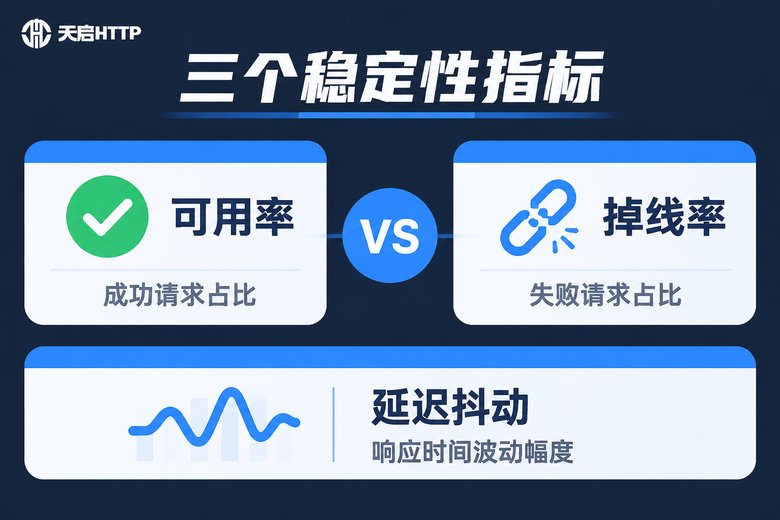
所以2026年再看代理IP稳定性,判断标准已经变成了三件事:能不能连(可用率)、连上之后会不会断(掉线率)、断了之后恢复快不快(延迟抖动)。这三个指标要一起看,缺一个都会做出误判。
三个核心指标:可用率、掉线率、延迟抖动
先把概念摆清楚,后面的测试方法才有意义。
可用率:在统计周期内,成功拿到有效响应的请求数占总请求数的比例。注意"有效响应"四个字——返回了502、返回了验证码页面、返回了一个空白页,严格来说都不算有效。只看HTTP状态码是200就判定成功,是常见的自欺欺人。
掉线率:这个指标在短连接场景里不太明显,但在长连接、隧道代理、需要保持会话的场景里非常关键。它衡量的是"已经建立的连接,在预期时间内被意外中断的比例"。掉线率高的代理,用来做需要连续操作的业务会非常痛苦,因为你要不断重连、重新走一遍流程。
延迟抖动:平均值看起来很美,但实际情况是大部分请求很快、一小部分请求奇慢。这种"平均值陷阱"会让你误判。真正要看的是P95和P99——把100次请求的耗时排序,第95个和第99个是多少毫秒。P95如果比平均值高出好几倍,说明这个代理的网络路径不稳定。
掉线率到底怎么算才靠谱
掉线率没有统一标准,但计算逻辑必须固定,否则不同批次的测试结果没法对比。下面这个算法可以直接用:
掉线率 = 异常中断次数 ÷ 有效连接总时长(或总请求次数)× 100%
关键在于"异常中断"的判定规则要提前定死。建议把以下几种情况全部计入异常:连接超时、连接被重置、返回状态码为5xx、返回内容与预期不符(比如被拦截页面)、响应耗时超过设定阈值(比如10秒)。
然后按时间段拆开看。一个健康的代理,掉线率在不同时段应该是平缓的;如果一个代理白天掉线率2%、晚上掉线率20%,那它大概率是共享池里的资源,高峰时段被别人占满了。这种"波峰型掉线"比"均匀型掉线"更危险,因为你永远不知道业务跑到一半会不会撞上高峰。
| 指标 | 计算方式 | 参考区间 | 说明 |
|---|---|---|---|
| 可用率 | 成功有效请求 ÷ 总请求 | ≥ 99% | 低于95%基本不适合长期业务 |
| 掉线率 | 异常中断次数 ÷ 总连接数 | ≤ 1% | 长连接业务要求更严 |
| 平均延迟 | 所有成功请求耗时均值 | 视目标站点而定 | 单看均值容易误判 |
| P95延迟 | 耗时排序后第95百分位 | ≤ 平均值的2倍 | 反映最差的那批请求 |
四种实测方法,按你的场景选
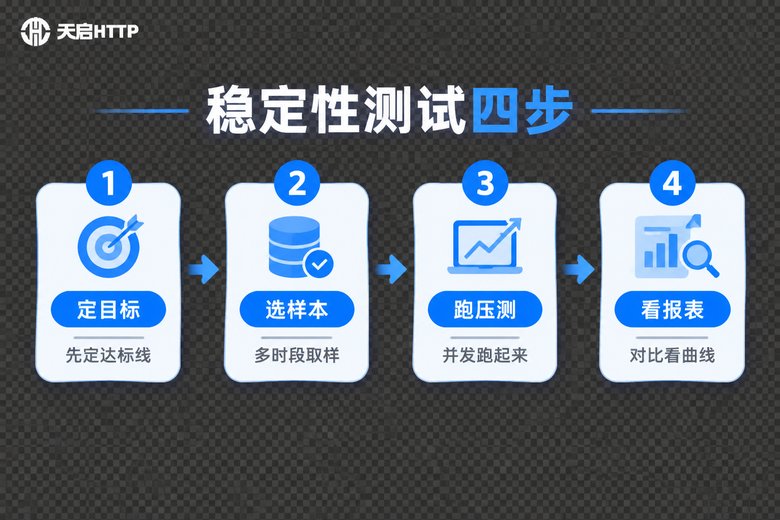
方法一:短连接压测。用固定并发,连续发几百次请求,统计成功率和耗时分布。适合采集类业务,验证的是"单次请求能不能稳定拿到数据"。建议并发从5开始,逐步加到20,观察成功率是否随并发下降——如果一下降,说明这个代理的并发承载能力不行。
方法二:长连接保活测试。建立连接后,每隔30秒发一个心跳请求,连续跑2小时以上,记录中断次数。适合需要维持会话的场景。这个测试最容易暴露问题,很多"看起来能用"的代理在这个环节会大面积中断。
方法三:分时段采样。不要在一次测试里下结论。选择早、中、晚三个时段各跑一轮,每轮20分钟,把结果画成曲线。这个方法能帮你看清代理的真实水位,也是判断对方是不是在超卖资源的有效手段。
方法四:多目标任务验证。拿2到3个不同域名、不同响应速度的目标站做交叉测试。如果只有某一个站点失败率高,问题可能出在目标站;如果全部失败率高,问题才出在代理。很多"代理不稳"的锅其实是目标站限流。
一套可以直接跑的监测脚本
下面这段代码做的是最基础也最实用的事:发200次请求,算出可用率、掉线率、平均耗时和P95耗时。改一下代理地址和目标地址就能用。
import time
import requests
from concurrent.futures import ThreadPoolExecutor

PROXY = "http://账号:密码@代理地址:端口"
CHECK_URL = "https://www.baidu.com"
TOTAL = 200
TIMEOUT = 6
PROXIES = {"http": PROXY, "https": PROXY}

def once(_):
    t0 = time.time()
    try:
        r = requests.get(CHECK_URL, proxies=PROXIES, timeout=TIMEOUT)
        return (time.time() - t0, r.status_code == 200)
    except Exception:
        return (TIMEOUT, False)

with ThreadPoolExecutor(max_workers=10) as pool:
    result = list(pool.map(once, range(TOTAL)))

cost = [c for c, ok in result]
ok_cnt = sum(1 for _, ok in result if ok)
cost.sort()

print("可用率: %.2f%%" % (ok_cnt / TOTAL * 100))
print("掉线率: %.2f%%" % ((TOTAL - ok_cnt) / TOTAL * 100))
print("平均耗时: %.2fs" % (sum(cost) / len(cost)))
print("P95耗时: %.2fs" % cost[int(len(cost) * 0.95) - 1])
跑完之后,别只看四个数字,重点看P95和平均值的差距。如果平均耗时0.8秒、P95耗时4.5秒,说明有5%的请求在拖后腿,这种代理用在自动化流程里会非常难受,因为你的程序会被那5%的慢请求卡住。
监控怎么做:从"测一次"到"一直测"
测试解决的是"当下好不好",监控解决的是"以后会不会变差"。真正的稳定性保障,靠的是持续监控,而不是一次性验货。
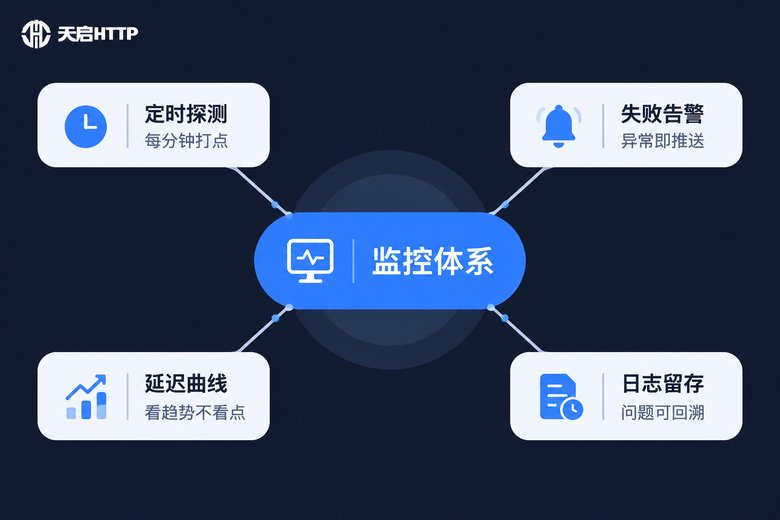
定时探测:用一台常驻机器或云函数,每1到5分钟对代理做一次探测,记录成功与否、耗时、返回码。数据落到一个简单的表里就行,不需要多复杂。
失败告警:连续3次探测失败就触发提醒,而不是等失败率涨到20%才发现。连续失败比偶发失败更有信号价值,因为偶发失败往往只是网络抖动。
延迟曲线:把每天的P95耗时画成折线,看趋势不看单点。曲线缓慢上扬通常意味着代理节点负载在增加,这是可以提前处理的问题。
日志留存:把失败请求的时间、目标、返回码存下来。出问题时能回溯,才能区分是代理的锅、目标站的锅,还是自己代码的锅。
挑代理服务时,稳定性该怎么验
说完方法,说选择。稳定性这个东西,不是看宣传语,而是看能不能被你测出来、能不能被你长期盯住。
在这一点上,天启HTTP的做法比较适合做稳定性验证:提供国内各城市的代理IP资源,支持HTTP代理和隧道代理,IP通过API接口提取,接入方式简单;隧道代理可以保持连接持续可用,减少频繁更换IP带来的中断;同时提供独享IP选项,避免和他人共享资源导致的时好时坏。对于需要长时间跑任务的业务来说,"资源不与他人混用"本身就是稳定性的一部分。
建议的验证方式是:先用小批量做24小时分时段测试,拿到自己的可用率、掉线率、P95数据;数据达标后再放大使用量。不要一上来就全量切换,也不要只测十分钟就下结论。
常见问题
Q:测了100次只失败2次,可用率98%,算稳定吗?
要看失败的性质。如果2次失败是分散在不同时间点的偶发抖动,一般可以接受;如果2次失败是连续发生的,说明存在规律性中断,这种"集中型失败"对业务影响远大于分散失败,建议延长测试时间再判断。
Q:为什么我测出来的可用率很高,实际用起来还是老断?
大概率是测试方法和实际用法不匹配。短连接测出来很好,但你的业务用的是长连接,掉线率根本没被测到。测试场景要尽量贴近真实业务,这一点比测试次数重要得多。
Q:延迟多少算正常?
没有绝对标准,取决于目标站点。国内目标站,代理延迟在几十毫秒到一两百毫秒都属常见范围。比数值更值得关注的是波动:如果同一个代理的延迟在80毫秒到2000毫秒之间来回跳,那就是不稳定的信号。
Q:需要几个IP同时测才准?
测单个IP只能反映个体情况,测一批IP才能反映服务整体水平。建议至少取10个IP,分别跑一轮,然后看整体的可用率分布,而不是只看某一个IP的表现。
Q:监控频率设多少合适?
一般业务1到5分钟一次足够。频率太高会产生大量无效请求,也可能被目标站点限流,反而制造出"假掉线"。关键业务的探测频率可以提高到1分钟,但要注意单IP的请求总量控制。
Q:代理IP稳定性和IP更换频率有关系吗?
有关系。频繁更换IP意味着连接需要不断重建,重建过程中出现失败的概率会上升。如果业务允许,优先选择能保持连接持续的隧道代理,或者使用独享IP减少更换次数,稳定性通常会更可控。