为什么"感觉快"不能当结论
很多人在挑代理IP时,习惯打开网页刷两下,觉得"还行""有点卡",就下了判断。这种体感式评估的问题在于:同一个代理,早上用可能很顺,晚上用可能卡到怀疑人生;同一个代理,访问A站很快,访问B站可能慢好几倍。
体感会被三件事同时干扰:本地网络状况、目标网站当时的负载、代理节点当时的排队情况。三者叠在一起,你根本分不清到底是谁慢。想要拿到可比较、可复现、能用来做决策的数字,就必须把"快"拆成两把可测量的尺子——延迟和吞吐。
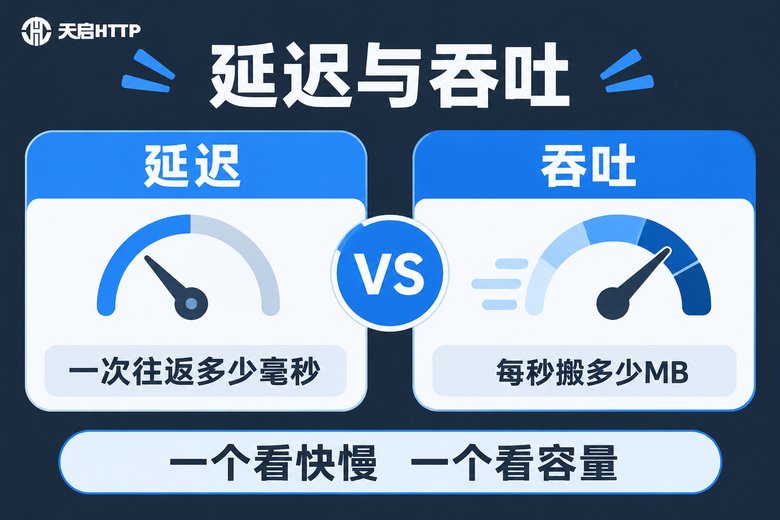
两把尺子:延迟管跟手,吞吐管容量
把代理想象成一个中转站:你的请求先送到中转站,中转站再帮你把货物送到目的地,取到回执后再运回来。
延迟衡量的是"跑一趟要多久",单位是毫秒(ms)。它决定了你点击之后等多久才有反应,属于跟手性指标。做登录、注册、提交表单、抓取单页这类"请求多、数据小"的事,延迟的影响最大。
吞吐衡量的是"单位时间能搬多少货",单位通常是 MB/s 或 Mbps。它决定了你下载图片、视频、大文件、批量并发采集时的速度上限,属于容量指标。
这两个数字完全可能背道而驰:一条线路延迟只有 30ms,但带宽被挤爆,下载只有 200KB/s;另一条线路延迟 150ms,却能稳定跑到 8MB/s。所以只测其中一个,结论一定是片面的。
| 对比项 | 延迟(Latency) | 吞吐(Throughput) |
|---|---|---|
| 测的是什么 | 一次请求往返所需时间 | 单位时间内传输的数据量 |
| 常用单位 | 毫秒 ms | MB/s 或 Mbps |
| 影响什么业务 | 登录、注册、下单、单页抓取、验证码提交 | 图片/视频下载、批量采集、大文件传输 |
| 怎么测 | 多次请求取中位数与P95 | 下载固定大小文件,换算每秒速度 |
| 被什么拖累 | 节点距离、路由绕路、握手次数 | 代理出口带宽、并发数、目标站限速 |
第一步:把延迟测准,别只 ping 一个包
很多人测延迟就是 ping 一下代理的入口地址。这个数字只能说明"你的电脑到代理服务器门口"有多远,并不等于你访问目标网站的真实耗时。真正有意义的是完整链路:你 → 代理 → 目标站 → 代理 → 你。
推荐用 curl 一次性把几个关键节点的时间点打出来:
curl -o /dev/null -s \
  -x http://用户名:密码@代理地址:端口 \
  -w "连接=%{time_connect}s 首字节=%{time_starttransfer}s 总计=%{time_total}s\n" \
  https://你的目标站点/
其中 time_connect 反映的是握手排队情况,time_starttransfer(首字节时间)才是用户真正的"感觉到有反应"的那一刻,time_total 是完整拿到页面的总耗时。
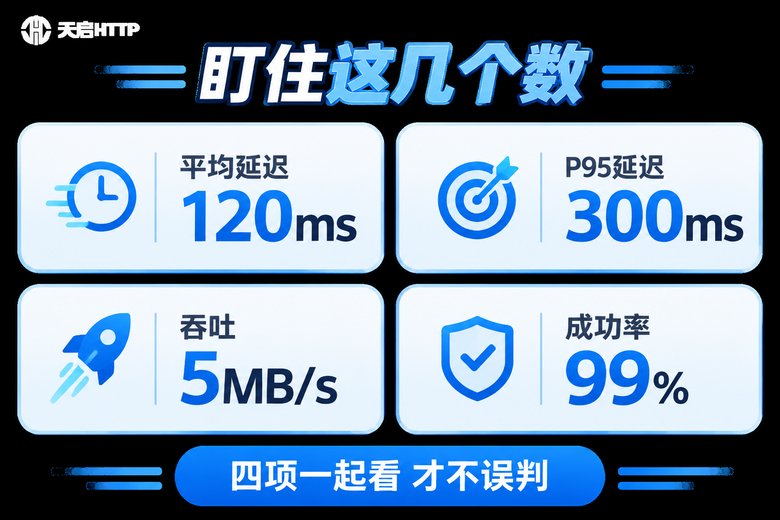
关键动作是多轮取样。单次结果毫无参考价值,至少要跑 20 次,然后看两个数:中位数(反映常态水平)和 P95(反映最差的那 5% 有多差)。一个代理中位数 90ms、P95 却高达 900ms,说明它抖得厉害,做批量任务时会频繁超时。
import time, statistics, requests

proxy = "http://用户名:密码@代理地址:端口"
proxies = {"http": proxy, "https": proxy}
url = "https://你的目标站点/"
costs = []

for i in range(20):
    t0 = time.time()
    try:
        requests.get(url, proxies=proxies, timeout=15)
        costs.append((time.time() - t0) * 1000)
    except Exception:
        pass
    time.sleep(0.5)

costs.sort()
print("成功次数:", len(costs), "/ 20")
print("中位延迟:", round(statistics.median(costs), 1), "ms")
print("P95延迟:", round(costs[int(len(costs) * 0.95) - 1], 1), "ms")
第二步:把吞吐测实,用大文件而不是首页
测吞吐最常见的错误,是拿一个几 KB 的网页去算速度。数据量太小,测出来的其实是延迟的倒数,跟带宽没什么关系。正确做法是下载一个 5MB 到 20MB 的固定文件,用总字节数除以总耗时。
import time, requests

proxy = "http://用户名:密码@代理地址:端口"
proxies = {"http": proxy, "https": proxy}

t0 = time.time()
size = 0
r = requests.get("https://你的目标站点/10mb.bin",
                 proxies=proxies, stream=True, timeout=60)
for chunk in r.iter_content(65536):
    size += len(chunk)
seconds = time.time() - t0

print("下载字节:", size)
print("耗时:", round(seconds, 2), "秒")
print("吞吐:", round(size / 1024 / 1024 / seconds, 2), "MB/s")还有一点容易被忽略:单线程吞吐不等于并发吞吐。实际业务里你往往要同时抓几十个页面,所以还要测"10 路并发跑一轮,总耗时多少、成功率多少"。有些代理单线程很漂亮,一上并发就集体排队,成功率掉到七八成,这种线路在批量场景里是不能用的。
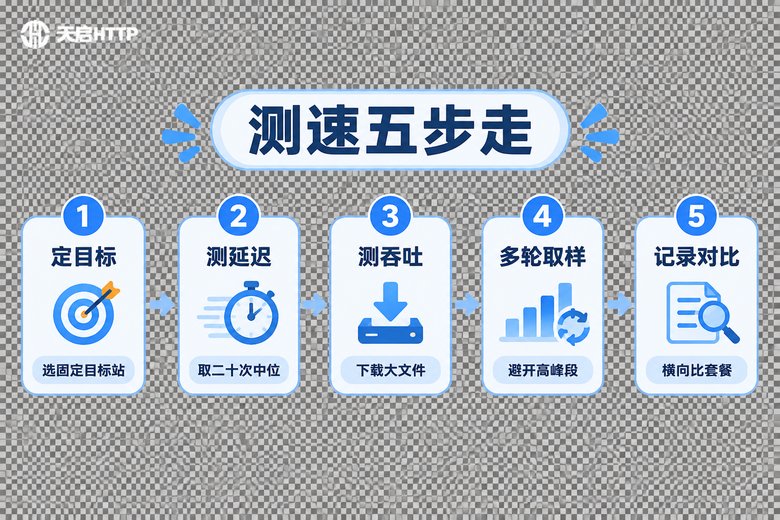
第三步:避开这几个让数据失真的坑
坑一:目标站换了。今天测 A 站、明天测 B 站,两次结果没有可比性。测速必须锁定同一个目标地址。
坑二:本地带宽先跑满了。如果你的宽带本身只有 50Mbps,代理再好也测不过 6MB/s 左右。测之前先确认本地直连的吞吐基线是多少。
坑三:时段混着比。晚高峰和凌晨的结果能差一倍。要比较两个代理,就放在同一时段、交替跑。
坑四:只看平均,不看分布。平均值会把一堆超时掩盖掉。中位数、P95、成功率三个一起看,才是一张完整的体检报告。
坑五:忽略目标站自己的限速。有些站点对高频访问本来就会主动降速,这时候你换十条线路都没用,问题不在代理。
一套可以直接照抄的测速结论模板
把上面几步跑完,你会得到一张这样的表。选代理时,不要只挑单个数字最漂亮的,而要看四项是否均衡:延迟中位数低、P95不夸张、吞吐稳定、成功率高。四项里有一项明显掉队,就说明这条线路在你的业务场景里会出问题。
| 观察项 | 为什么重要 | 掉队后的表现 |
|---|---|---|
| 延迟中位数 | 代表常态响应水平 | 每一步操作都慢半拍,效率整体下滑 |
| P95延迟 | 代表最差情况的上限 | 偶尔卡死,批量任务频繁超时重试 |
| 吞吐(单线程+并发) | 决定大数据量任务的天花板 | 图片视频拉不动,采集周期被拉长数倍 |
| 成功率 | 决定任务能不能跑完 | 重试成本高于收益,稳定性崩盘 |
如果测出来延迟低但吞吐上不去,通常说明这条线路被并发挤占,需要换成独享性质的通道;如果吞吐正常但延迟抖动大,多半是节点路由绕远或者共享池里人太多。针对这类问题,天启HTTP 提供短效优质代理、独享代理和隧道代理等不同类型的产品,支持 HTTP、HTTPS、SOCKS5 协议,覆盖国内多个城市节点,并提供 API 提取方式,方便你把不同线路放进同一套测速脚本里横向对比,用数据来决定用哪一条。
常见问题
Q:测代理速度,用 ping 够不够?
不够。ping 只测到你到代理入口这一段,测不到代理到目标网站的那一段。真正该看的是完整链路的首字节时间和总耗时,所以用 curl 或脚本发真实请求更靠谱。
Q:延迟多少毫秒才算快?
没有绝对标准,要看你访问的目标站在哪个地区、你的本地网络是什么水平。靠谱的做法是拿"本地直连同一目标站"的结果做基线,代理的延迟比基线高出不多、P95 不夸张,就是不错的水平。
Q:为什么同一条代理,白天和晚上测出来差很多?
共享性质的线路在高峰时段会被更多用户同时占用,排队变长,延迟和吞吐都会变差。建议固定在同一时段做对比测试,并把不同时段的数据都记录下来,看它的波动范围。
Q:吞吐测出来只有几百 KB/s,一定是代理的问题吗?
不一定。先确认三件事:本地宽带直连能跑到多少、目标站有没有对高频访问限速、你的测试文件是不是太小。这三项排除之后,才轮到怀疑代理出口带宽。
Q:延迟和吞吐,做业务时应该优先看哪个?
看你的任务类型。登录、注册、提交表单、单页抓取这类请求多但数据小的场景,优先看延迟;图片、视频、大文件、批量采集这类数据量大的场景,优先看吞吐。最稳妥的是两个都测,四项指标一起评估。
Q:测速脚本里的用户名密码怎么填?
用你在服务商后台获取的代理地址、端口、账号和密码,按 http://账号:密码@地址:端口 的格式拼接即可。天启HTTP 的隧道代理和 API 提取方式都可以直接把返回结果填进脚本,方便批量做多轮取样。