先分清两个概念:节点数量和并发上限
很多人一上来就问"爬虫代理要买多少个IP",其实这里藏着两个不同的问题。
节点数量指的是你手里可用的IP总量,也就是IP池子有多大。并发上限指的是同一时刻最多能同时发出多少个请求。前者决定你能"换多少张脸",后者决定你"一次能喊多大声"。
两者是互相制约的:节点太少但并发开很高,同一个IP短时间内被反复使用,很快就会被目标站点盯上;节点很多但并发压得很低,钱花了却跑不满速度。所以正确顺序是——先按采集规模定节点数,再按目标站点的容忍度定并发,最后回头校验两者是否匹配。
第一步:按采集规模确定节点数量
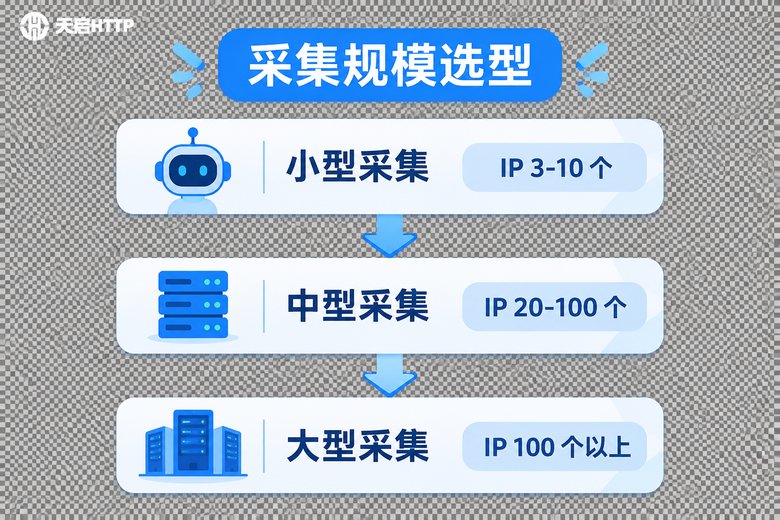
采集规模最好用"日请求量"来衡量,而不是"网站数量"。下面这张表可以直接作为起步参考值,实际使用时再根据目标站点的严格程度上下浮动。
| 采集规模 | 日请求量 | 建议IP节点数 | 建议并发上限 | 典型场景 |
|---|---|---|---|---|
| 小型 | 1万以内 | 3 ~ 10 个 | 5 ~ 20 | 单一站点价格监控、文章定时抓取 |
| 中型 | 1万 ~ 50万 | 20 ~ 100 个 | 50 ~ 200 | 多站点商品库、评论与列表采集 |
| 大型 | 50万以上 | 100 ~ 500 个 | 200 ~ 1000(按站点拆分) | 全站类目采集、比价系统、长期监测 |
这里有个常见的误区:节点不是越多越好。节点数量翻倍,意味着你需要处理更多的IP失效、更多的调度逻辑和更高的成本。真正该关注的指标是"有效IP的轮换频率",而不是单纯的数字大小。
第二步:用响应时间反推并发上限
并发上限不能凭感觉拍,它和两个东西强相关:目标站点能容忍的请求频率,以及你单次请求的响应时间。
换算关系其实很简单:
每秒请求数(QPS) = 并发数 ÷ 平均响应时间(秒)
反过来:并发数 = 目标 QPS × 平均响应时间
举个例子:某个站点你能接受的上限是每秒 5 个请求,实测平均响应时间是 0.3 秒,那么并发数大约是 5 × 0.3 = 1.5,取整用 2 就够。这时候开 50 个并发不但没有收益,反而会瞬间把站点惹毛。
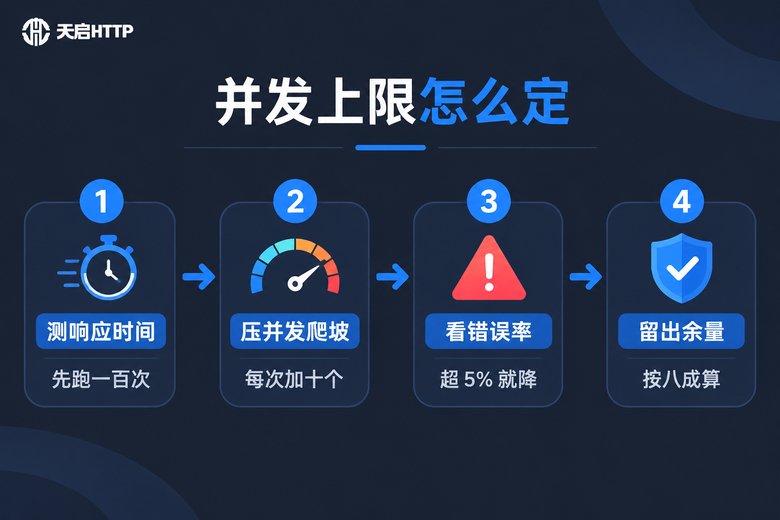
响应时间越长,同样的QPS需要的并发就越高——这也是为什么慢站点反而更吃并发。实操中建议按下面四步走:
1. 先小流量跑一百次,记录平均响应时间和失败率;2. 逐步加压,每次增加 10 个并发,观察成功率变化;3. 找到拐点,当错误率超过 5%(比如返回 403、429 或验证页)就说明到顶了;4. 打八折使用,把测出来的值乘 0.8 作为日常并发,给突发留余量。
第三步:让节点数和并发配平
定完两个数字后,还要检查一件事:每个IP的请求频率是否合理。
一个比较稳妥的经验值是,单个IP每秒承受 1 ~ 2 个请求。如果你有 20 个节点、并发开到 60,那就相当于平均每个IP每秒要扛 3 个请求,超额了,结局通常是被批量封禁。
简单公式:并发上限 ≈ 节点数 × 单IP每秒可承受请求数。想提高并发,要么加节点,要么降低单IP的频率,没有第三条路。
以下几个工程细节同样会影响配平效果:
• 失败重试要换IP:同一个IP连续失败两次就应该剔除,而不是原地重试三次;
• 做好请求去重:重复抓同一个URL是最没必要的浪费,等于白烧代理流量;
• 队列分层:把不同站点拆成不同队列,各自独立控制并发,避免一个难啃的站点拖垮全局;
• 优先用隧道/转发模式:由服务端自动轮换IP,比自己在代码里管理IP池省事得多。
第四步:选型时看这五个指标
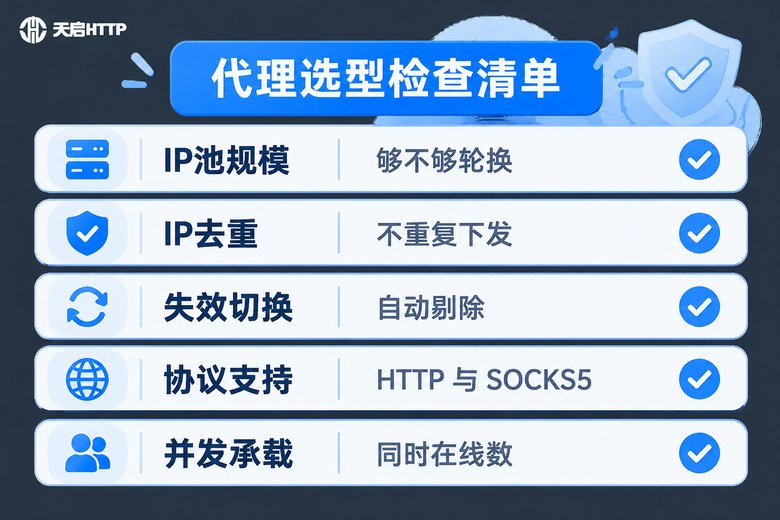
搞清楚数量之后,才是挑服务商。爬虫场景建议重点看这几点:
IP池规模与时效——短效IP适合高频轮换的列表页采集,长效IP适合需要保持会话的场景;
去重能力——池子再大,如果反复下发同一批IP,效果等于没有;
失效自动切换——爬虫最怕的不是封,是"卡在死IP上不动";
协议支持——至少覆盖 HTTP、HTTPS,需要抓App或特殊协议时还得有 SOCKS5;
并发承载与提取方式——API提取适合自建调度,隧道代理适合不想写IP池管理逻辑的团队。
天启HTTP在爬虫场景里怎么用
天启HTTP 提供的是国内IP代理服务,覆盖短效优质代理、隧道代理、独享IP以及API提取等多种接入方式,支持 HTTP、HTTPS、SOCKS5 协议,比较适合采集国内站点的业务。
对应的用法大致是这样:
• 小型采集:直接用API提取模式,按需拉取少量IP,代码里做个简单的失败剔除逻辑就能跑起来;
• 中型采集:换成隧道代理,把IP轮换交给服务端,自己只关心队列和解析,能省掉一大半调度代码;
• 大型采集:独享IP + 隧道组合使用,把对稳定性要求高的站点交给独享IP,量大的列表页交给隧道动态轮换,再按站点拆分并发。
下面是API提取方式的一个最小示例,把提取链接换成你在天启HTTP后台拿到的地址即可:
import requests

API = "https://你的天启HTTP提取链接/?num=20&format=json"

def fetch_ips():
    resp = requests.get(API, timeout=5)
    return resp.json().get("data", [])

def get_proxy():
    ips = fetch_ips()
    if not ips:
        return None
    ip, port = ips[0].split(":")
    return {"http": f"http://{ip}:{port}", "https": f"http://{ip}:{port}"}
需要提醒的是,代理只是解决方案的一半。真正决定采集稳不稳的,还是前面那套"节点数 × 单IP频率 = 并发"的配平逻辑,以及失败就换、不硬刚的调度策略。
常见问题
Q:小型采集真的只需要几个IP吗?
是的。日请求量在一万以内、目标站点也不严格的情况下,3到10个IP配合合理的请求间隔就够用。盲目加节点只会增加调度负担和成本。
Q:并发开到很大,为什么速度反而变慢了?
大概率是被目标站点限速或返回验证页了。此时真实成功率下降,大量请求在做无效重试,看起来并发很高,实际有效吞吐反而更低。建议回到"逐步加压、看错误率拐点"的方法重新测一遍。
Q:节点数和并发数哪个先定?
先定节点数。节点数由采集规模和预算决定,并发则由目标站点的容忍度反推,最后用"并发 ≈ 节点数 × 单IP每秒请求数"做一次校验。
Q:短效IP和隧道代理怎么选?
如果你的代码里已经有成熟的IP池管理逻辑,短效IP更灵活;如果不想维护IP池、只想把轮换交给服务端,隧道代理更省事。两者也可以同时用在不同队列上。
Q:采集国外站点可以用吗?
天启HTTP 提供的是国内IP资源,适合采集国内站点。如果你的业务面向境外站点,需要另外评估线路条件。
Q:怎么判断代理质量好不好?
别看宣传数字,自己跑一轮:固定并发压十分钟,统计成功率、平均延迟和IP重复率。成功率稳定在较高水平、延迟波动小的,才是能长期用的。