做数据采集的人大多有过这样的经历:脚本写好了,跑起来十分钟就被目标站点拦得死死的,换IP换到手软,日志里全是 403 和超时。问题往往不在代码本身,而在代理的三项配置——调度、去重、限速没配明白。这三件事配好了,同样的代理资源能跑出两三倍的效率;配不好,买再多的IP也是白搭。
下面把这三块拆开来讲,每块都给到可直接照着改的配置思路。
一、调度:让每个代理IP都待在合适的位置上
调度解决的是"这次请求该由哪个IP发出去"的问题。很多人的做法是拿到IP列表后随机取一个,简单粗暴,但会带来两个麻烦:好的IP被过度使用提前报废,差的IP反复拖慢整体速度。
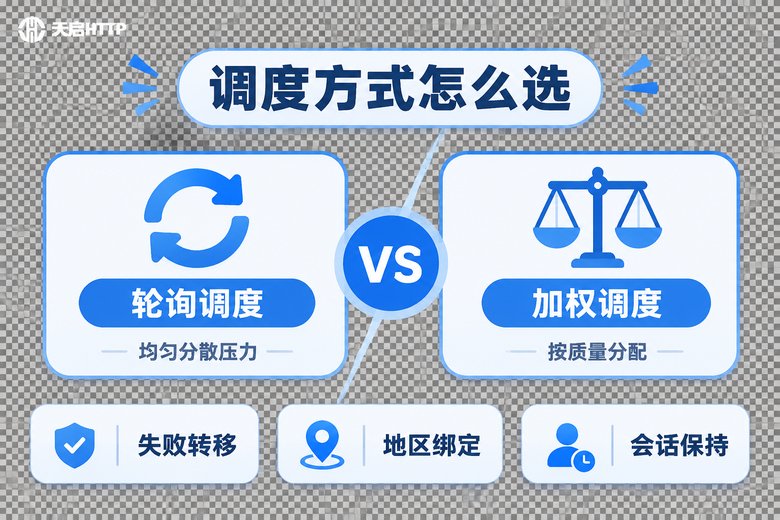
常见有三种调度思路,适用场景不一样:
| 调度方式 | 分配逻辑 | 适合的场景 | 注意点 |
|---|---|---|---|
| 轮询调度 | 按顺序轮流使用每个IP | 目标站点风控较松、任务量均匀 | 坏IP也会被均匀地"轮到",需要配合失败剔除 |
| 加权调度 | 根据IP的历史成功率、响应速度分配权重 | 任务量大、对成功率要求高 | 要记录每个IP的成功率和平均耗时 |
| 绑定调度 | 按目标站点或地区固定使用某组IP | 需要登录态、需要指定城市数据 | 记得给绑定组留备用IP |
实操上比较稳妥的做法是"加权 + 失败转移":给每个IP维护一个分数,请求成功加分、失败扣分,分数低于阈值就自动下线冷却几分钟再拉回来。同时设置一条铁律——同一个IP连续失败 3 次,立刻从可用池里摘掉,不要等它自己恢复。
如果采集量不大,直接用天启HTTP的隧道代理模式会更省事:客户端只连一个固定入口,出口IP由服务端自动轮换,你不需要自己维护IP列表和存活检测,调度逻辑从"管理一堆IP"简化成"配置一个入口"。任务量大、需要精细控制的场景,则用API提取方式自己拿IP列表做加权调度更灵活。
二、去重:三层过滤,砍掉大部分无效请求
去重不只是"别重复抓同一个链接",它其实分三层。很多采集任务的浪费,就发生在第二层和第三层没做。
第一层:URL 去重。把即将请求的链接做一次规范化(去掉多余的参数、统一大小写、补全相对路径),然后放进一个集合里判重。量小用内存里的 set,量大用 Redis 的集合结构,几百万条也不吃力。
第二层:内容指纹去重。不少站点的详情页会用不同的URL指向同一份内容,比如带不同来源参数的分享链接。这时候对页面正文做一次哈希(提取正文后算 MD5 或 SimHash),指纹相同就判定为同一份数据,直接跳过。这一层能过滤掉相当比例的重复页。
第三层:代理IP去重与冷却。这一层常被忽略。如果同一个IP在短时间内被反复派去访问同一个站点,触发风控的概率会明显上升。正确做法是给每个IP和目标域名维护一个"最近使用时间",同一个IP访问同一个站点要间隔一段时间,失败过的IP进冷却队列,隔几分钟再放出来。
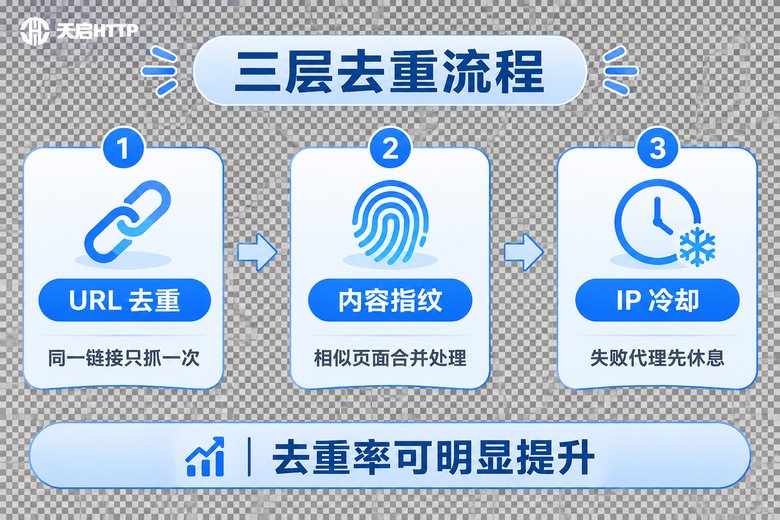
三层叠加之后,实际发出的请求数通常会明显下降,成功率反而上升——因为省下来的请求预算可以用在真正需要抓的页面上,代理IP的压力也小了。
三、限速:把并发和间隔调到一个"舒服"的值
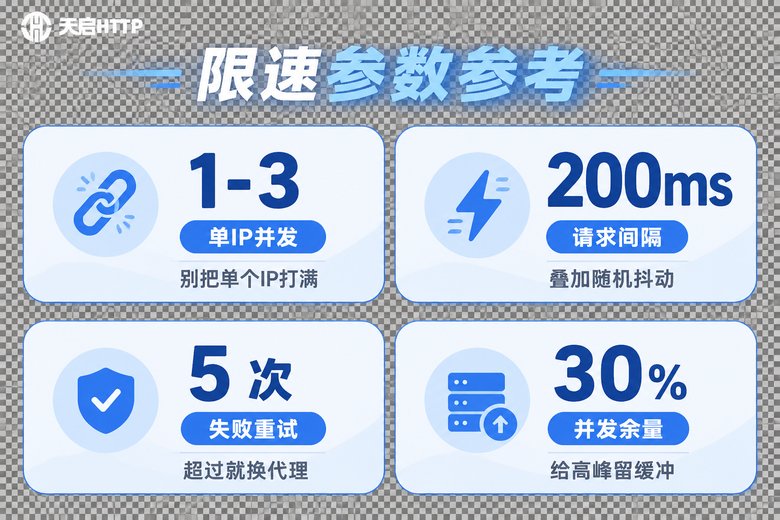
限速不是越慢越安全,也不是越快越好,而是找到目标站点能接受、你的代理池也扛得住的平衡点。核心是四个参数:
- 单IP并发数:一个IP同时发几个请求。一般控制在 1-3 个,超过之后成功率会明显下滑。
- 请求间隔:两次请求之间的等待时间。固定间隔反而容易被识别出规律,建议在基础值上叠加随机抖动,比如 200ms 加上 0-300ms 的随机值。
- 失败重试次数:同一个任务重试超过 3-5 次就该换IP,而不是死磕。
- 整体并发余量:全局并发不要顶到代理池上限,留出 20%-30% 的余量给突发任务和重试。
还有一个容易被忽视的点:要按目标域名分别限速。你的采集任务可能同时打十几个站点,每个站点的承受能力完全不同。用一个全局QPS去控所有域名,结果往往是宽松的站点跑不满、严格的站点被打爆。给每个域名建一个独立的限速器,是最省心的做法。
四、一份可直接落地的配置骨架
把上面三块拼起来,代码结构大致如下(Python 示例,核心是思路,语言可以换):
import time, random, hashlib, requests
from collections import defaultdict, deque

PROXY_API = "你的天启HTTP API提取链接"

# ---------- 1. 代理池:带分数的调度 ----------
proxy_score = defaultdict(lambda: 100)   # 初始分 100
cooldown_until = {}                      # IP -> 冷却结束时间

def pick_proxy():
    now = time.time()
    alive = [ip for ip in proxy_score
             if cooldown_until.get(ip, 0) < now]
    # 按分数加权,分高的更容易被选中
    alive.sort(key=lambda ip: proxy_score[ip], reverse=True)
    return random.choice(alive[:max(1, len(alive) // 2)])

def report(ip, ok):
    if ok:
        proxy_score[ip] = min(120, proxy_score[ip] + 2)
    else:
        proxy_score[ip] -= 20
        if proxy_score[ip] < 40:
            cooldown_until[ip] = time.time() + 180   # 冷却3分钟
            proxy_score[ip] = 60                     # 恢复后给个中间分

# ---------- 2. 去重:URL + 内容指纹 ----------
seen_url, seen_hash = set(), set()

def fingerprint(text):
    return hashlib.md5(text.strip().encode("utf-8")).hexdigest()

def is_duplicate(url, html):
    if url in seen_url:
        return True
    seen_url.add(url)
    fp = fingerprint(html[:2000])          # 取正文前段做指纹
    if fp in seen_hash:
        return True
    seen_hash.add(fp)
    return False

# ---------- 3. 限速:按域名独立控速 ----------
DOMAIN_QPS = {"default": 5}            # 每秒请求数上限
last_hit = defaultdict(float)

def wait_for_slot(domain):
    qps = DOMAIN_QPS.get(domain, DOMAIN_QPS["default"])
    gap = 1.0 / qps + random.uniform(0, 0.3)   # 基础间隔 + 随机抖动
    elapsed = time.time() - last_hit[domain]
    if elapsed < gap:
        time.sleep(gap - elapsed)
    last_hit[domain] = time.time()

# ---------- 主循环 ----------
def fetch(url, domain):
    for attempt in range(5):
        ip = pick_proxy()
        wait_for_slot(domain)
        try:
            r = requests.get(url, proxies={"http": ip, "https": ip}, timeout=10)
            if r.status_code == 200:
                report(ip, True)
                return r.text
            report(ip, False)
        except Exception:
            report(ip, False)
    return None
这份骨架里,三个关键点值得留意:分数机制让好IP被优先使用,冷却队列让坏IP自动休息,按域名限速避免了"一个参数控所有站点"的尴尬。实际跑起来,你只需要根据日志里的成功率和平均耗时,微调初始分值和QPS上限即可。
五、代理出口怎么选,决定了配置的上限
配置写得再漂亮,代理本身质量不行也是白费。采集场景对代理的要求其实很明确:IP要够用、提取要能自动化、延迟要稳定、匿名性要够高——不然目标站点一眼就认出你是代理流量。
天启HTTP 面向的就是这类国内业务场景,几个功能点跟采集配置能直接对接上:
- API提取:通过接口按需拉取IP列表,能直接接进上面的代理池逻辑,不用手工维护。
- 隧道转发:客户端只连固定入口,出口IP自动更换,适合不想自己写存活检测的团队。
- 独享IP池:IP不与他人共用,成功率和速度更稳定,适合对采集成功率要求高的任务。
- 地区筛选:需要抓特定城市的本地化数据时,可以按地区选择出口,配合"绑定调度"使用。
- 高匿名:请求头不暴露代理特征,降低被识别拦截的概率。
需要说明的是,天启HTTP 提供的是国内代理IP,适合抓取国内站点的公开数据;如果业务涉及境外站点,这套方案并不适用。
常见问题
Q:代理池里的IP越多越好吗?
不是。IP数量要和任务量匹配。池子太大,每个IP使用频率低,加权调度积累不到足够的历史数据,反而不好挑出优质IP。一般按"峰值并发 × 3 到 5 倍"来估算池子大小比较合适。
Q:为什么我做了URL去重,还是抓到很多重复内容?
大概率是缺少内容指纹这一层。很多站点的同一份内容会生成多个不同的URL(带参数、分页、分享链接等),只做URL去重拦不住。加上正文哈希判重就能解决大部分情况。
Q:限速到底该设多少?
没有通用答案,得试。方法是:先设一个保守值(比如单IP并发 1、每域名 2 QPS),跑一段时间看成功率;如果成功率长期在 95% 以上,逐步往上加;一旦出现大量 403、429 或超时,就退回到上一个档位。整个过程要分域名单独调。
Q:IP失败后是立刻删掉还是冷却?
建议冷却而不是删除。很多IP的失败是临时的(目标站点短暂限流、网络抖动),冷却几分钟再放回池子,往往还能用。只有连续多次失败、且冷却后仍然失败的IP,才真正剔除。
Q:隧道代理和API提取,采集时该选哪个?
看你对控制精度的需求。任务简单、想快速跑起来,选隧道转发,省掉IP池维护的代码;需要对单个IP的成功率做统计、需要精确控制调度策略和地区,选API提取自己管理IP列表。
Q:这套配置能直接用在多线程或异步采集上吗?
思路完全通用,只需要把共享的集合、分数表换成线程安全的容器或放到 Redis 里,限速器也要做成全局共享的(比如用令牌桶)。核心逻辑——加权调度、三层去重、按域名限速——不用改。