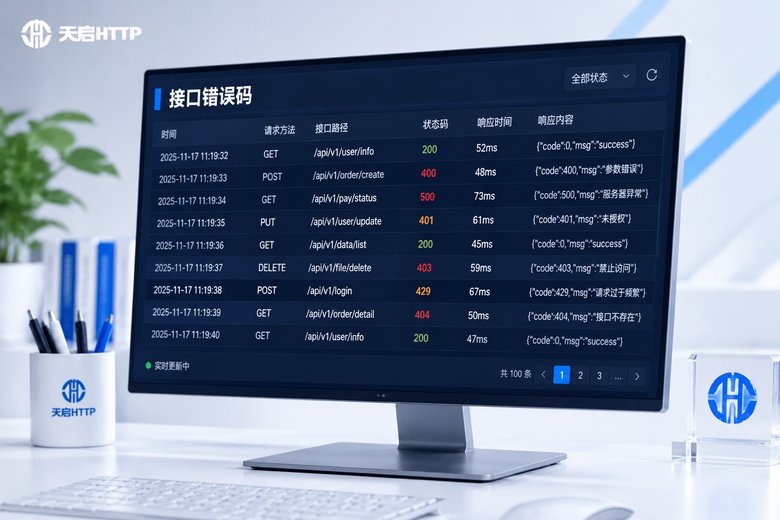
为什么错误码最容易被放过
做接口对接的同学多半有过这样的经历:拿到文档,粘贴示例代码,请求一发,返回 200,数据正常,于是心里就默认为"对接完成"。项目上线两周后,凌晨报警响了——任务大面积失败,日志里只有一行看不懂的几百字节响应。
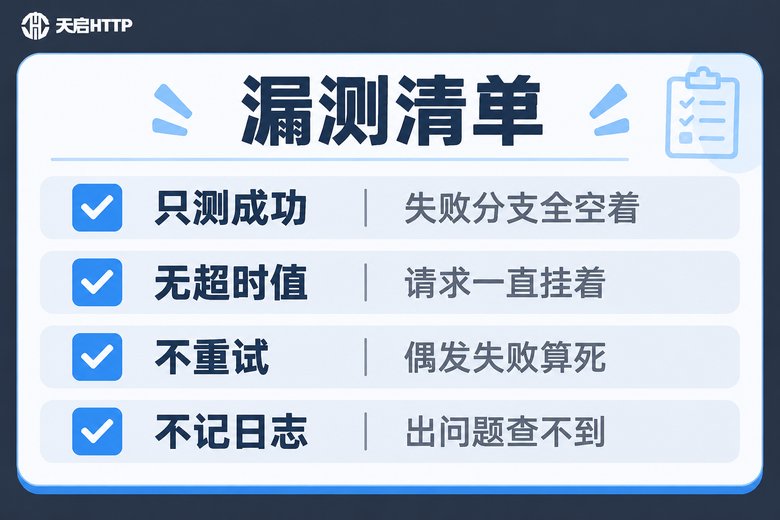
问题往往就出在这里:成功路径只有一种,失败路径有十几种。成功状态是单一结果,而错误码覆盖的是鉴权失效、余额不足、并发打满、目标站点拒绝、转发链路超时等一整片场景。测试时只跑通成功路径,相当于只验证了十分之一的逻辑。
接口代理对接更是如此。你的请求中间多了一层代理转发,链路上每一跳都可能返回错误,而这些错误最终都会以 HTTP 状态码或业务码的形式回到你的程序里。不测错误码,你根本不知道程序在异常时会做什么——是安静地重试三次、还是直接把整批任务标记为失败、还是干脆卡死在网络读写上。
代理 API 对接会遇到哪几类错误码
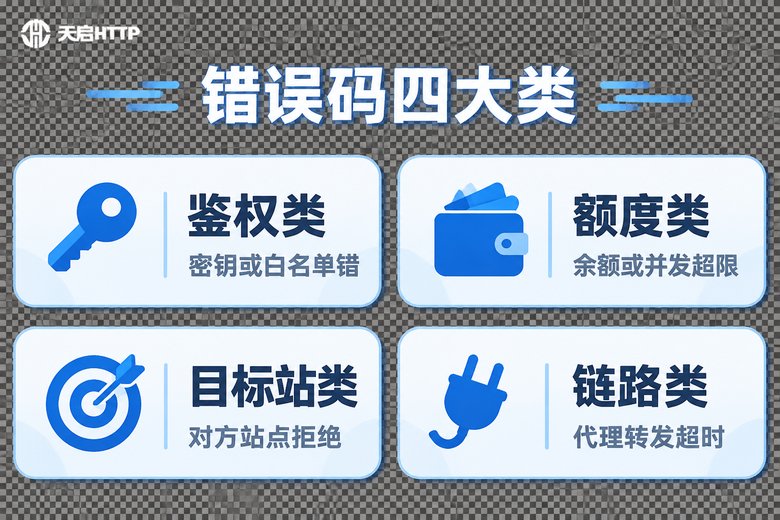
把错误码分好类,测试才有章法。实际对接中,返回的错误大致落在四个桶里。
鉴权类:密钥写错、签名过期、白名单里没加当前服务器出口 IP。这类错误通常在请求还没真正出网时就被拦下,响应快、内容短,很容易被误认为"网络抖动"。
额度类:账户余额不足、提取频率超过限制、同时在线 IP 数打满。这类错误在压力测试和定时任务里出现频率最高,却恰恰是单次手工测试永远碰不到的。
目标站类:代理本身是通的,但对方站点返回了拒绝、跳转或空内容。这时候状态码可能是 200,但业务上已经失败了,只看 HTTP 状态码会完全漏掉。
链路类:连接超时、读取超时、代理握手失败。这类错误最阴险,因为它不一定返回错误码,可能只是长时间不响应,如果你的代码没有设置超时,任务就会一直挂着。
一张表看清:错误发生时你的程序该做什么
光知道错误码还不够,关键是给每一类错误安排一个明确的处理动作。下面这张表可以作为对接时的工作底稿,具体码值以服务商文档为准,但处理思路是通用的。
| 错误类别 | 典型表现 | 常见原因 | 建议处理动作 |
|---|---|---|---|
| 鉴权失败 | 请求立即返回,响应体很短 | 密钥错误、白名单未生效 | 不重试,直接告警并停止任务,避免无效请求刷屏 |
| 额度或频率超限 | 间歇性失败,间隔后恢复 | 并发过高、提取过快、余额不足 | 退避重试,同时降低并发,余额类错误人工介入 |
| 目标站点拒绝 | 状态码正常但内容异常 | 访问过快、请求头缺失、页面结构变化 | 更换出口 IP 重试,并校验响应内容而不只看状态码 |
| 链路超时 | 长时间无响应 | 未设置超时、代理节点不可达 | 设置连接与读取超时,超时后切换 IP 重试 |
把这张表贴在对接文档旁边,你会发现测试用例的数量一下子从"几条"变成了"十几条",而这才是真实环境下的样子。
代码层面:错误码要落到统一的出口
很多项目出错码处理写得很散,A 函数里 try 一下,B 脚本里再判断一次,最后谁也不知道到底哪些错误被吃掉了。更稳的做法是所有代理请求走同一个封装函数,错误码在这里统一分流。
import time
import requests

def fetch_with_proxy(url, proxy, retry=2):
    """统一的代理请求出口:超时、错误码、重试都收在这里"""
    headers = {"User-Agent": "Mozilla/5.0"}
    for attempt in range(retry + 1):
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                headers=headers,
                timeout=(5, 15)  # 连接5秒,读取15秒,绝不能省
            )
        except requests.exceptions.ProxyError:
            # 链路类:代理握手失败,换 IP 重试
            time.sleep(1 + attempt)
            continue
        except requests.exceptions.Timeout:
            # 链路类:超时,换 IP 重试
            time.sleep(1 + attempt)
            continue

        code = resp.status_code
        if code == 200:
            # 成功也要校验内容,避免"200 但空壳"
            if not resp.text.strip():
                return None, "EMPTY_BODY"
            return resp.text, None
        elif code in (401, 403):
            # 鉴权类:重试没意义,直接抛出让人处理
            raise RuntimeError(f"鉴权或白名单异常:{code}")
        elif code == 429:
            # 频率类:退避等待
            time.sleep(3 * (attempt + 1))
            continue
        elif code >= 500:
            # 服务端或链路类:换 IP 重试
            time.sleep(1 + attempt)
            continue
        else:
            return None, f"HTTP_{code}"

return None, "RETRY_EXHAUSTED"注意两个细节:一是 timeout 必须写,而且连接和读取分开设;二是 200 不等于成功,空响应、跳转页、验证页都要当成失败处理。把这两点补上,很多"偶发失败"其实当场就能定位。
测试怎么设计,才叫"测过错误码"
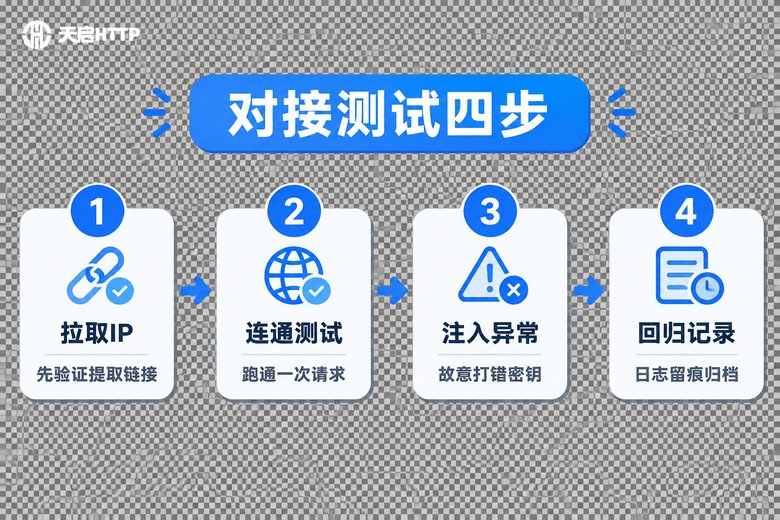
错误码测试不需要复杂的工具,只需要在联调阶段有意识地制造异常。下面四步是很实用的顺序。
第一步,故意打错密钥。把密钥改一个字符,看程序是抛异常、还是静默重试、还是一直循环。如果它默默重试了五十次,说明你上线后会看到成片的无效请求。
第二步,故意把并发拉高。用平时三到五倍的并发量跑一小段时间,观察频率类错误的表现,确认退避策略真的生效,而不是所有任务一起失败。
第三步,故意制造超时。把代理地址改成一个不可达的地址,或者在代码里把 timeout 调成 0.001 秒,看超时分支能不能正常触发、任务会不会卡死。
第四步,观察日志。这一步最容易被跳过。跑完异常测试后翻一遍日志,确认每次失败都记录了时间、错误码、使用的 IP 和重试次数。没有日志的错误码测试,等于没测。
选代理时,接口这块要看什么
对接体验好不好,很大程度取决于服务商的接口设计是否规范。挑服务时可以重点看三件事:
错误是否可区分。好的接口会把"密钥错误"和"余额不足"分开表达,而不是统统返回一个 400。分不开,你的程序就无法做出正确的重试决策。
提取方式是否够用。除了按次提取的 API 链接,还要看是否支持隧道代理这类免维护的形式,省去在本地维护 IP 池的麻烦。
认证方式是否灵活。密钥认证和白名单认证各有适用场景,服务器出口 IP 固定时用白名单更省事,多环境部署时用密钥更灵活。
天启HTTP 提供国内代理 IP 服务,支持 HTTP、HTTPS 与 SOCKS5 协议,接口提取与隧道代理两种接入形态都有,认证上支持密钥和白名单两种方式。它的适用范围是国内网络环境下的采集、测试与网络管理工作,不涉及境外 IP 场景。对接前先看一遍官方文档里的返回码说明,把自己的错误处理分支对着写一遍,比事后线上排查省事得多。
常见问题
Q:接口返回 200 就代表请求成功了吗?
不一定。代理转发环节通顺时就会返回 200,但目标站点可能给出的是拒绝页、跳转页或者空内容。判断成功要同时看状态码和响应体内容,缺一不可。
Q:鉴权类错误要不要重试?
不建议。密钥错误、白名单未生效这类问题,重试一百次结果都一样,只会白白消耗请求次数。正确做法是立即告警、停止任务,人工修正配置后再重跑。
Q:为什么本地测试全通过,上线后错误码一堆?
本地通常只有一两个请求、一个固定出口 IP,而线上是多并发、多服务器、长时间运行。频率限制、并发上限、IP 有效期这些问题,只有接近真实压力时才会暴露。建议联调阶段就跑一次小规模压测。
Q:日志里只记一个状态码够不够?
不够。至少要记下发生时间、错误码、响应体前若干字节、本次使用的出口 IP 和重试次数。缺少 IP 信息时,你无法判断是某个节点的问题还是全局问题。
Q:错误码处理写好之后还要做什么?
定期回看。业务量变化、并发调整、目标站点改版,都会让原本合理的重试策略变得不合理。建议每月看一次失败日志的分布,把新出现的错误码补进处理表里。