抓取只是开头,真正费时间的是后面那些活
很多人第一次做数据采集,注意力全放在"怎么抓"上:怎么绕过限制、怎么配置代理、怎么让程序跑起来。等程序真的跑通了,看着日志一行行刷过去,还挺有成就感。
但真正的麻烦往往从这一步才开始。你打开抓下来的那份数据文件,会发现:同一个商品出现了七八遍,价格栏里写着"¥129.00 起",标题里混着"【限时特惠】"和一堆表情符号,有的行只有一半字段,还有的整页都是验证提示而不是真实内容。
也就是说,抓取是几分钟的事,把数据变得能用,是几小时甚至几天的事。这篇文章就聊聊:代理抓取之后,清洗和去重到底难在哪,怎么做得又快又省力。
用代理IP抓回来的数据,一般脏在哪些地方
不带代理、只抓一两个页面的时候,数据往往很干净,因为来源单一、请求稳定。一旦用上代理IP做规模化采集,脏数据的来源立刻变多,常见的有这几类:
1. 重复数据。同一个页面被不同入口抓到、翻页时上一页的最后一条又出现在下一页、多个代理IP请求到同一份缓存结果,都会让重复行成倍出现。
2. 残缺数据。请求超时、连接被中途断开、代理响应慢导致页面只加载了一半,抓下来的记录就会缺字段。这类数据最坑,因为它看起来"有",但用起来全是空值。
3. 干扰内容。反爬机制返回的提示页、广告模块、推荐位文案、导航栏文字,都会被一并抓进正文里。
4. 格式不统一。价格有的带货币符号有的不带,销量写着"1.2万+",时间有的是"2024-05-01"有的是"5月1日",地址字段把省市区塞在一个格子里。
这四类问题不处理,后面无论做报表、做比价还是做训练数据,结论都是错的。
去重:先给每条数据算一个"指纹"
去重最省事的思路不是"两两比对",那在几十万条数据上根本跑不动。正确做法是:为每条记录生成一个唯一指纹,再按指纹去重。指纹一般由几个能代表这条记录身份的字段拼出来,比如商品ID、标题、店铺名,做一次哈希。
import hashlib, re

def normalize(text):
    if not text:
        return ""
    text = re.sub(r"\s+", "", str(text))          # 去掉所有空白
    text = re.sub(r"[【】\[\]()()!!,,。.]", "", text)  # 去掉符号和营销词
    return text.strip().lower()

def fingerprint(row):
    key = "|".join([
        normalize(row.get("shop_id")),
        normalize(row.get("title")),
        normalize(row.get("price"))
    ])
    return hashlib.md5(key.encode("utf-8")).hexdigest()

seen, clean_rows = set(), []
for row in raw_rows:
    fp = fingerprint(row)
    if fp in seen:
        continue
    seen.add(fp)
    clean_rows.append(row)

print("原始", len(raw_rows), "去重后", len(clean_rows))这里有两个细节值得注意:先归一化再算指纹,否则"¥129"和"129"会被当成两条;指纹字段不要选太多,选三到四个稳定字段就够了,字段越多越容易把本该合并的记录漏掉。
另外,去重不一定要一次做完。可以先用指纹做粗筛,再用相似度(比如标题编辑距离)做二次合并,这样既能控制内存,也能兼顾精度。
清洗:把脏数据变成能直接用的字段
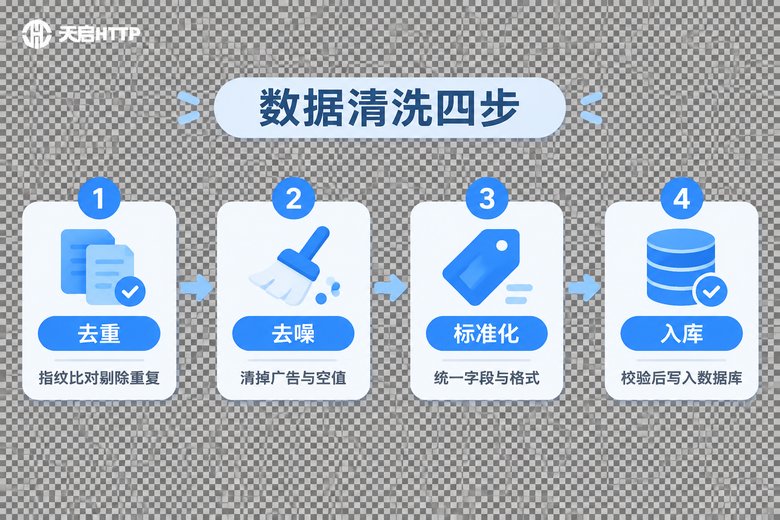
清洗的核心是"定规则"。不要一上来就写代码,先拿一百条样本出来,把每一类脏数据列清楚,再逐条写规则。常用的几招是:
字段裁剪。只保留你要的那几列,其余全部丢掉。很多人的数据文件越洗越大,就是因为把整页 HTML 文本都留着了。
正则提纯。价格、销量、库存这类字段,用正则把数字提出来,再统一单位。
import re

def parse_price(text):
    if not text:
        return None
    m = re.search(r"(\d+(?:\.\d+)?)", str(text).replace(",", ""))
    return float(m.group(1)) if m else None

def parse_sales(text):
    if not text:
        return 0
    text = str(text)
    m = re.search(r"(\d+(?:\.\d+)?)", text)
    if not m:
        return 0
    num = float(m.group(1))
    return int(num * 10000) if "万" in text else int(num)

print(parse_price("¥1,299.00 起"), parse_sales("1.2万+人付款"))空值策略要提前定。缺价格的记录是补一个默认值、丢掉整行,还是标记为待复查?这一步没想清楚,后面数据一多就会反复返工。
有效性校验。给每条记录加几个检查项:必填字段是否齐全、价格是否在合理区间、时间是否能被解析。校验不通过的记录单独存一份,方便回溯,不要直接删掉。
时间到底花在哪:一份真实的耗时对比
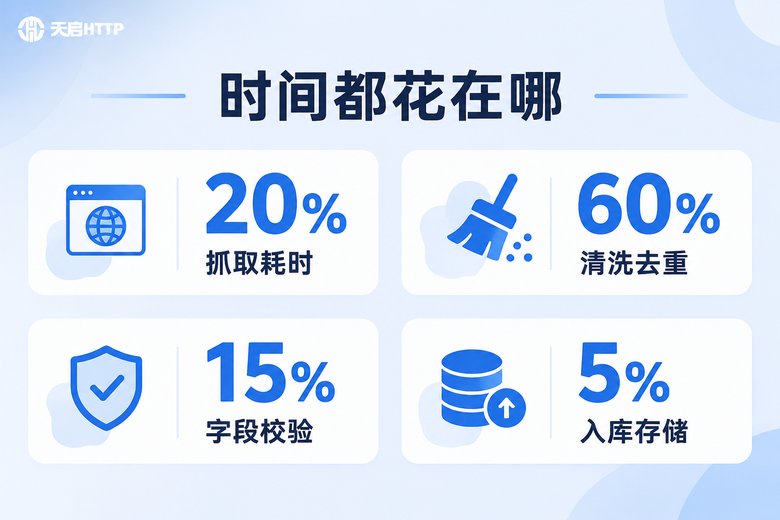
下面这份数据来自一个中等规模的商品采集任务(约 20 万条原始记录、8 个字段),把各环节实际耗时占比列出来,你会更直观地理解标题那句话。
| 环节 | 典型耗时 | 占比 | 主要工作 |
|---|---|---|---|
| 代理配置与抓取 | 20 分钟左右 | 约 20% | 提取IP、调度请求、断点续抓 |
| 去重 | 1.5 小时左右 | 约 30% | 字段归一化、指纹计算、二次合并 |
| 字段清洗 | 1.5 小时左右 | 约 30% | 正则提纯、单位统一、空值处理 |
| 校验与入库 | 40 分钟左右 | 约 15% | 规则校验、异常样本留档 |
| 存储落库 | 15 分钟左右 | 约 5% | 建表、批量写入、索引 |
可以看到,抓取只占两成,剩下八成都在后面。而且这八成的时间还有个特点:第一次做最慢,把规则和脚本沉淀下来之后,第二次同类任务可能只要十几分钟。所以这笔时间不是白花的,它其实是在攒工具。
代理稳不稳,会直接影响你的清洗量
有个容易被忽略的因果关系:清洗的工作量,很大程度上由抓取质量决定。代理响应慢、频繁掉线、IP 重复率高,就会出现大量半截页面和重复请求,脏数据比例可能从 10% 涨到 40%,你在清洗上花的时间也就跟着翻倍。
所以在清洗上抠细节之前,先把抓取端的基础打好。国内数据采集场景下,比较实用的做法是选择像天启HTTP这样面向国内业务的代理IP服务商:
· 独享IP资源,减少和其他用户共用导致的请求拥堵,返回页面更完整;
· 高匿名代理,请求头干净,降低被识别、被返回干扰页的概率;
· API 提取与城市级筛选,可以按业务需要控制取用节奏,方便程序里做失败重试和自动切换;
· 支持 HTTP / HTTPS 等常见协议,接入现有采集框架基本不用改代码结构。
需要说明的是,天启HTTP 提供的是国内代理IP,适用于国内网站与本地化业务数据的采集,不适用于需要海外网络的场景;同时它也不提供住宅类IP,选购时按自己的业务类型匹配即可。
少走弯路的几条经验
抓的时候就顺手带上指纹。采集时多加一个字段存指纹值,后面去重会快很多,也便于增量更新时判断是不是同一条。
把失败请求单独存一份日志。哪一批请求用的是哪类代理、失败原因是什么,记清楚,下次直接优化那一批,而不是全量重抓。
清洗脚本和采集脚本分开写。采集负责拿数据,清洗负责改数据,中间用文件或数据库隔开。这样规则改了不用重抓,抓取重跑也不用重写清洗逻辑。
定期抽检。每次任务结束后随机抽 50 条人工看一遍,比任何统计指标都更能发现新出现的脏数据类型。
常见问题
Q:用 http 代理抓数据,一定要做去重吗?
基本是必须的。翻页重叠、多入口抓取、重试请求都会产生重复记录,不去重的话,后续的统计和排序结果会明显失真。
Q:去重和清洗,先做哪个?
建议先做轻量归一化,再算指纹去重,最后做字段级清洗。因为格式不统一的数据直接去重,会把同一条记录当成两条。
Q:数据量很大,内存放不下怎么办?
可以分批处理,每批算完指纹后写入数据库或临时文件,用数据库的唯一索引来兜底去重,内存占用就很低了。
Q:为什么我抓到的数据里总有一些奇怪的提示页?
通常是请求被识别为异常流量后返回的干扰内容。可以优先检查代理的匿名程度、请求频率和请求头设置,换成更稳定的独享代理IP 往往能明显改善。
Q:清洗规则需要每次都重写吗?
不需要。同类站点把规则固化成配置(字段位置、正则、单位换算表),换站点只改配置不改代码,第二次任务的耗时会大幅下降。
Q:天启HTTP 能用在哪些采集场景?
国内电商商品与价格监控、企业信息核对、内容聚合、搜索排名观察等国内数据采集场景都比较合适。它提供的是国内代理IP,不涉及海外网络访问场景,也没有住宅类IP。