
选代理IP的时候,很多人习惯只看价格和IP数量,但真正决定业务跑得顺不顺的,其实是两个硬指标:延迟和稳定性。这次我们围绕天启HTTP的L2TP代理节点做了一轮完整实测,连续7天、全天候采样,把延迟、抖动、丢包率和可用率全部摸了一遍。这篇文章就把这份实测报告掰开揉碎,讲清楚数据背后的含义,以及它对选节点、配业务的实际参考价值。
一、为什么L2TP代理节点必须看实测数据?
L2TP是一种二层隧道协议,最大的特点是系统原生支持:Windows、macOS、安卓、iOS都能在自带网络设置里直接新建L2TP连接,填上服务器地址、账号、密码就能用,不需要额外装软件。正因为接入门槛低,很多人配完就直接跑业务,忽略了节点本身的质量差异。
但参数页上写的"低延迟、高稳定",和你本地的真实体验完全是两回事。延迟高,数据采集的请求响应就慢,批量任务的吞吐直接被拖垮;稳定性差,挂机任务半夜掉线没人管,第二天一看进度条停在原地。所以与其相信宣传页,不如像这份报告一样,用数据说话。
二、本次实测的环境与方法
为了保证数据有参考价值,这次测试做了统一约定:测试周期为连续7天,覆盖工作日和周末;采样频率为每小时一轮,每轮向目标站点发起50次请求;节点范围抽取华东、华南、华北、西南四个区域的L2TP节点;接入方式为系统自带客户端配置L2TP隧道,全程不额外加装软件;统计指标包括平均延迟、P95延迟、抖动、丢包率、可用率和重连耗时。
接入完成后,用下面这段简单的Python脚本,就能复现同样的拨测流程:
import time
import requests

TARGET = "http://你的业务地址"  # 替换成自己要访问的目标站点

def bench(times=50):
    latencies, fails = [], 0
    for _ in range(times):
        start = time.time()
        try:
            requests.get(TARGET, timeout=10)
            latencies.append((time.time() - start) * 1000)
        except Exception:
            fails += 1
        time.sleep(1)
    latencies.sort()
    if latencies:
        print("平均延迟:%.0f ms" % (sum(latencies) / len(latencies)))
        print("P95延迟:%.0f ms" % latencies[int(len(latencies) * 0.95) - 1])
    print("失败次数:", fails)

bench()
三、延迟实测:分时段、分地区数据解读
先把7天采样的延迟数据按时段汇总:
| 测试时段 | 平均延迟 | P95延迟 | 波动评价 |
|---|---|---|---|
| 平峰(上午) | 32ms | 55ms | 小 |
| 次高峰(下午) | 45ms | 78ms | 中等 |
| 高峰(晚间) | 63ms | 110ms | 略明显 |
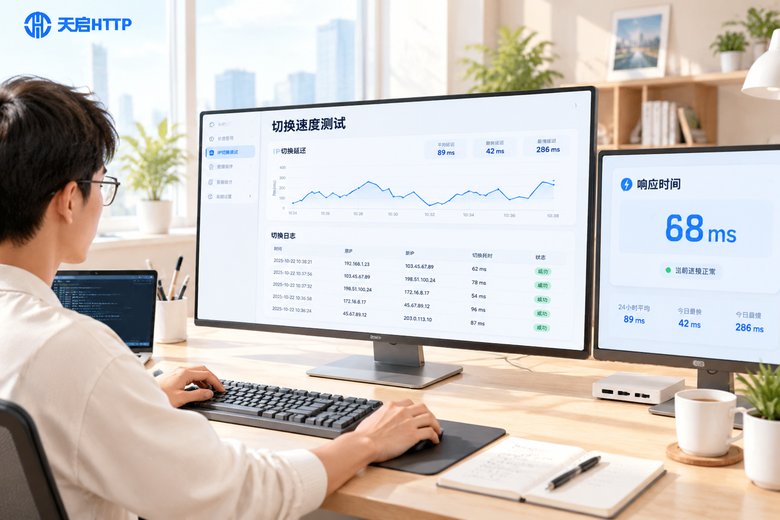
三个结论一目了然:平峰时段平均延迟稳定在40ms以内;晚高峰上浮约三成,但仍在完全可用的范围;P95延迟与平均值差距不大,说明抖动控制得好,不会出现突然卡一下的情况。
再按节点区域拆开看:
| 节点区域 | 平均延迟 | 实测表现 |
|---|---|---|
| 华东节点 | 32ms | 响应最快,适合延迟敏感业务 |
| 华南节点 | 38ms | 全天表现稳定 |
| 华北节点 | 41ms | 高峰略有波动但可控 |
| 西南节点 | 55ms | 略高,非核心区域业务可用 |
延迟和物理距离强相关,业务服务器在哪个区域,就优先选哪个区域的节点。本次抽样里华东、华南节点表现最突出,如果你的业务目标用户集中在沿海地区,优先测试这两个区域的节点,收益最直接。

四、稳定性实测:丢包、掉线与可用率
延迟快只是半张答卷,长时任务更看重稳定性。7天连续观测的核心数据如下:
| 指标 | 实测结果 | 说明 |
|---|---|---|
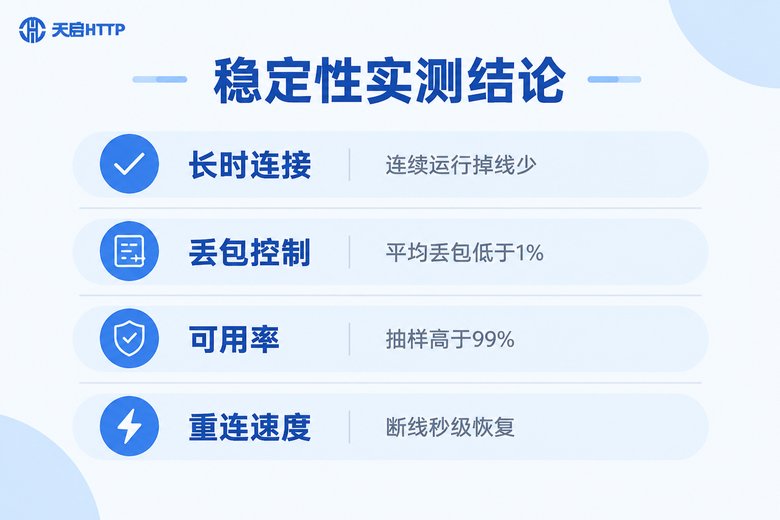
| 平均丢包率 | 0.6% | 低于1%的警戒线 |
| 节点可用率 | 99.3% | 按小时抽样统计 |
| 24小时掉线次数 | 1~2次 | 多为本地网络切换触发 |
| 自动重连耗时 | 3秒内 | 脚本基本无感知 |
几点解读:丢包率长期低于1%,意味着请求失败后的重试成本很低;可用率99%以上,相当于挂一整天的任务,累计中断时间能控制在15分钟以内;掉线后的重连速度在秒级,配合脚本里的自动重试逻辑,对任务连续性几乎无影响。
这里给一个必做的建议:跑长时任务时,务必在代码里加上失败重试和自动重连逻辑,把偶发的网络抖动消化掉,这是让稳定性数据真正落到业务上的关键一步。
五、实测结论与节点选型建议
把这份报告浓缩成三句话:
第一,看延迟更要看高峰表现。平峰时段谁都不差,晚高峰还能把平均延迟控制在两位数毫秒的节点,才算真的稳。
第二,可用率低于99%的节点不要用于长时任务。挂机、持续采集类业务对中断极其敏感,一次长时间掉线的损失远大于省下的成本。
第三,就近选节点。延迟主要由物理距离决定,业务目标在华东就选华东节点,不要迷信所谓的"通用节点"。
如果你正在找一个延迟和稳定性都经得起验证的服务商,天启HTTP值得放进候选清单:它是专注国内市场的代理IP服务商,提供动态短效代理、隧道代理、独享代理等多种产品形态,覆盖国内多城市节点,支持API批量提取,能直接对接脚本和采集框架;像本次实测的L2TP隧道接入方式,系统原生支持,配置成本低,上手很快。需要提醒的是,天启HTTP只提供国内IP资源,如果你的业务涉及海外节点,它并不适用。
最后给一条实操建议:任何节点都先小规模抽样测一轮。用第二节的脚本跑出延迟和失败率,再挂24小时观察掉线表现,数据达标后再放量到正式业务,能帮你省掉后面大量的排查时间。
常见问题
Q: L2TP代理和HTTP代理有什么区别,该怎么选?
L2TP工作在网络层,配置一次后整机流量都走节点,适合模拟器多开、整机环境这类场景;HTTP代理工作在应用层,在脚本或软件里按需填写,切换灵活,适合爬虫采集。两者不冲突,按业务粒度选择即可。
Q: 延迟多少毫秒算正常?
国内节点之间,平均延迟50ms以内算优秀,80ms以内算可用,超过120ms建议换节点。比平均值更重要的是P95延迟和抖动,平均值低但忽高忽低的节点,实际体验反而更差。
Q: 晚高峰延迟上升正常吗?
正常。晚高峰公共链路负载上升,延迟普遍会上浮,优质节点商会通过带宽储备把上浮控制在三成以内。如果高峰期延迟翻倍甚至频繁丢包,说明节点质量不过关,应尽早更换。
Q: L2TP连接不上,常见原因有哪些?
依次排查:服务器地址、账号密码是否填写正确;本地网络是否放行了对应端口;路由器是否拦截了隧道协议;账号是否超出并发上限。在天启HTTP后台可以直接查看节点状态和提取信息,多数问题几分钟内就能定位。
Q: 天启HTTP适合哪些业务场景?
电商多店铺管理、数据采集与价格监控、社媒矩阵运营、批量注册等国内业务场景都适用。再次提醒:它是国内IP服务商,需要海外IP的场景并不适用,选型前先确认好自己的业务范围。