
买长效代理之前,商家页面上写着"可用率高""响应快",可真正跑起业务来,掉线、超时、重连慢这些坑只有自己踩过才知道。与其等业务出了问题再补救,不如拿到IP之后先做一轮稳定性实测。本文介绍两种最实用的测法:连续运行观察和断线重连观察,照着做一遍,一支IP靠不靠谱,测完心里就有数了。
一、为什么长效代理必须实测?
长效代理的核心价值就在"长"字上:同一个IP要能长时间在线、反复使用不掉链子。它和短效代理不一样——短效IP本来就经常更换,偶尔断一下影响不大;而长效IP一旦中途掉线或失效,正在跑的挂机任务、批量操作、登录会话就可能全部中断,损失远不止一次请求失败。
所以评估长效代理,不能只看宣传参数,要重点验证三件事:能不能长时间不断线、掉线之后能不能快速恢复、恢复之后IP是不是还是原来那个。这三点,恰好对应下面两种测法。
二、先定指标:测什么才算"稳定"
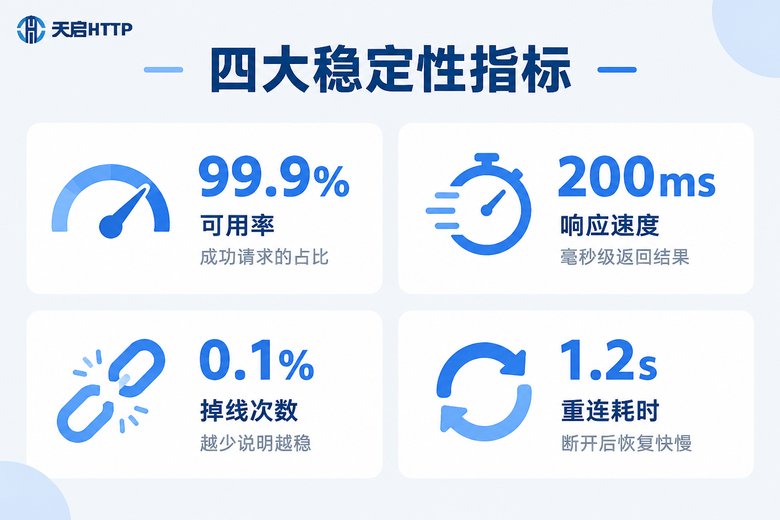
测试之前先把指标定清楚,否则跑完一堆数据也不知道怎么下结论。长效代理的稳定性,主要看下面几项:
| 指标 | 含义 | 合格参考 |
|---|---|---|
| 可用率 | 成功请求数 ÷ 总请求数 | ≥ 99% |
| 平均响应时间 | 每次请求的耗时均值 | 毫秒级为佳 |
| 掉线次数 | 超时、连接中断的次数 | 24小时内越少越好 |
| 重连耗时 | 从失败到恢复成功的时间 | 30秒以内 |
| IP存活时长 | 同一个IP持续可用的时间 | 与套餐承诺一致 |
这些指标里,可用率和重连耗时最能反映真实体验:可用率决定任务成功率,重连耗时决定掉线一次要损失多少时间。把这两项盯紧了,大方向就不会错。
三、连续运行测试:让IP先跑够24小时
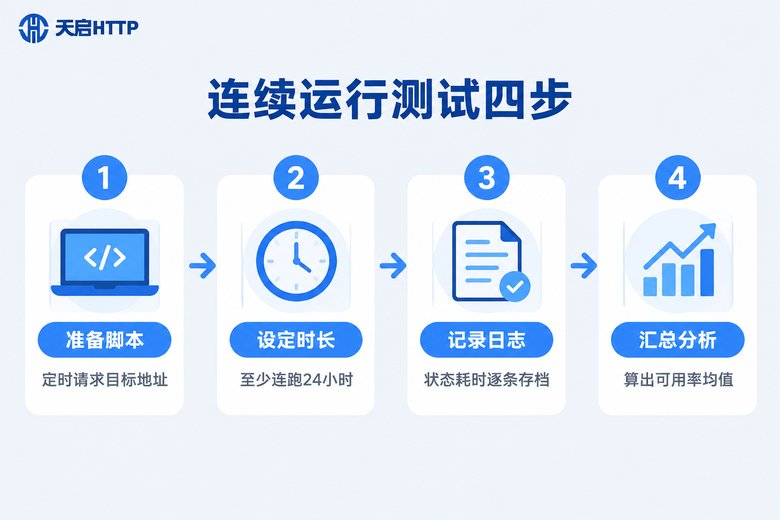
方法不复杂:写一个小脚本,定时通过代理发请求,把每次的结果记录下来,连续跑上一整天甚至三天。具体分四步。
第一步,准备测试脚本。用Python几十行就够了,核心逻辑是每隔几秒通过代理请求一次,把时间、结果、耗时、出口IP逐条写进日志:
import requests, time, csv

PROXY = "http://用户名:密码@代理IP:端口"   # 换成你的长效代理信息
TEST_URL = "http://httpbin.org/get"        # 建议换成业务实际访问的地址
INTERVAL = 3                               # 请求间隔,单位秒
DURATION = 24 * 3600                       # 连续测试24小时

with open("proxy_log.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["时间", "结果", "耗时ms", "出口IP"])
    start = time.time()
    while time.time() - start < DURATION:
        t1 = time.time()
        try:
            r = requests.get(TEST_URL,
                             proxies={"http": PROXY, "https": PROXY},
                             timeout=10)
            cost = int((time.time() - t1) * 1000)
            result = "成功" if r.status_code == 200 else "HTTP异常"
            exit_ip = r.json().get("origin", "-")
        except Exception:
            cost = int((time.time() - t1) * 1000)
            result, exit_ip = "失败", "-"
        writer.writerow([time.strftime("%H:%M:%S"), result, cost, exit_ip])
        f.flush()
        time.sleep(INTERVAL)
第二步,设定测试时长。至少连续跑24小时,条件允许跑满72小时更好,这样才能覆盖白天高峰和深夜低谷,看出不同时段的表现差异。
第三步,控制请求频率。间隔3~5秒请求一次,就接近真实的使用状态。不要为了"压测"把频率调得极高——那样测出来的是并发能力,不是长效稳定性,方向就跑偏了。
第四步,汇总日志。跑完后统计总请求数、成功数、失败数、平均耗时、最长连续失败时长。可用率的算法很简单:可用率 = 成功请求数 ÷ 总请求数 × 100%。
四、断线重连观察:掉线之后才是关键
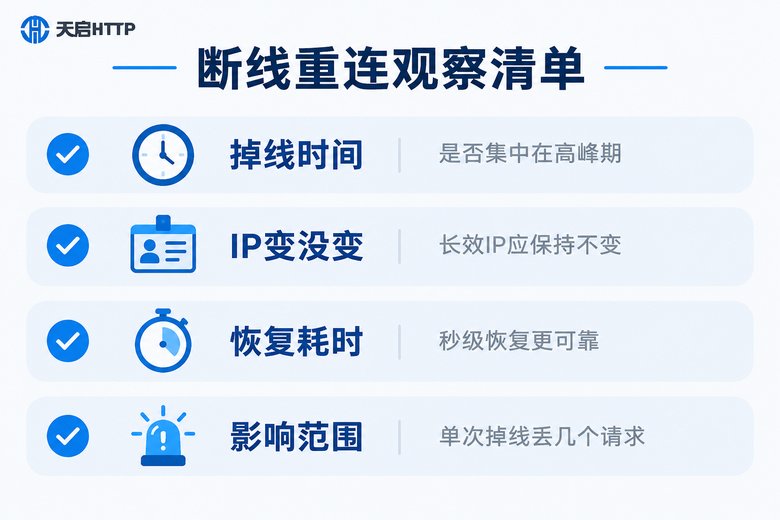
连续运行测试记录的是"正常时候"的表现,而长效IP真正的分水岭在掉线之后。观察断线重连,重点盯四件事:
1. 掉线时间点。对照日志时间戳,看掉线是随机出现,还是集中在某些时段(比如晚高峰)。集中在固定时段,多半说明节点负载有问题。
2. 恢复之后IP变没变。掉线重连成功后,立刻查一次出口IP。如果IP变了,说明所谓"长效"其实是断了就换——对需要保持登录态的业务来说,等于白搭。
3. 恢复耗时多久。记录从第一次失败到下一次成功之间隔了多久。秒级恢复基本无感;要是几分钟才缓过来,任务可能早就报错退出了。
4. 单次掉线影响多大。看一次掉线连累了几个请求。只失败一两次属于正常网络抖动;连续失败十几次,就是链路真不稳了。
不需要人为去"弄断"网络——长效IP在日常运行中自然会出现波动,把每一次波动都记进表格就够了:
| 观察项 | 怎么记录 | 重点关注 |
|---|---|---|
| 掉线时间点 | 日志里的时间戳 | 是否集中在固定时段 |
| 出口IP变化 | 恢复后立即查一次IP | 长效IP不应变化 |
| 恢复耗时 | 失败到下次成功的间隔 | 秒级恢复更可靠 |
| 影响请求数 | 单次掉线失败的条数 | 连续失败要警惕 |
五、结果怎么算合格?选型时怎么用?
测完之后,给自己划一条及格线:可用率≥99%、平均响应毫秒级、24小时掉线不超过个位数、重连恢复在30秒以内、恢复后IP保持不变——五条全中,这支长效IP才算真正能扛业务。
当然,测得省心不如选得靠谱。像天启HTTP这类自建机房的服务商,节点覆盖全国200多个城市,官方标注可用率99%以上、毫秒级响应,并且有7×24小时的接口请求监测,长效静态IP拿来做挂机、批量任务这类长时间运行的场景,稳定性底子会扎实很多。拿到手之后,再用上面这套方法实测一遍,双保险。
常见问题
Q: 测试要跑多久才有说服力?
最低24小时,建议72小时。时间太短赶不上高峰低谷和偶发抖动,容易把"运气好"当成"真稳定"。
Q: 测试请求会消耗套餐的量吗?
会。每一次通过代理发出的请求都算正常使用。测试前先看看套餐额度,按测试时长和请求间隔估算一下消耗,别把业务要用的量提前用完了。
Q: 掉线重连后IP变了,还算长效代理吗?
严格来说不算。长效的意义就是IP持续可用、身份不变;断了就换IP的产品,更适合对IP连续性没要求的场景。
Q: 为什么我实测的可用率比商家宣传的低?
常见原因有三个:本地网络自身波动、测试目标网站响应慢被算成了代理失败、测试时段正好撞上目标站高峰。可以先换一个稳定的目标地址再测一轮,排除外部干扰后再下结论。