做数据采集、批量任务或长期保持连接的朋友,几乎都遇到过同一个糟心问题:代理用着用着就断,要么报超时,要么连接被重置,任务跑到一半全卡住。很多人第一反应是"代理不行",换了服务商接着断,问题依旧。其实频繁断连的根因大多藏在三个地方:链路质量、超时参数、重连策略。这篇文章就带你按顺序把问题定位出来,并给出可以直接抄走的参数配置。
先分清:你的"断连"属于哪一种?
动手排查之前,先观察断连的表现形式,不同表现对应的根因完全不同:
| 断连表现 | 典型特征 | 更可能的原因 |
|---|---|---|
| 完全连不上 | 一次都没成功过 | 代理地址写错、认证信息错误、白名单未绑定 |
| 用着用着掉 | 跑一段时间后集中断 | 链路波动、空闲连接被掐断、IP授权到期 |
| 偶发失败可恢复 | 偶尔报错,重试就好 | 瞬时丢包、目标站点限流 |
如果是第一种,先检查账号和配置;后两种才是本文的重点,按下面三步走。
第一步:排查链路质量——断连大多出在"路上"
一次代理请求要经过三段链路:本地网络 → 代理服务器 → 目标站点。任何一段抖动,表现到程序上都是"断连",所以要先分段检查,别急着甩锅给代理。
本地段:WiFi信号弱、路由器长时间不重启、晚高峰宽带拥塞,都会造成周期性掉线。可以先用有线网络做对比测试,如果换有线后断连明显减少,问题就在本地。
代理段:用下面的命令看延迟和丢包:
# 查看到代理服务器的延迟与丢包
ping 代理服务器IP

# 追踪路由,定位是哪一跳开始劣化
tracert 代理服务器IP    # Windows
mtr 代理服务器IP # Linux / macOS,持续观察更直观目标段:如果绕开代理直连目标站点也偶发超时,说明问题出在目标站点自身的限流或高负载,跟代理无关。
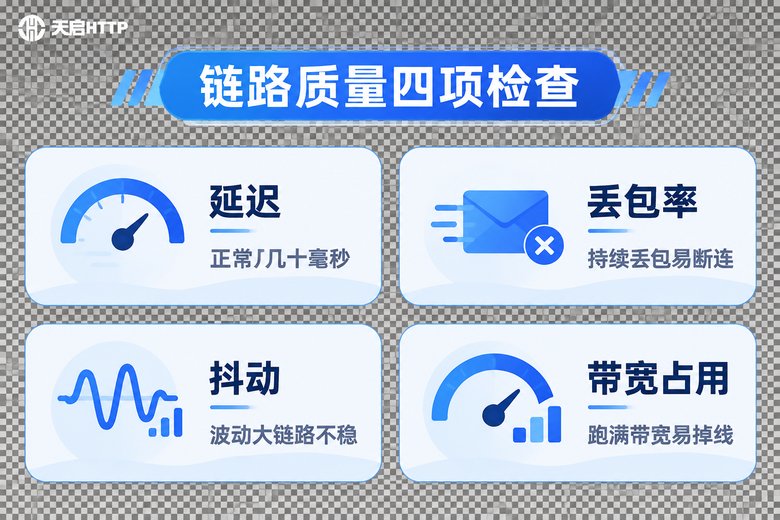
链路质量好不好,对照下面四个指标判断:
| 指标 | 健康参考 | 异常时的影响 |
|---|---|---|
| 延迟 | 几十毫秒且稳定 | 延迟过高或忽大忽小,容易触发超时误判 |
| 丢包率 | 接近 0% | 持续丢包会直接造成连接中断 |
| 抖动 | 波动越小越稳 | 抖动大时请求时快时慢,批量任务失败率飙升 |
| 带宽占用 | 留有余量 | 带宽跑满后新建连接容易被挤掉 |
第二步:检查超时参数——很多"断连"其实是超时误判
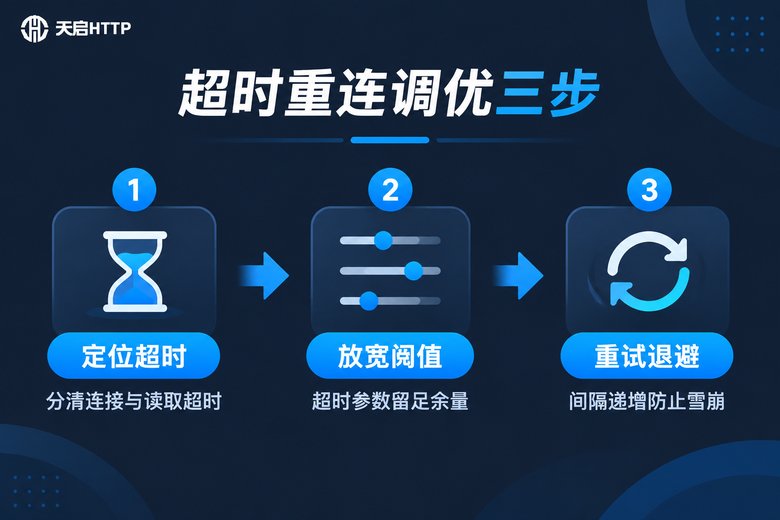
定位完链路,第二步检查程序里的超时设置。很多所谓的"断连",其实是超时阈值设得太短,正常响应被当成了故障。三个超时参数要分清:
连接超时(connect timeout):建立TCP连接(含代理握手)的最长等待时间。设得太短,网络稍一抖动就报错。
读取超时(read timeout):连接建立后等待对方返回数据的时间。目标站点响应慢时,这个值太短会频繁误报断连。
空闲超时(idle timeout):连接空闲多久后被关闭。特别注意,中间的NAT设备、防火墙也有自己的空闲会话回收时间(常见几十秒到几分钟),长连接闲置太久会被"悄悄掐断",下次复用时就表现为断连——这是长连接场景里最隐蔽的坑。
import requests

proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

# 连接超时与读取超时分开设置,不要用一个笼统的超时值
resp = requests.get(
    "https://目标站点.com",
    proxies=proxies,
    timeout=(5, 30),   # (连接超时5秒, 读取超时30秒)
)调参原则:按目标站点正常响应速度留出2~3倍余量,而不是盲目拉大。长连接场景要配合心跳保活,把心跳间隔控制在30~60秒,让连接一直"活着",就不会被中间设备回收。
第三步:优化重连策略——让程序学会"自愈"
链路再稳、参数再合理,也做不到百分百不断连。成熟的方案不是消灭断连,而是断连后能自动恢复。重连策略有三个要点:
1. 重试次数控制在2~3次。重试太少,偶发故障扛不过去;重试太多,故障期间会把请求量放大几倍,形成雪崩。
2. 用指数退避拉开重试间隔。比如1秒、2秒、4秒递增,给链路恢复留出时间,也避免同一时刻集中重试再次打满链路。
3. 断连后换IP再试。同一个IP连续失败,大概率是这个IP当前质量差,换一个新IP往往立即恢复。配合代理服务商的API提取接口,可以做到"断连 → 自动换IP → 重试"全流程无人值守。
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
import requests

retry = Retry(
    total=3,               # 最多重试3次
    backoff_factor=1,      # 退避间隔:1秒、2秒、4秒递增
    status_forcelist=[500, 502, 503, 504],
)

session = requests.Session()
adapter = HTTPAdapter(max_retries=retry, pool_maxsize=20)
session.mount("http://", adapter)
session.mount("https://", adapter)

resp = session.get("https://目标站点.com",
                   proxies=proxies, timeout=(5, 30))
另外提醒一点:如果重试的是下单、提交这类写操作,先确认接口支持幂等,避免重试造成重复提交。
参数调优参考表(可直接抄)
| 参数 | 建议值 | 说明 |
|---|---|---|
| 连接超时 | 5~10 秒 | 太短易误判,太长拖慢整体流程 |
| 读取超时 | 30~60 秒 | 按目标站点响应速度留余量 |
| 心跳间隔 | 30~60 秒 | 长连接保活,防止空闲被掐断 |
| 重试次数 | 2~3 次 | 配合退避使用,防止雪崩 |
| 重试间隔 | 指数退避 | 如 1秒 → 2秒 → 4秒 |
| 连续失败处理 | 换IP重试 | 同一IP连续失败就换新IP |
从源头减少断连:选稳定的代理服务商
如果排查完链路、调好参数,断连频率依然居高不下,那就要考虑代理服务本身的质量了。挑选服务商时重点看三点:IP资源的可用率、节点的带宽与并发承载能力、是否有技术支持协助定位问题。
以国内IP代理服务商天启HTTP为例,提供HTTP/HTTPS/SOCKS5多协议支持,高匿名接入,节点覆盖国内多个城市,IP资源池规模大、可用性有保障,适合数据采集、批量任务等对稳定性要求高的场景。实际使用中遇到断连问题,也可以结合本文的排查思路,联系天启HTTP的技术支持一起定位,比自己盲目换服务商高效得多。
常见问题
Q: 代理频繁断连一定是代理服务器的问题吗?
不一定。本地网络、代理链路、目标站点三段中任何一段出问题都会表现为断连。建议按"本地 → 代理 → 目标"的顺序分段排查,先排除本地WiFi和目标站点限流,再看代理本身。
Q: 超时时间设置得越长越保险吗?
不是。超时过长会让失败请求长时间占用连接资源,拖慢整体任务进度。正确做法是按目标站点正常响应速度留出2~3倍余量,同时配合重试机制兜底。
Q: 重连次数是不是设得越多越好?
不是。重试次数过多会在服务端故障时放大请求量,形成雪崩效应。建议2~3次并采用指数退避;如果连续重试仍失败,应换IP或触发告警,而不是无限重试。
Q: 长连接每隔几十分钟就断一次,是什么原因?
大概率是中间的NAT设备或防火墙回收了空闲会话。开启应用层心跳或TCP keepalive,把心跳间隔控制在30~60秒,让连接保持活跃,通常就能明显改善。
Q: 排查完本地和参数还是频繁断连怎么办?
保留断连时间点的报错日志和延迟记录,联系服务商协助定位。像天启HTTP这类提供技术支持的服务商,可以配合检查节点状态和IP质量,快速找到症结所在。