写Python爬虫最头疼的两件事:一是目标网站封IP,二是采集速度始终上不去。SOCKS5代理恰好能同时缓解这两个问题——它工作在更底层的会话层,比HTTP代理更通用、更干净,再配合合理的并发优化,采集效率和稳定性都能上一个台阶。这篇教程从零开始,先讲配置,再讲并发调优,手把手把SOCKS5代理用明白。
一、为什么Python爬虫偏爱SOCKS5代理
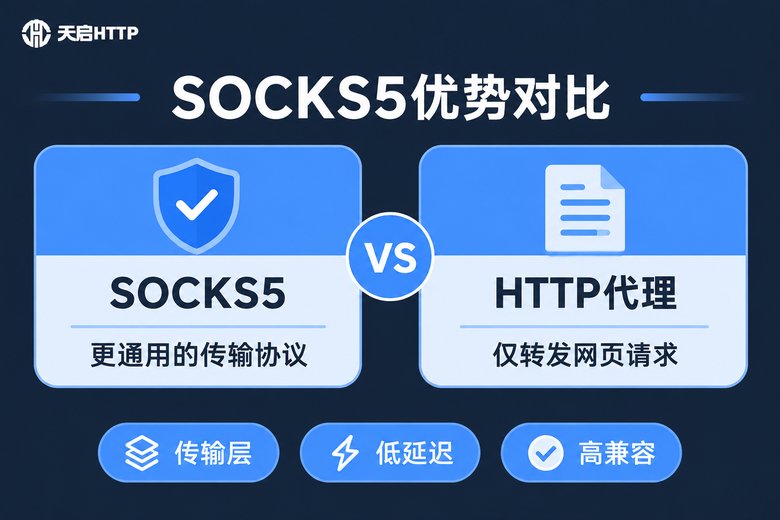
先搞清楚SOCKS5和HTTP代理的区别。HTTP代理工作在应用层,只能转发HTTP/HTTPS请求,代理服务器会"看懂"你的请求内容;而SOCKS5工作在会话层,只负责把数据包原样转发,不关心上层跑的是什么协议。对爬虫来说,这带来三个实际好处:
1. 协议通用:除了网页请求,SOCKS5还能承载各类TCP流量,一套代理方案可以覆盖多种采集任务,不用为不同协议单独准备代理。
2. 更难被识别:SOCKS5不修改请求头,不会像部分HTTP代理那样在头部留下代理痕迹,目标网站更难从请求特征上判断你在走代理。
3. 支持远程DNS解析:把socks5写成socks5h后,域名解析会在代理端完成,本地DNS解析慢或解析不准的问题就绕开了。
| 对比维度 | SOCKS5代理 | HTTP代理 |
|---|---|---|
| 工作层级 | 会话层,更底层 | 应用层 |
| 支持协议 | TCP/UDP,几乎通用 | 仅HTTP/HTTPS |
| 请求头处理 | 原样转发,不留痕迹 | 可能修改或添加头部 |
| 适用场景 | 爬虫、多协议客户端 | 网页浏览、简单抓取 |
二、Python中配置SOCKS5代理的完整步骤
第一步:安装依赖库
requests本身不直接支持SOCKS5,需要先装上PySocks:
pip install requests[socks]这条命令会同时安装requests和PySocks,装完才能识别socks5开头的代理地址。
第二步:基础配置
import requests

proxies = {
    "http": "socks5://用户名:密码@代理IP:端口",
    "https": "socks5://用户名:密码@代理IP:端口"
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())
如果代理不需要认证,直接写socks5://IP:端口即可。想让域名解析也走代理端,把socks5换成socks5h。
第三步:验证代理是否生效
# 返回的origin应该是代理IP,而不是本机宽带IP
print(resp.json()["origin"])
这是最容易被忽略的一步。很多"配了代理还是被封"的问题,根源就是代理根本没生效,出口IP其实还是本机。
第四步:异步场景接入aiohttp
后续要做高并发,推荐直接用aiohttp配合aiohttp-socks:
pip install aiohttp aiohttp-socksimport asyncio
import aiohttp
from aiohttp_socks import ProxyConnector
async def main():
connector = ProxyConnector.from_url("socks5://用户名:密码@代理IP:端口")
async with aiohttp.ClientSession(connector=connector) as session:
async with session.get("https://httpbin.org/ip") as resp:
print(await resp.text())
asyncio.run(main())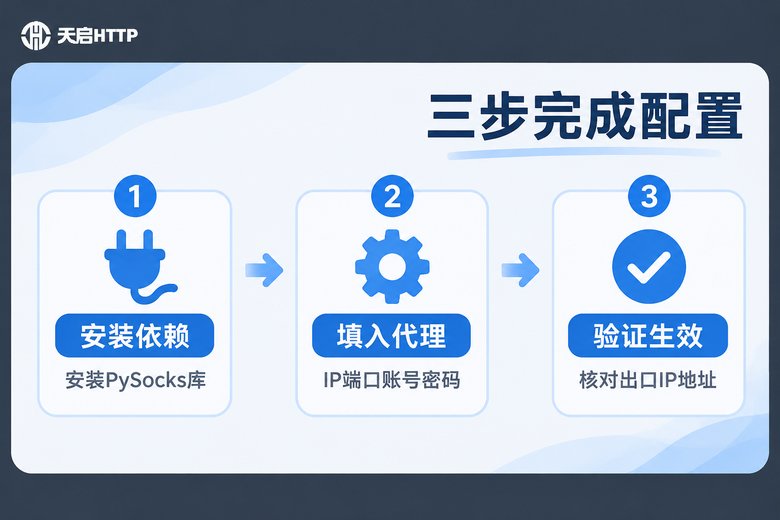
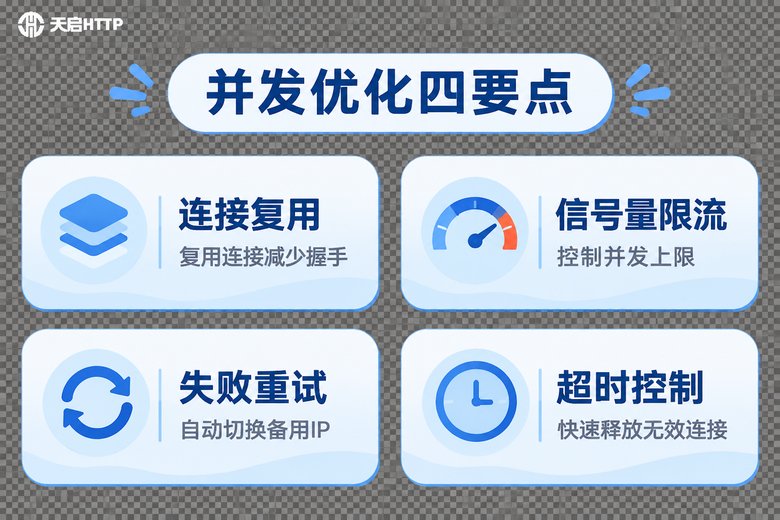
三、并发优化:让采集效率翻倍的五个技巧
配置好代理只是及格线,真正拉开差距的是并发调优。下面五个技巧按性价比排序,逐条落地即可。
技巧1:复用连接,别每次都重新握手
每次请求都新建TCP连接再做SOCKS5握手,开销非常大。用Session把连接复用起来,吞吐量立刻就能提升:
session = requests.Session()
session.proxies = proxies
# 后续所有请求都走同一个session,底层连接自动复用
技巧2:用信号量控制并发上限
并发不是越大越好。并发过高会触发目标网站限流,成功率反而下降。用asyncio.Semaphore给并发设一个上限:
import asyncio
import aiohttp
from aiohttp_socks import ProxyConnector

sem = asyncio.Semaphore(20)  # 最多20个并发任务

async def fetch(session, url):
    async with sem:
        try:
            async with session.get(url, timeout=aiohttp.ClientTimeout(total=10)) as resp:
                return await resp.text()
        except Exception:
            return None

async def main(urls):
    connector = ProxyConnector.from_url("socks5://用户名:密码@代理IP:端口")
    async with aiohttp.ClientSession(connector=connector) as session:
        results = await asyncio.gather(*[fetch(session, u) for u in urls])
    print(f"成功 {sum(1 for r in results if r)}/{len(results)}")

asyncio.run(main(urls))
技巧3:超时+重试+自动换IP
代理IP是有生命周期的,失败后自动切换下一个IP,才能保证长时间采集不断流:
import requests
import itertools

proxy_pool = itertools.cycle([
    "socks5://用户名:密码@IP1:端口",
    "socks5://用户名:密码@IP2:端口",
])

def fetch_with_retry(url, max_retry=3):
    for _ in range(max_retry):
        proxy = next(proxy_pool)  # 失败自动切换下一个IP
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=5,
            )
            if resp.status_code == 200:
                return resp
        except Exception:
            continue
    return None
技巧4:简单场景用线程池
不想写异步代码,线程池也能快速起量,几十行代码就能跑出不错的吞吐:
from concurrent.futures import ThreadPoolExecutor

with ThreadPoolExecutor(max_workers=20) as pool:
    results = list(pool.map(fetch_with_retry, urls))
技巧5:找到并发数的"拐点"
经验参考值:单IP并发10~20起步,有反爬的站点降到5~10,配合多IP轮换可以适当调高。判断标准永远是成功率和平均响应时间——一旦成功率下滑或响应时间陡增,说明并发已经超过IP承载能力,该降并发或换IP了,而不是无脑拉满。
四、选对代理服务商,优化才能事半功倍
并发优化的上限,其实由代理IP本身的质量决定。IP池小、响应慢、可用率低,代码写得再精致也白搭。这里推荐天启HTTP,一家国内IP代理服务商,对Python爬虫场景非常友好:
协议齐全:同时支持HTTP、HTTPS、SOCKS5,本文所有代码可以直接对接,不用改协议层逻辑。
自建机房:IP资源由自建机房统一管理,稳定性和响应速度都有保障,长时间挂采集任务更安心。
高并发承载:IP池规模大,批量任务、多进程并发采集不容易把IP"挤爆",配合信号量限流刚刚好。
API批量提取:提供API接口批量提取IP,方便在爬虫里做自动轮换、失败切换和失效剔除,正好衔接第三节的重试逻辑。
城市节点覆盖广:可以按需选择不同地区的出口IP,适配目标网站的地区访问策略。
接入方式也简单:拿到代理IP和端口后,按第二节的代码填进去就能跑。建议先用小并发测试一段时间的成功率和响应速度,确认质量稳定后再逐步放大并发数,这样整个采集链路会平滑很多。
常见问题
Q: 配置了SOCKS5代理,为什么查到的还是本机IP?
常见原因有三个:一是proxies字典的键写错,https请求必须配https这个键;二是没装PySocks,requests无法识别socks5地址;三是代理本身没生效。先执行pip install requests[socks],再打印返回结果核对出口IP,基本都能定位。
Q: socks5和socks5h有什么区别?
socks5h会把域名解析也交给代理服务器完成,本地不做DNS解析。当目标域名在本地解析慢或解析结果不准时,用socks5h更稳,爬虫场景一般建议优先用socks5h。
Q: 并发数设多少合适?
没有标准答案。经验值:单IP并发10~20起步,配合多IP轮换可以更高。判断依据是成功率和平均响应时间——两者任一明显恶化,就说明并发超过了当前IP的承载能力,应该降并发或补充新IP。
Q: 天启HTTP支持SOCKS5吗?适合爬虫吗?
支持。天启HTTP同时提供HTTP、HTTPS、SOCKS5协议,自建机房,IP池规模大、并发承载能力强,并提供API批量提取接口,适合Python爬虫的自动轮换场景。注意它是国内IP代理服务商,采集目标是国内网站时用它正合适。
Q: 代理IP经常失效怎么办?
把"提取IP→验证→入库→轮换使用"做成自动化流程,请求失败自动切换下一个IP,并定期剔除失效IP。配合天启HTTP的API批量提取接口和文中的重试逻辑,基本可以做到采集过程无感切换,不断流。