做爬虫的人大多踩过同一个坑:单机直连抓不了几百条就开始被限速、被封,临时去接一个代理接口,又要自己写换IP逻辑、维护IP池、处理失效重试,代码越写越乱,采集团队的大部分时间都花在"修管道"上。隧道代理IP就是用来解决这个问题的——你只需要填一个固定的代理地址,后面的换IP动作交给服务端自动完成。这篇文章把隧道代理的原理、在爬虫里的实际优势,以及完整的配置教程一次性讲清楚。
隧道代理IP是什么?和普通代理差在哪
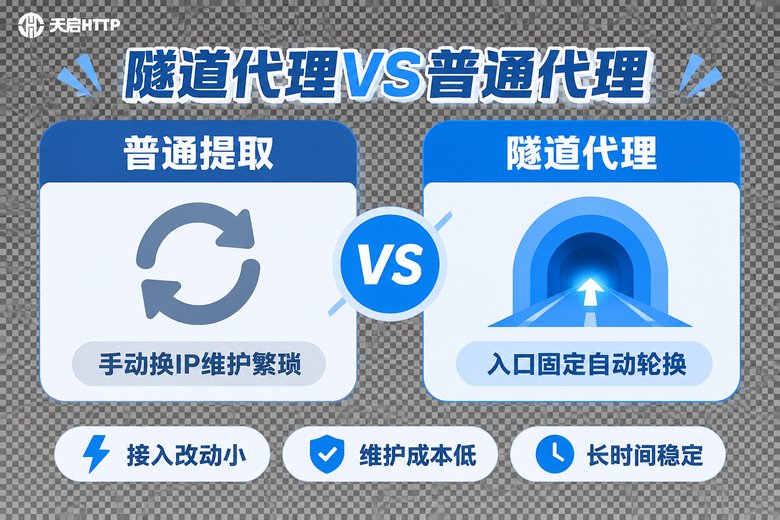
普通代理是"一个地址对应一个出口IP",你想要新IP,就得再换一个地址。而隧道代理提供的是一个固定不变的入口(域名或IP加端口),你每次请求都往这个入口发,服务端会把请求转发到不同的出口IP上,并按你设置的频率自动轮换。
打个比方:普通代理像自己一辆一辆去换车,隧道代理像走一条专用隧道,隧道那头每次派出的车都不一样,而你只需要记住隧道入口在哪。
| 对比项 | 固定代理IP | API提取代理 | 隧道代理IP |
|---|---|---|---|
| 换IP方式 | 不换,长期固定 | 自己调接口取新IP | 服务端按频率自动换 |
| 接入方式 | IP + 端口 | 每次拿一批新地址 | 一个固定入口地址 |
| 代码改动 | 小 | 需写换IP与校验逻辑 | 几乎不用改动 |
| 维护成本 | 低但容易被封 | 高,IP池要自己管 | 低,掉线重试即可 |
| 适合场景 | 少量稳定请求 | 中小规模、可控节奏 | 长时间、大规模持续采集 |
隧道代理在爬虫里的四大优势
第一,代码结构简单。你不用维护一个IP池对象,也不用写"取IP—校验—失败再取"的循环。代理地址是一个常量,写死在配置里就行,请求库原生的代理参数可以直接用。
第二,IP轮换不用你操心。目标站点按访问频次做限制时,隧道代理在服务端就完成了出口切换,你的请求节奏保持不变,触发风控的概率却明显下降。你可以自己设定切换的粒度,是按每次请求切换,还是按固定时间切换。
第三,并发更容易稳住。自己维护IP池时,并发一上去就会出现"好IP被抢完、坏IP反复重试"的情况。隧道代理的入口是统一的,并发压力由服务端分摊,本地只需要控制好线程数与超时时间。
第四,长期跑批更省心。爬虫真正难的不是跑通一次,而是连续跑一个月不出事。固定入口意味着你的配置文件不会天天变,日志格式统一,出问题时排查路径清晰。
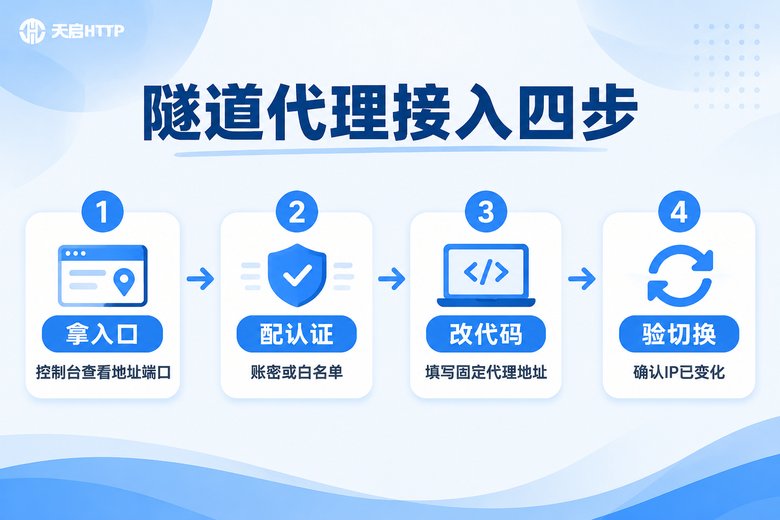
隧道代理配置教程:四步接入
下面以Python为例,把接入流程拆成四步。其他语言的思路完全一样,都是"设置代理地址 + 设置认证信息"。
第一步:拿到入口信息。在天启HTTP的用户中心找到隧道代理的入口地址与端口,同时确认认证方式是"用户名密码"还是"IP白名单"。如果是白名单,务必把运行爬虫那台机器的公网出口IP加进去,否则会一直返回认证失败。
第二步:确认认证参数。账密认证的格式是 http://用户名:密码@入口地址:端口,注意不要把冒号、@ 写错,密码里如果有特殊字符要做URL编码。
第三步:写进代码。用 requests 时把代理字典传给 proxies 参数;用 Scrapy 时写一个下载中间件统一注入。
第四步:验证切换是否生效。连续请求几次查询出口IP的接口,看返回的IP是否按预期变化。如果一直不变,先检查是不是开启了白名单但没生效,再检查切换频率的设置。
requests 示例
import requests

# 以下三项以天启HTTP控制台显示的信息为准
PROXY_HOST = "你的隧道入口地址"
PROXY_PORT = "你的隧道端口"
USERNAME = "你的用户名"
PASSWORD = "你的密码"

proxy_url = f"http://{USERNAME}:{PASSWORD}@{PROXY_HOST}:{PROXY_PORT}"
proxies = {"http": proxy_url, "https": proxy_url}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0 Safari/537.36"
}

for page in range(1, 11):
    url = f"https://你的目标站点.com/list?page={page}"
    try:
        resp = requests.get(url, headers=headers, proxies=proxies, timeout=10)
        print(page, resp.status_code, len(resp.text))
        if resp.status_code != 200:
            continue
    except requests.RequestException as e:
        # 隧道入口偶发超时,重试一次即可,不要在本地堆复杂的换IP逻辑
        print("请求异常:", e)
Scrapy 中间件示例
# middlewares.py
class TunnelProxyMiddleware:
    def __init__(self, proxy):
        self.proxy = proxy

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler.settings.get("TUNNEL_PROXY"))

    def process_request(self, request, spider):
        request.meta["proxy"] = self.proxy
# settings.py
TUNNEL_PROXY = "http://用户名:密码@隧道入口地址:端口"

DOWNLOADER_MIDDLEWARES = {
    "你的项目名.middlewares.TunnelProxyMiddleware": 543,
}

CONCURRENT_REQUESTS = 16      # 按套餐并发能力设置,不要盲目拉高
DOWNLOAD_TIMEOUT = 10
RETRY_ENABLED = True
RETRY_TIMES = 2
用隧道代理做爬虫,这几个坑要避开
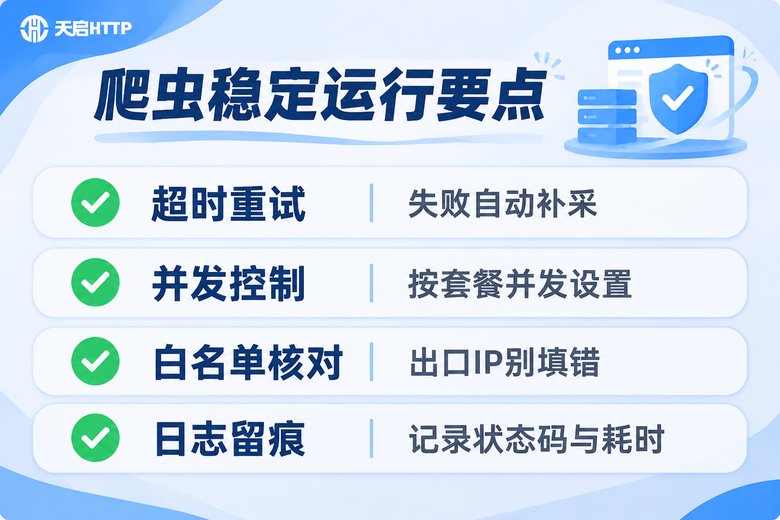
超时设得太长。隧道代理是转发链路,超时时间建议控制在10秒以内,配合1到2次重试。超时设到60秒,一个卡住的请求会拖慢整批任务。
并发开得比套餐高。每个隧道代理套餐都有对应的并发上限,本地线程数开得再大也不会更快,反而会大量返回失败状态码。先在控制台确认并发数,再把线程数控制在范围内。
只靠代理,不管请求特征。代理解决的是出口IP问题,不解决"请求太像机器"的问题。合理的请求头、适度的抓取间隔、静态资源按需关闭,这三件事照样要做。
没有日志。至少记录三个字段:状态码、耗时、重试次数。出问题时这三列能帮你快速判断是代理侧的问题还是目标站点侧的问题。
把代理密码写进代码仓库。用环境变量或配置文件读取,别硬编码提交上去。
为什么推荐天启HTTP隧道代理
天启HTTP是国内代理IP服务商,隧道代理是其主打的使用方式之一,适合需要长时间、稳定运行的国内数据采集任务。一个固定入口地址配好之后,出口IP的轮换由服务端完成,本地无需维护IP池;同时支持用户名密码认证与IP白名单两种接入方式,团队多人协作时可以按人分配账号,便于排查问题。
需要说明的是,天启HTTP的代理资源面向国内网络环境,适合抓取国内站点;如果你要访问境外网站,这套方案并不适用。另外它有并发与切换频率等参数配置项,具体数值与套餐信息请以官网和用户中心展示的为准,不要凭经验照搬别人的配置。
接入前建议先做一次小规模测试:拿100个左右的目标URL跑一遍,看成功率、平均耗时和失败原因分布。数据正常之后再放量,比一上来就开全量要稳得多。
常见问题
Q:隧道代理和普通API提取代理,我该选哪个?
看任务形态。短期、量小、目标站点限制不严,用API提取就够;需要连续跑几周甚至几个月,或者抓取频次高、目标站点限制明显,隧道代理更省事,代码也更干净。
Q:配好之后一直返回认证失败怎么办?
先确认认证方式。如果用白名单,检查运行爬虫机器的公网出口IP是否已加到白名单里,且没有变化;如果用账密,检查用户名密码是否有多余空格、密码特殊字符是否做了URL编码。
Q:为什么我感觉IP没有变化?
一是切换频率设置可能是按时间切换,短时间内连续请求仍走同一个出口;二是目标站点侧有连接复用。用查询出口IP的接口连续测试几次就能确认,不必靠猜。
Q:隧道代理能提高抓取速度吗?
它主要解决的是稳定性和IP轮换问题。速度取决于你的并发设置、目标站点的响应速度和本机网络,不要指望换个代理就翻几倍。
Q:能不能用隧道代理抓境外网站?
不能。天启HTTP的代理资源面向国内网络环境,用于境外站点抓取并不合适,请按实际业务场景选择合适的方案。
Q:一个隧道入口可以多台机器同时用吗?
技术上可以,但要注意总并发不要超过套餐上限,并且建议按机器或项目分开账号,出问题时能快速定位是哪台机器占满了并发。