短效代理池为什么需要"自己洗澡"
短效代理IP的特点是有效期短、更换频率高,一般几分钟到几十分钟就会失效换一批。这意味着你的代理池不是一潭静水,而是一条一直在流动的河:随时有新IP进来,也随时有IP悄悄死掉。
如果池子里没人管,问题会一个个冒出来:连不上的死节点越堆越多、同一个出口IP被重复录入好几次、部分节点其实会把你真实访问来源透传出去、还有些节点慢得离谱,一条请求要等好几秒。结果就是程序里充斥着无效重试,采集任务跑到一半卡住,你还在怀疑是不是自己的代码写错了。
所以成熟的代理池都会配两套机制:自动清洗负责把脏数据挡在池外,健康检测负责把池内的状态摸清楚。一个管入口,一个管存量,合起来就是代理池的免疫系统。
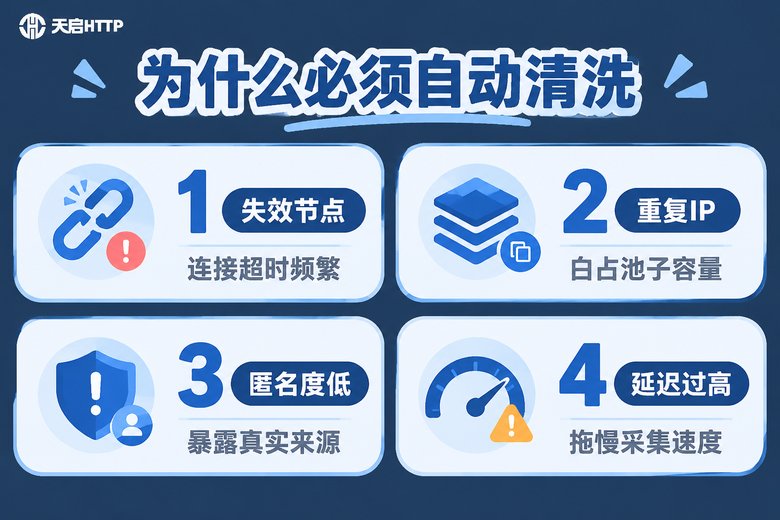
自动清洗机制:四个动作把脏数据拦在门外
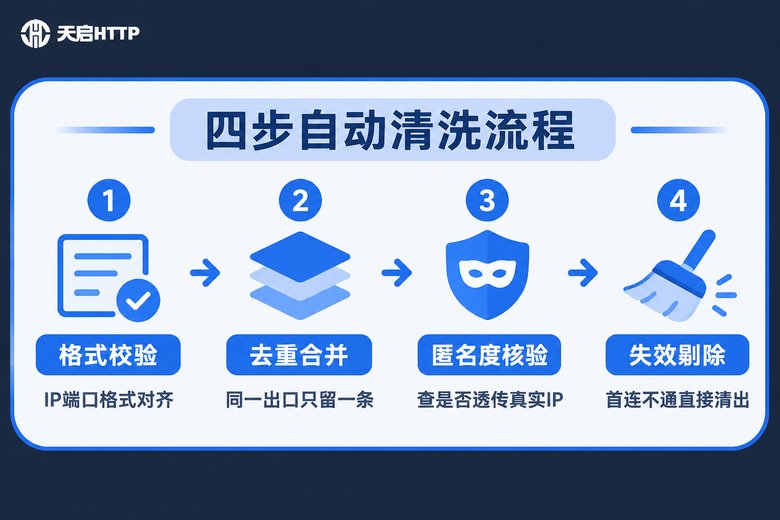
清洗发生在IP进入池子的那一刻,目标是"进池的每一条数据都是格式正确、内容不重复、性质符合要求的"。通常分四步走。
第一步,格式校验。代理IP的基本形态是「IP + 端口」,再叠加认证方式(账密或IP白名单)和协议类型。很多失效数据其实不是IP死了,而是抓回来的字符串里混进了空格、换行、多余的分隔符,解析的时候就该被拦下。这一步成本最低,却能挡掉一大半脏数据。
第二步,去重合并。短效代理池往往从多个渠道、多个提取链接同时拉取,同一个出口IP被重复录入是家常便饭。去重的键一般用「IP:端口」,如果同一个IP在不同来源里出现,保留更新时间较新的那条即可,别让同一个节点在池子里占两三份名额。
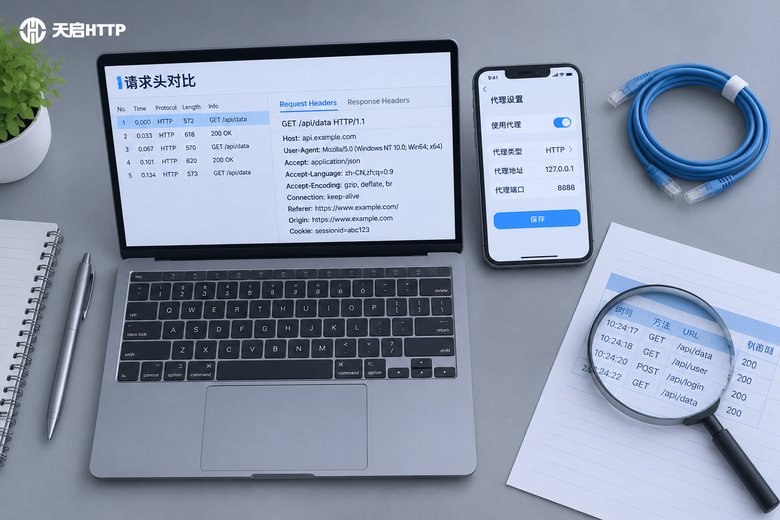
第三步,匿名度核验。这一步最容易被忽略。有些代理会在请求头里带上 X-Forwarded-For、Via 之类的字段,把真实的访问来源暴露给目标站点。清洗时需要实际发一次探测请求,看回显信息里有没有泄露,匿名等级不达标的直接不要。
第四步,失效剔除。入库前做一次"首连测试",连不通的、握手超时的、返回异常状态的,直接清出。这一步虽然要花一点时间,但能把后续大量的无效重试提前消灭掉。
触发时机也很关键:新数据入库时清洗一次、定时任务全量清洗一次、业务侧调用失败时把失败IP打回清洗队列。三种时机配合,池子才不会越用越浑。
健康检测机制:不光要知道"活没活",还要知道"好不好"
很多人的健康检测还停留在"能ping通就算健康",这远远不够。短效代理IP的生命周期本来就短,一个节点可能前一分钟还能用,后一分钟就废了;也可能一直能用,但延迟从 80ms 涨到 2000ms。所以检测结果不应该是一个"是/否"的开关,而应该是一个分数。
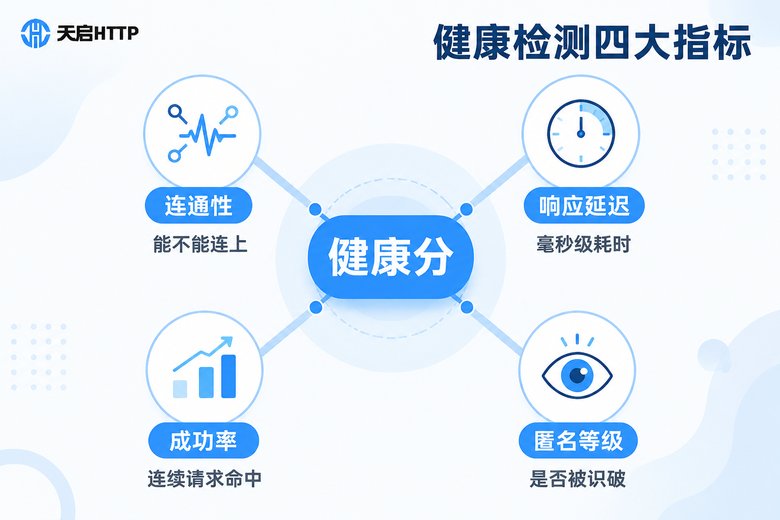
一个实用的健康检测至少看四个维度:
连通性——能不能通过这个代理成功建立连接并拿到响应。这是基础门槛,不通就直接出局。
响应延迟——从发出请求到收到响应的时间,单位毫秒。延迟越高,业务流程越慢,一般会设一个上限阈值,超过就降权。
请求成功率——不是测一次就算,而是连续发若干次请求,统计成功比例。单次成功可能是运气,连续稳定才是真健康。
匿名等级——目标站点能不能识别出这是代理、能不能看到真实来源。高匿名的节点才值得放进核心业务池。
检测频率上有个实用技巧:闲时全量、忙时抽样。业务低峰期把池子里的节点全测一遍,确保第二天上线时状态是准的;高峰期为了避免检测请求本身挤占带宽,改成随机抽样,再配合业务调用失败率的实时反馈做动态调整。
健康分与分级调度:让靠谱的IP多干活
检测数据出来后,就要让它发挥作用。常见的做法是给每个节点算一个 0 到 100 的健康分,然后把池子分成几层调度。
优选池:健康分高、延迟低、成功率稳的节点,优先分配给对稳定性要求高的任务。
可用池:分数中等,能干活但需要多盯着点。
观察池:连续几次检测表现不佳,暂时不接业务流量,定期复检。
淘汰池:连续失败达到阈值,直接从池中移除。
另外两个细节值得加上:一是熔断,单个节点在短时间内连续失败 N 次,立即停止调度,不等下一轮定时检测;二是半开恢复,观察池里的节点如果连续两次复检通过,可以放回可用池再试,避免一次网络抖动就把好节点永久判死。
| 观察指标 | 未做清洗与检测 | 接入自动清洗 + 健康检测 |
|---|---|---|
| 池内可用比例 | 通常只有六到七成 | 多数时间维持在九成以上 |
| 单任务无效重试次数 | 频繁,容易触发限流 | 明显减少,请求更集中有效 |
| 故障发现速度 | 靠业务报错,属于被动发现 | 定时检测提前发现,主动剔除 |
| IP 重复占用情况 | 常见,池容量被浪费 | 去重后一IP一条,容量用得实 |
| 运维投入 | 需人工查日志、手动删节点 | 机制自动运转,人工只做兜底 |
一套可参考的实现思路
机制听起来复杂,落到代码上其实不重。核心就是三个函数:清洗、检测、循环调度。下面是一段简化后的参考写法(伪代码,重点是思路)。
import time

# 1) 清洗:格式校验 + 去重
def clean_pool(raw_list):
    seen, cleaned = set(), []
    for item in raw_list:
        key = f"{item['ip']}:{item['port']}"
        if not valid_format(item):   # 格式不对,直接丢
            continue
        if key in seen:              # 已存在,跳过去重
            continue
        seen.add(key)
        cleaned.append(item)
    return cleaned

# 2) 检测:连通性 + 延迟 + 匿名度 -> 打分
def check_proxy(proxy, retry=3):
    ok_count, total_cost, anon = 0, 0, "unknown"
    for _ in range(retry):
        t0 = time.time()
        resp = try_request(proxy, timeout=5)   # 连续发多次,别只看一次
        if resp is not None:
            ok_count += 1
            total_cost += int((time.time() - t0) * 1000)
            anon = check_headers(resp)         # 看回显头是否暴露真实来源
    if ok_count == 0:
        return 0
    avg_cost = total_cost / ok_count
    score = 60 * (ok_count / retry)            # 成功率占 60 分
    score += 20 if avg_cost < 500 else 10      # 延迟占 20 分
    score += 20 if anon == "high" else 0       # 匿名度占 20 分
    return int(score)

# 3) 循环:定时全量检测,低分淘汰
def health_loop(pool, interval=300):
    while True:
        for item in list(pool):
            item["score"] = check_proxy(item["ip"] + ":" + str(item["port"]))
            if item["score"] < 40:
                pool.remove(item)              # 连续低分,清出池子
time.sleep(interval)实际落地时再加两点就会稳很多:一是把检测结果写进记录表(节点、时间、分数、延迟),方便回看趋势;二是把业务侧的失败回调接进检测队列,让真实使用中暴露的问题反过来推动检测,而不是只靠单向的定时探测。
自建还是选现成的代理服务
自建代理池的乐趣在于完全可控,但成本也摆在那:要维护清洗逻辑、要跑检测任务、要负担检测请求本身的流量,还要处理IP来源的持续更新。如果业务只是需要一个稳定的短效IP出口,直接选服务商往往更划算。
天启HTTP 是国内 HTTP 代理IP服务商,提供短效代理IP、独享代理、隧道代理等产品形态,支持 API 提取与账密/白名单认证,节点覆盖国内多个省市。短效代理IP本身的有效期较短,适合需要频繁更换出口IP的业务场景;服务侧在发放前会对节点做可用性筛选,相当于把一部分"基础清洗"前置掉了。接入方要做的,更多是结合自己的业务特点,在本地再加一层健康分调度。
常见问题
Q:短效代理池一定要做自动清洗吗,手动删不行吗?
短效IP的失效速度是按分钟算的,人工根本跟不上。手动删只适合节点数量很少、调用频率很低的场景,一旦上了量,自动清洗是必需品。
Q:健康检测多久跑一次比较合适?
没有固定答案,看IP的有效周期。如果一批IP大概十分钟就换,检测间隔就控制在几分钟级别;如果换得不频繁,可以拉长到十几分钟一次。全量检测尽量安排在业务低峰期。
Q:检测会不会消耗大量流量?
会有一定消耗,但可以通过"闲时全量、忙时抽样"和"缩小探测请求体"来控制。相对无效重试带来的浪费,检测消耗通常更划算。
Q:为什么检测通过的IP,实际用起来还是失败?
检测的是一次短请求,而真实业务可能有更高的并发、更长的连接时间或者更严格的目标站点风控。建议在健康分里加上业务侧的成功率反馈,让真实数据参与调度。
Q:匿名度检测具体看什么?
主要看请求经过代理后,目标站点能否从请求头里读到你的真实来源信息,比如有没有额外的转发字段被带出去。透传真实来源的节点不适合放进核心业务池。
Q:代理池做大之后,调度逻辑要注意什么?
重点是别让同一个IP在短时间内被反复压榨。可以在健康分之外再加一个"近期使用次数"的权重,优先分配给最久没被用过的优质节点。