做采集、做多账号运营的朋友,常常把注意力全放在IP上:IP换得勤不勤、是不是独享、城市对不对。但真正让请求被拦下的,往往不是IP本身,而是浏览器交出来的"技术档案"和代理链路交出来的"技术档案"对不上。这份档案里最典型的一项,就是TLS指纹。
什么是TLS指纹:握手那一刻,你就把自己介绍完了
访问一个HTTPS网站,浏览器和服务器之间要先"握手"(TLS握手),协商用什么协议版本、用哪套加密算法、支持哪些扩展。这个握手包里有大量细节:协议版本、加密套件的排列顺序、扩展字段的先后顺序、椭圆曲线参数、ALPN里声明支持HTTP/2还是HTTP/1.1……这些细节的组合,就构成了所谓的"TLS指纹"(业内常用JA3、JA4这类算法把它压缩成一个字符串)。
关键在于:真实浏览器的这套参数是固定的、有规律的。Chrome有Chrome的写法,Edge有Edge的写法,同一版本基本一致。而很多采集脚本、HTTP库、代理转发程序,握手参数是另一套完全不同的组合——它自己觉得"能连上就行",但在对方的风控系统看来,这就像一个人穿着正装却说着完全不同的口音,非常显眼。
所以真正需要检查的不是一个点,而是一条线:浏览器指纹 → 代理链路 → 目标服务器,三处信息必须自洽。这就是本文要讲的"链路一致性"。
指纹不一致会怎样:五类现场反应
很多人以为指纹不一致最多就是"偶尔失败一次",实际影响比想象中大得多。下面这几种现象,如果你在做采集或多账号业务,大概率遇到过,只是没往指纹上想。
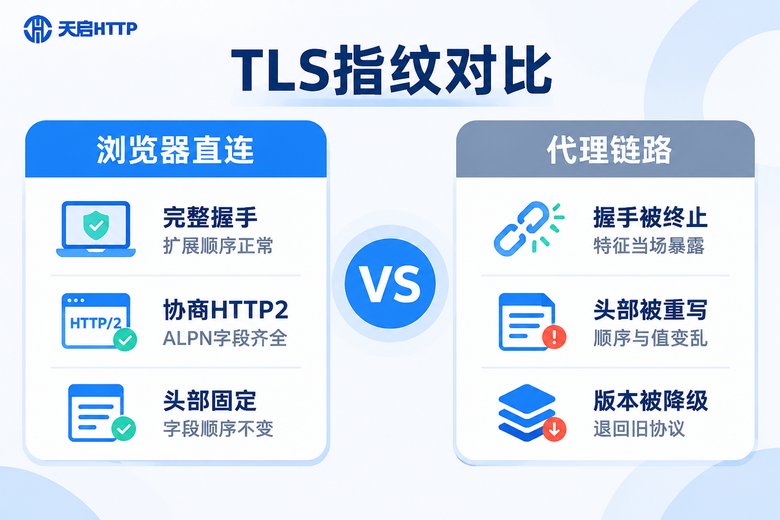
| 检查项 | 直连时的正常表现 | 链路异常时的表现 | 带来的后果 |
|---|---|---|---|
| TLS协议版本 | TLS 1.3 | 被降到TLS 1.2甚至更低 | 指纹特征异常,进入观察名单 |
| 加密套件顺序 | 与主流浏览器一致 | 顺序被打乱或整体替换 | JA3对不上,被判定为脚本 |
| HTTP/2协商 | ALPN正常协商h2 | 退回HTTP/1.1 | 头部特征与"浏览器"身份矛盾 |
| 请求头顺序 | 浏览器固定顺序 | 被代理重排、增删字段 | 一眼识破不是真人操作 |
| 时区与语言 | 与IP所在城市匹配 | 时区语言与IP归属地互相打架 | 行为风控命中,账号被降权 |
第一,直接被挡在门外。返回403、连接被重置、或者干脆给你一个永远加载不出来的空白页。这类是最干脆的,至少你立刻知道出问题了。
第二大麻烦是"假成功"。请求返回200,内容却是登录页、验证页、或者一份缺字段的空数据。你以为采到了,实际全是要清洗的垃圾,跑了一晚上才发现数据库是空的。
第三,验证码和滑块找上门。指纹不一致但又不至于直接封,对方就会给你加码验证。小规模还能人工过,规模一上来就彻底堵死。
第四,账号层面的连带风险。做店铺、做社媒矩阵的人最怕这个:IP换了、指纹没跟上,平台会把几个"指纹相同"的账号串在一起,一次判定,多个账号一起受影响。
第五,链路被限速。对方不封你,但把你的优先级调到最低,请求响应从几百毫秒变成几秒,采集效率断崖式下跌,你还找不到原因。
一致性检查怎么做:四步对照法
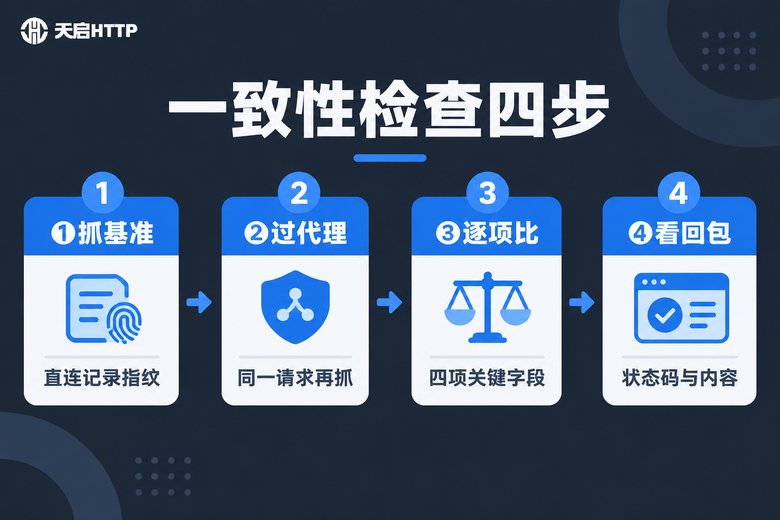
检查不需要多复杂的工具,核心思路就一句话:同一个请求,直连跑一遍、过代理跑一遍,把两次的技术参数摆在一起对照。
第一步,抓基准。不用代理,直接用你要模拟的浏览器或客户端访问一个能回显握手信息的测试地址,记录下协议版本、加密套件、是否协商h2、请求头的完整顺序。这份记录就是你的"标准答案",换设备换版本要重新抓。
第二步,过代理再抓一次。保持请求代码完全不变,只加上代理参数,用同一个测试地址再跑一次。
第三步,逐项比。重点盯四项:协议版本有没有被降级、加密套件和扩展顺序有没有变化、HTTP/2是否还能协商成功、请求头顺序有没有被重排。任何一项变了,链路就有问题。
第四步,看回包。参数一致的话,状态码、响应头、内容长度应该和直连基本一致。如果参数看着一样但回包明显不同(比如少了某些响应头、内容变短),那问题可能出在代理转发的中间环节。
import ssl
import socket
import requests

# 第一步:直连,记录握手基准参数
ctx = ssl.create_default_context()
with socket.create_connection(("测试站点域名", 443), timeout=10) as sock:
    with ctx.wrap_socket(sock, server_hostname="测试站点域名") as s:
        print("直连协议版本:", s.version())
        print("直连加密套件:", s.cipher())

# 第二步:同一个请求,加上代理再跑一次
proxies = {
    "http":  "http://用户名:密码@代理IP:端口",
    "https": "http://用户名:密码@代理IP:端口",
}
r = requests.get("https://测试站点域名/", proxies=proxies, timeout=10)
print("状态码:", r.status_code)
print("响应头数量:", len(r.headers))

# 第三步:把两次的协议版本、状态码、响应头逐项对比
# 第四步:参数一致后再看内容长度与关键字段是否完整
这段代码只是把"对照"这件事变成可执行的流程。真正要长期跑业务,建议把每次的比对结果落库,一旦某项指标连续异常就告警——指纹漂移往往是逐步发生的,等你肉眼发现时,通常已经损失了一批数据。
代理链路上最容易出问题的四个环节
一是TLS被"中途接管"。有些抓包工具、调试型代理为了看明文,会自己终结TLS再重新发起连接。这一终结一重建,客户端到代理是一套指纹,代理到目标站是另一套指纹,前后完全对不上。生产环境里做这类中间层改造,基本等于主动告诉对方"我是机器"。
二是HTTP代理被用来跑HTTPS。用HTTP代理转发HTTPS请求,很多客户端会在中间环节重写请求头、补字段、改顺序,甚至把HTTP/2降级成HTTP/1.1。浏览器的头字段顺序是有讲究的,被重排一次就露馅。这就是为什么做采集更推荐用支持HTTPS/隧道方式的代理。
三是IP特征与技术特征互斥。IP在广州,浏览器时区却是UTC、语言是英文、字体列表是精简版——这种矛盾比指纹本身更容易被识别。一致性不只是TLS层面,还包括时区、语言、分辨率、IP归属城市这一整套。
四是IP本身"太干净"或"太脏"。机房IP段天然带有特征,共享IP上还可能有别人留下的历史记录。同一个IP上刚被判定过的行为,会连累你接下来的请求。这类问题在廉价共享池里尤其明显,而在独享IP上会好很多。
让链路干净:天启HTTP的配合方式
把上面这些问题收一收,其实就两个要求:代理链路不要动你的请求特征,IP环境要稳定可控。天启HTTP作为国内代理IP服务商,在这两点上比较好配合:
· 独享IP:IP只给你一个人用,不会出现"别人把IP用脏了你接手"的情况,行为记录干净,适合多账号运营和长期采集任务。
· 隧道代理:请求按隧道方式转发,不需要你在代码里反复改代理地址,链路更稳定,也不容易在中途被重写请求特征。
· 全国多城市节点:可以按城市选IP,让IP归属地和你的时区、语言、业务区域保持一致,避免"地理信息打架"这种低级但致命的矛盾。
· API提取与高匿转发:可以按业务节奏取用IP,同时不把真实来源暴露给目标站,配合你自己的指纹校验脚本,能形成一套完整的一致性保障。
需要说明的是,天启HTTP提供的是国内代理IP,适合国内网站、国内平台相关的业务场景;如果你的业务对象在境外,那它并不适用。另外,链路一致性的最后一公里还是要靠自己:代理负责把IP和环境给稳,指纹和请求头的一致性,得由你的客户端代码来保证。
常见问题
Q:TLS指纹不一致,一定就是代理的问题吗?
不一定。要先直连抓一次基准。如果直连的指纹与你的浏览器版本本来就不匹配(比如你用的是脚本库而不是真实浏览器内核),那问题在客户端;只有在直连正常、过代理才变的情况下,才说明是链路改动了握手特征。
Q:我用的是HTTPS代理,为什么指纹还是对不上?
常见的两个原因:一是代理环节对请求头做了重排或增删;二是HTTP/2协商失败退回了HTTP/1.1。建议对比过代理前后的请求头顺序和协议版本,再看是否协商到了h2。
Q:指纹一致了,是不是就不会被封?
指纹只是众多信号之一。访问频率、访问路径、停留时长、IP的历史记录都会参与判定。指纹一致解决的是"身份自洽"问题,行为层面的合理性还得你自己控节奏。
Q:多账号运营为什么特别怕指纹串号?
因为平台做关联判定时,指纹是很重要的一条线索。多个账号如果指纹高度雷同、又来自同一批IP,很容易被归为一组。所以每个账号最好有独立的IP环境,配合各自匹配的浏览器参数。
Q:链路一致性需要多久检查一次?
建议在客户端或浏览器内核更新后必查一次,业务量大的情况下再按周做定期巡检。一旦出现"状态码正常但内容异常"的情况,第一时间把直连和过代理的两组参数拉出来对照,通常几分钟就能定位问题在哪一环。