很多人第一次接触代理IP,卡住的地方往往不是"要不要用",而是"拿到一串 IP 之后到底该怎么用"。买回来一堆地址和端口,填到代码里却连不上;或者能连上,跑了几分钟就被目标站点拦掉;再或者验证的时候没做,等到数据全跑完才发现一半请求是无效的。
这篇就把整条链路拆开讲清楚:选类型 → 提取IP → 验证可用性 → 写进代码或工具 → 上线后监控。跟着走一遍,基本不会踩大坑。
第一步:先想清楚用途,再决定拿哪种代理
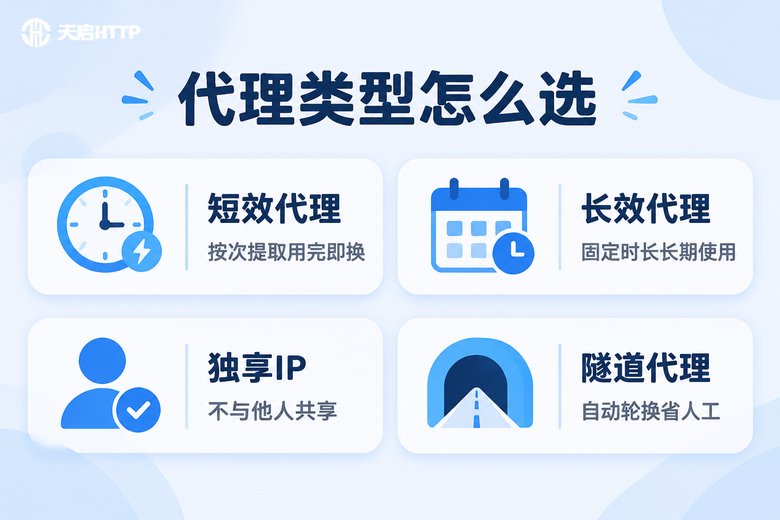
代理IP不是"一种东西",不同产品的行为差别很大。选错类型,后面所有操作都是白费力气。常见的几类:
| 类型 | 特点 | 适合的场景 |
|---|---|---|
| 短效代理 | 按次或按条提取,有效期短,用完即换 | 数据采集、批量查询、临时性任务 |
| 长效代理 | 一个IP可稳定使用较长时间 | 需要长期保持登录态的账号操作、挂机任务 |
| 独享代理 | IP不与他人共用,出口干净 | 对稳定性要求高、怕被邻居牵连的业务 |
| 隧道代理 | 只给一个固定入口,后端自动换IP | 不想自己写IP池调度逻辑的项目 |
判断标准很简单:任务跑多久、需要多少个不同出口、能不能接受中途断线。这三问答完,类型自然就出来了。如果你只是偶尔抓几个页面,短效代理足够;如果要长期维持某个账号的在线状态,就得考虑长效或独享。
第二步:把IP提取出来,两种认证方式要搞明白
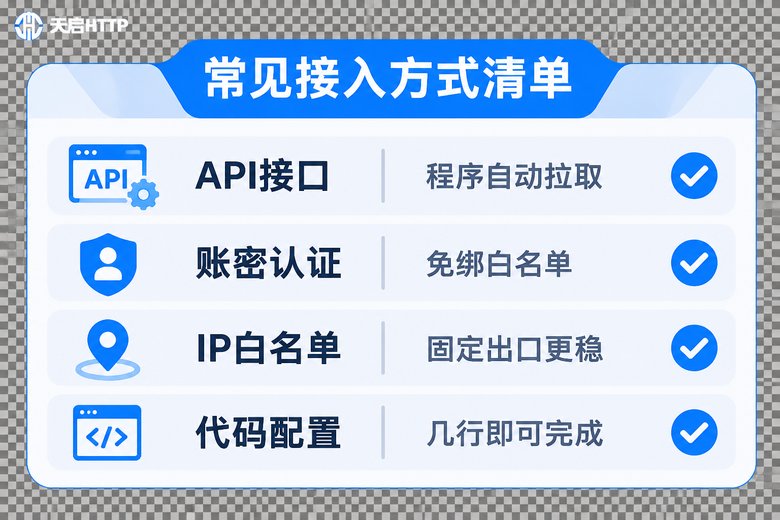
正规的代理服务商都会提供两种接入凭证方式,理解它们的区别能省下很多调试时间。
方式一:API 提取。调用一个接口,返回一批可用的 IP 和端口。适合写进程序里定时拉取。一般会返回结构化文本,形如 IP:端口 一行一条。你可以设定每次提取的数量、地区、是否需要去重。
方式二:账密认证。不用每次提取具体IP,直接用固定的入口地址加上用户名密码,服务端自动分配出口。写代码时把账号密码拼进代理地址里就行,最省事。
方式三:IP白名单。把你服务器的公网IP加到白名单,之后从这台机器发起的请求自动走代理,不需要在代码里带账号密码。缺点是换机器就得重新绑定。
小建议:单机调试用白名单最舒服,多机部署用账密认证最灵活,大批量任务用 API 提取 + 自己维护池子最可控。
第三步:拿到IP先验证,别直接往业务里灌
这一步最容易被跳过,也最容易出问题。至少验证三件事:
- 能不能通:用代理发起一次请求,看是否正常返回。
- 出口对不对:请求一个能回显客户端IP的接口,确认返回的IP就是代理IP,而不是你本机的IP(如果返回本机IP,说明代理根本没生效)。
- 快不快、稳不稳:连续发几次请求,看平均响应时间和失败率。
一个简单的验证脚本长这样:
import time
import requests

# 账密认证形式的代理地址
proxy = "http://用户名:密码@代理入口:端口"
proxies = {"http": proxy, "https": proxy}

ok = 0
cost = []

for i in range(5):
    start = time.time()
    try:
        # 换成任意可以回显客户端IP的接口
        r = requests.get("https://你的目标站点/ip", proxies=proxies, timeout=8)
        cost.append(time.time() - start)
        print("第%d次 返回:" % (i + 1), r.text[:80])
        ok += 1
    except Exception as e:
        print("第%d次 失败:" % (i + 1), e)

print("成功率: %.0f%%" % (ok / 5 * 100))
if cost:
    print("平均耗时: %.2f 秒" % (sum(cost) / len(cost)))
经验值参考:成功率低于 80%、平均耗时超过 3 秒的 IP,直接丢掉,硬着头皮用只会让后面的排错成本翻倍。批量验证时建议开多线程,但并发别太高,否则测出来的延迟不准。
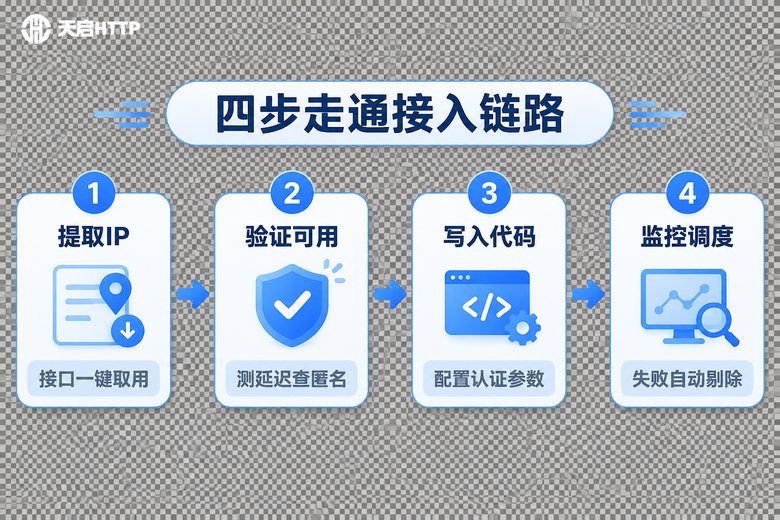
第四步:把代理写进代码和常用工具
验证通过之后就是接入。不同工具写法略有差异,但思路一致:把"代理地址 + 认证信息"塞到发起请求的地方。
Python requests:直接传 proxies 字典,http 和 https 都要写,否则部分请求会绕过代理。
Scrapy 爬虫:在 settings.py 里打开 HttpProxyMiddleware,然后通过 request.meta["proxy"] 给每个请求指定代理,配合自己的池子做轮换。
# settings.py
DOWNLOADER_MIDDLEWARES = {
    "scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": 110,
}

# spider 中给单个请求指定代理
def start_requests(self):
    for url in self.start_urls:
        yield scrapy.Request(url, meta={"proxy": "http://用户名:密码@代理入口:端口"})
浏览器自动化:启动时通过 --proxy-server 参数指定代理,需要账号密码的场景可以配合插件或扩展完成认证。
指纹浏览器 / 多账号管理工具:一般在"新建环境"页面有代理配置项,填入协议、地址、端口、账号、密码即可,每个环境绑定一个固定出口,账号之间不会串。
第五步:上线之后的监控和排错,才是长期活
接入完成不代表结束。真实业务跑起来后,最常见的三类问题和对策:
1. 请求超时变多。先看是单个IP的问题还是全池的问题。单个IP频繁超时就自动剔除;整池都慢,多半是并发开太高或者本地带宽打满了。
2. 返回内容异常(验证码、空页面、跳转登录)。说明这个出口已经被目标站点盯上了。降低单IP的请求频率,增加IP轮换的间隔,或者换用独享类产品。
3. 部分请求走了本地IP。检查代码里 http 和 https 是不是都设置了代理,以及有没有在异常重试时丢掉代理参数。
建议在程序里加两个简单的计数器:每个IP的请求次数和每个IP的失败次数。失败超过阈值就换掉,这条规则能解决八成的稳定性问题。
选服务商时,看这几点就够了
整条链路能不能跑顺,很大程度取决于底层IP的质量。天启HTTP 是国内 HTTP 代理IP服务商,提供短效代理、隧道代理、独享代理等多种产品形态,支持 API 提取、账密认证与 IP 白名单三种接入方式,可以直接对接上面讲的整套流程。
挑选时可以重点看:IP 是否干净可用(能不能稳定通过验证)、提取接口是否稳定(会不会频繁报错)、是否支持你要的接入方式、出问题能不能快速找到人。这四点比价格表上多几毛钱重要得多。
要提醒一句:天启HTTP 提供的是国内代理IP资源,如果你要做的是需要境外网络环境的业务,那不在它的适用范围内,别买错了方向。
常见问题
Q:代理IP设置好了,但请求返回的IP还是本机的,怎么回事?
先检查 http 和 https 是否都配置了代理;再确认代理地址里的协议头写的是 http:// 还是 socks5://,两者不能混;最后看代码里有没有在重试逻辑中把 proxies 参数丢了。
Q:一个IP能用多久?需要频繁换吗?
取决于产品类型和业务强度。短效代理本身有效期就短,按需提取即可;长效和独享类可以长时间使用,但如果目标站点已经开始给你弹验证码,就该主动换一个了。判断依据永远是"业务是否顺畅",不是固定时间。
Q:代码里应该用账密认证还是白名单?
单台服务器长期跑,白名单最省心;多台机器或者需要动态扩容,账密认证更灵活;如果是分发给不同程序使用,用 API 提取后自己维护池子最好管理。
Q:并发开多高合适?
没有标准答案,从低往高试。先跑 5 到 10 个并发,观察成功率和响应时间,稳定再逐步加。一上来就开几百并发,通常是IP被封得最快的方式。
Q:验证脚本有必要每次都跑吗?
建议做成定时任务。IP的可用状态是变化的,每天自动跑一遍验证、把不合格的剔除掉,比事后排查数据缺失要划算得多。