先搞懂:平台到底在靠什么判断你是"机器"
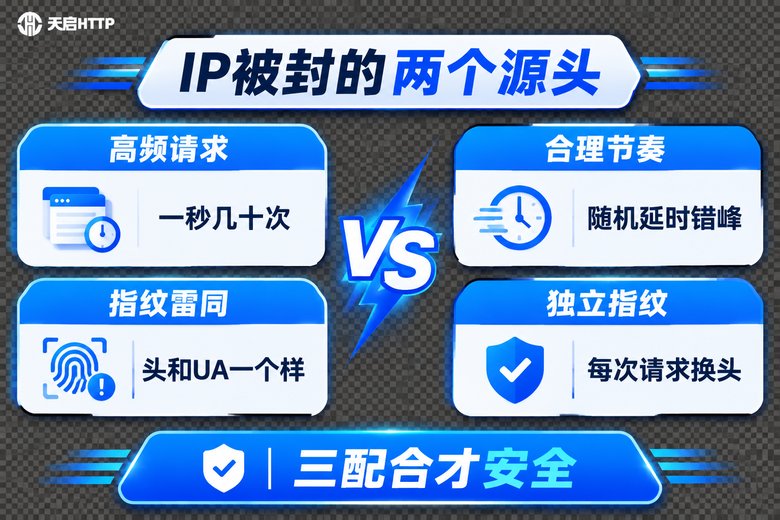
很多人一被封就以为是IP不行,其实大部分时候,IP只是压垮骆驼的最后一根稻草。平台的风控系统从来不会只看一个指标,它会把三类信号叠在一起判断:你的请求是不是太规律(节奏)、你从同一个IP身上薅了多少次(频率)、你的请求长什么样(指纹)。
三样里只要有两样露馅,风控就会给你打上"可疑"标签;三样全露馅,基本就是直接封IP加封账号。反过来说,只要这三样配合得当,即使你用的不是最贵的IP,也能跑得很稳。这就是"三配合"的核心逻辑:不是让某一个环节做到极致,而是让三个环节互相兜底。
下面我们按节奏、频率、指纹的顺序拆开讲,最后给出可直接复用的代码写法。
节奏:让请求像真人一样"呼吸"
机器和真人最大的区别不是速度,而是规律性。固定每 100 毫秒发一次请求,比每秒发 10 次更容易被发现,因为它太"整齐"了。
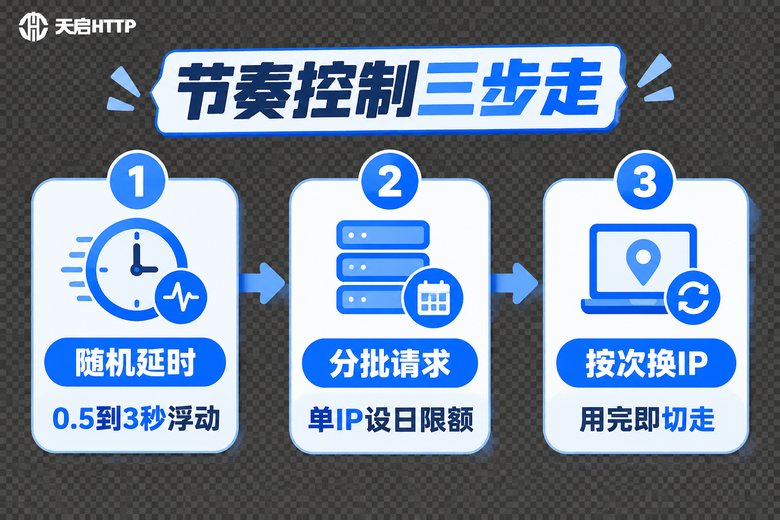
正确的做法是给请求间隔加随机浮动。比如基准间隔 1.5 秒,实际执行时在 1.0~3.0 秒之间随机取值,模拟真人翻页时快时慢的节奏。同时还要注意两点:
一是错峰。不要在整点、半点集中开跑,把任务分散到一天的不同时段,夜间和白天的请求量也要有差别。二是留出停顿。真人不会连续翻 200 页不停手,每跑几十个请求插入一次 10~30 秒的休息,能显著降低被标记的概率。
频率:单个IP的承受上限怎么定
频率说的是"同一个IP在单位时间内被用了多少次"。这里没有万能数字,因为它和网站规模、反爬强度、IP的纯净度都有关。但可以给一个大致的参考区间,你先按保守值跑,稳定了再逐步提高。
| 采集目标类型 | 建议单IP间隔 | 单IP日请求量参考 | 备注 |
|---|---|---|---|
| 商品列表页 | 1~3 秒 | 3000~8000 次 | 页面轻,可适当加密 |
| 商品详情页 | 2~5 秒 | 1500~4000 次 | 反爬普遍较严 |
| 搜索 / 筛选接口 | 5~10 秒 | 500~1500 次 | 最容易触发验证码 |
| 公开数据/资讯页 | 1~2 秒 | 5000~10000 次 | 可配合缓存减少请求 |
关键点是给每个IP设一个"用量上限":比如单IP累计跑满 300 次请求就主动换下一个,而不是等它被封了才换。主动轮换的成本,远低于被封后重新调试的成本。用固定长效的独享IP做高频任务时,这个上限意识尤其重要。
指纹:请求头要成套地换,不能只换一半
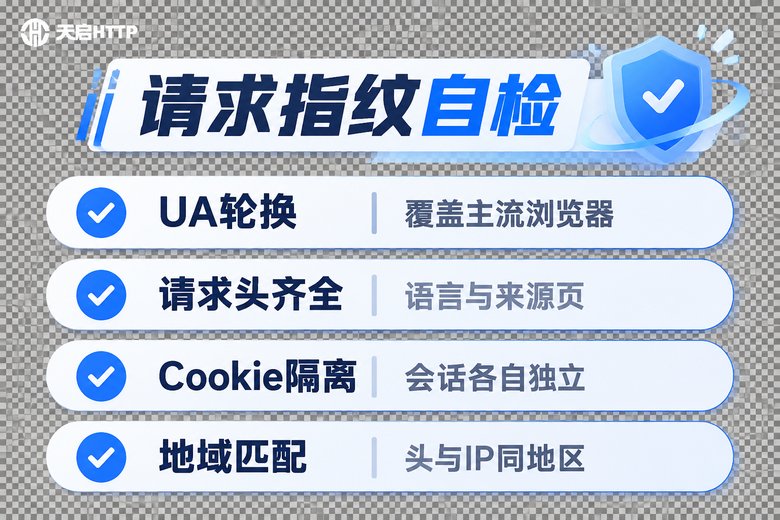
很多人换IP换得很勤,但请求头永远是那一套,结果照样被封。因为风控看到的是:IP来自全国各地,但User-Agent、语言、屏幕参数全都一模一样,这种"人格分裂"比不换IP更可疑。
指纹配合要做到三件事:一是User-Agent 与其它请求头成套匹配,用了 Chrome 的UA就带上对应的 Accept、Accept-Language、Sec-CH-UA 等字段,别用一套残缺的头去冒充新版浏览器;二是地域要匹配,IP在上海,语言头却写繁体中文,就很扎眼;三是Cookie 与会话隔离,不同IP对应的会话不要串用同一份登录态。
如果任务对隐蔽性要求更高,还要注意 TLS 指纹和浏览器指纹层面的一致性。用 requests 这类库时,底层握手特征本身就比较"工具化",所以频率更要压低;如果目标站点风控很严,改用真实浏览器内核去跑会更稳妥,但资源消耗也更高,需要自己权衡。
三配合怎么落地:一段可复用的写法
把节奏、频率、指纹串起来,代码其实不复杂。下面这段示例展示了基本的组合思路,提取链接替换成你自己的即可:
import random
import time
import requests

# 天启HTTP的API提取链接,换成你自己的即可
API_URL = "<你的天启HTTP提取链接>"

# 指纹池:UA与配套请求头成套准备,不要只换UA
HEADER_POOL = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9",
        "Accept": "text/html,application/xhtml+xml",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                      "Version/17.0 Safari/605.1.15",
        "Accept-Language": "zh-CN,zh-Hans;q=0.9",
        "Accept": "text/html,application/xhtml+xml",
    },
]

IP_USAGE_LIMIT = 300        # 单IP用量上限,跑满主动换
counter = {"proxy": None, "used": 0}

def fetch_proxy():
    resp = requests.get(API_URL, timeout=10)
    return resp.text.strip()

def get_proxies():
    # 达到上限就主动换IP,不要等被封
    if counter["proxy"] is None or counter["used"] >= IP_USAGE_LIMIT:
        counter["proxy"] = fetch_proxy()
        counter["used"] = 0
    counter["used"] += 1
    p = counter["proxy"]
    return {"http": p, "https": p}

def crawl(url):
    # 节奏:随机间隔 + 偶尔长停顿
    time.sleep(random.uniform(1.2, 3.5))
    if random.random() < 0.05:
        time.sleep(random.uniform(10, 30))

    headers = random.choice(HEADER_POOL)
    try:
        r = requests.get(url, headers=headers,
                         proxies=get_proxies(), timeout=15)
        return r.status_code, r.text
    except Exception as e:
        counter["used"] = IP_USAGE_LIMIT   # 出错立刻换IP
        return None, str(e)
这段代码里,随机延时负责节奏,用量上限负责频率,随机请求头负责指纹,三者互相配合。实际跑任务时建议再加一层日志,把每个IP的成功率、验证码触发率记录下来,哪一批IP质量差一眼就能看出来,方便及时更换提取策略。
选对IP池,三配合才有意义
再好的策略,架在质量差的IP池上也白搭。如果一批IP本身已经被大量滥用、被很多站点拉黑,那你的节奏再怎么随机、指纹再怎么换,开局就已经输了。
这也是为什么做国内数据采集时,很多人会选天启HTTP这类国内代理IP服务商。它的定位很明确:只做国内IP资源,支持 HTTP / HTTPS / SOCKS5 协议,提供短效动态IP、长效静态独享IP和隧道代理几种形态,都带高匿特性,可通过API批量提取,覆盖国内多个城市节点。对"三配合"来说,这几点是实打实的加分项:
第一,独享静态IP不会被别人拖着走,你用的IP只属于你,纯净度可控,节奏和频率才好规划;第二,API提取方便做主动轮换,配合上面代码里的用量上限逻辑,可以做到"用满即换"而不是"被封才换";第三,隧道代理自带自动切换,适合那些不想自己管理IP池、只想专注采集逻辑的场景;第四,城市节点可选,需要让请求来源地和目标业务区域对得上时,这一点很关键。
常见问题
Q:用了代理IP还是被封,最先该排查什么?
先看指纹,再看节奏。打开请求日志,确认不同IP发出的请求头是否真的不一样。如果UA、语言头高度雷同,先修这个,往往立竿见影。
Q:请求间隔调得越慢就越安全吗?
不是。过慢反而不符合真人浏览的分布,而且效率极低。关键是"随机"而不是"慢",让间隔在一个合理区间内浮动,配合偶尔的长停顿,效果比一味拉长间隔好得多。
Q:动态短效IP和长效静态独享IP该怎么选?
看任务性质。请求量大、目标站点反爬严格、需要频繁换来源的,用短效动态更合适;需要稳定登录态、需要长期保持同一身份操作的,用长效静态独享更合适,搭配较低的请求频率效果最好。
Q:一个IP一天跑多少请求比较安全?
没有统一答案,建议先按文章表格里的保守值跑,连续观察几天成功率,成功率稳定在 95% 以上再逐步上调。一旦发现验证码触发率上升,立刻回调并缩短单IP用量上限。
Q:指纹里最容易被忽略的是哪一项?
地域一致性。很多人IP换了城市,语言头、时区、部分客户端参数还停在原地,风控一比就露馅。换IP时顺手把语言和时区参数一起对齐,成本很低但收益很高。
Q:天启HTTP支持哪些使用方式?
支持API提取、账密认证等方式接入,协议覆盖 HTTP、HTTPS、SOCKS5,动态短效、静态独享、隧道代理几种形态都有,可以直接对接上面示例里的 requests 写法,也可以配置到采集框架或指纹浏览器中使用。具体以官网说明为准。