做过数据采集、多账号运营或者自动化测试的人,基本都会遇到同一个问题:从服务商那里提取回来一批IP,真正跑起来的时候,总有一部分连不上、超时、或者跑几十次就挂了。如果不做验证直接扔进业务里用,最终的表现就是任务大面积失败、日志里全是异常、排查半天发现是IP本身的问题。
所以,一套完整的代理IP使用链路应该是三件事:批量校验 → 失败重取 → 结果落库。这篇文章把这三步拆开讲清楚,附上可以直接改一改就用的代码和表结构。
一、先想清楚:验证到底在验什么
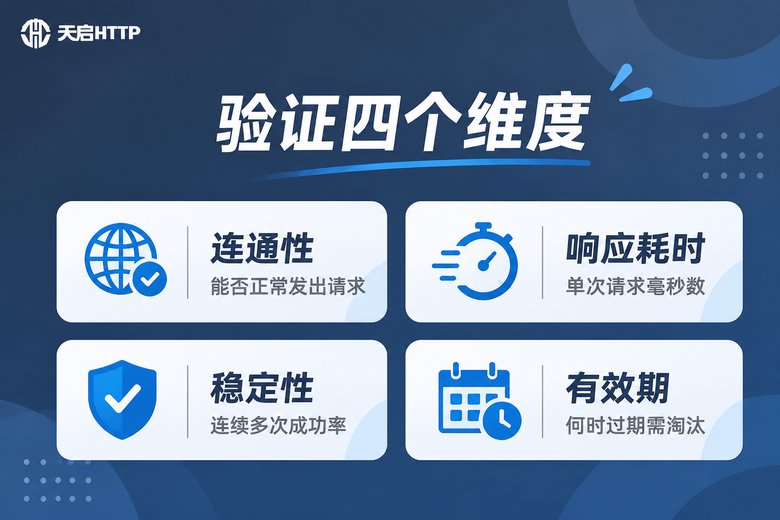
很多人说的"验证",其实只是 ping 一下或者随便发个请求看通不通。这远远不够。一个IP能不能用,至少要同时看四个维度:
| 维度 | 判断方式 | 不合格的表现 |
|---|---|---|
| 连通性 | 通过代理访问一个轻量校验地址 | 连接被拒绝、握手失败 |
| 响应耗时 | 记录从发起到返回的总毫秒数 | 动辄几秒,拖慢整批任务 |
| 稳定性 | 同一IP连续探测 2~3 次 | 第一次成功,第二次就挂 |
| 有效期 | 比对提取时间与IP类型 | 任务跑到一半IP已过期 |
这四个维度组合起来,才能判断一个IP是"能用"、"能凑合用"还是"该淘汰"。像天启HTTP提供的短效代理、隧道代理、独享IP等不同类型的代理,有效期和并发特性不一样,验证时的判定阈值也要跟着调整,不能一套参数走到底。
二、批量校验:慢不是问题,乱才是
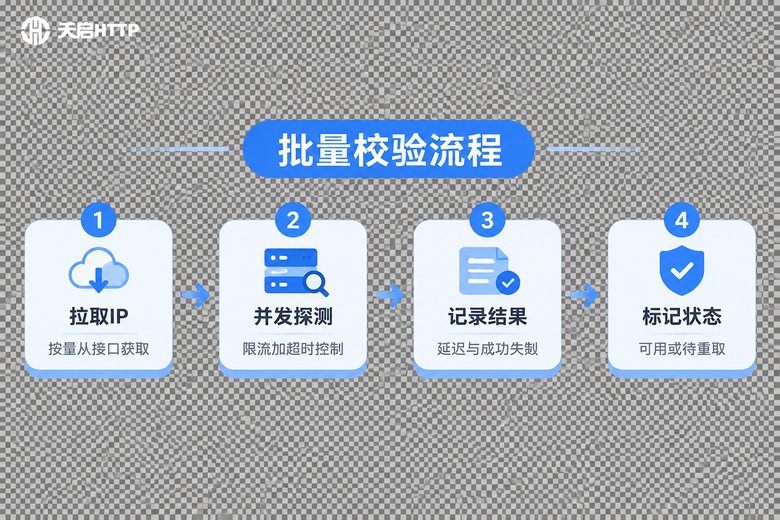
批量校验最容易踩的坑不是"验证不准",而是"验证本身把机器和网络搞崩了"。几百上千个IP同时开请求,本机端口被占满、路由器被打爆,最后所有IP都显示失败,看起来像全军覆没,其实是被自己的验证程序拖垮的。
建议按下面几条来设计:
1. 校验地址要轻。不要拿业务目标站当校验地址。一方面慢,另一方面频繁请求容易触发目标站的风控,让本来能用的IP被误判。用一个返回体积很小、能回显请求来源的轻量接口最合适。
2. 并发要限流。用信号量控制同时进行的校验数量,一般控制在几十的量级,具体看本机带宽和目标站承受能力。并发越高,单个请求的耗时也越高,误判率反而上升。
3. 超时要分开设。连接超时和读取超时要分别设置。连接超时短一点(3 秒左右)能快速筛掉死IP,读取超时可以稍长一点,避免把网络稍慢但可用的IP误杀。
4. 一次失败不算失败。至少探测 2 次再下结论。很多节点是瞬时抖动,第一次失败第二次就通了。
import asyncio
import time
import aiohttp

# 换成你自己的轻量校验地址,越小越好
CHECK_URL = "https://your-check-endpoint.example.com/ping"
TIMEOUT = aiohttp.ClientTimeout(total=8, connect=3)

async def check_one(session, proxy):
    """校验单个代理,返回 (代理, 是否成功, 耗时毫秒)"""
    start = time.time()
    try:
        async with session.get(
            CHECK_URL,
            proxy=f"http://{proxy}",
            timeout=TIMEOUT
        ) as resp:
            await resp.read()
            cost = int((time.time() - start) * 1000)
            return proxy, resp.status == 200, cost
    except Exception:
        cost = int((time.time() - start) * 1000)
        return proxy, False, cost

async def batch_check(proxies, concurrency=50, retry=1):
    """批量校验,失败的最多重试 retry 次"""
    sem = asyncio.Semaphore(concurrency)

    async with aiohttp.ClientSession() as session:
        async def run(proxy):
            async with sem:
                result = await check_one(session, proxy)
                tries = 0
                while not result[1] and tries < retry:
                    await asyncio.sleep(0.5)
                    result = await check_one(session, proxy)
                    tries += 1
                return result

        return await asyncio.gather(*(run(p) for p in proxies))

# 用法
# results = asyncio.run(batch_check(proxy_list, concurrency=50))
这段代码的核心就两点:信号量控并发 + 失败重探一次。看起来简单,但能挡掉大部分误判。
三、失败之后:什么时候重取,什么时候直接扔
校验失败并不意味着要立刻去找服务商重取。重取是有成本的:一是消耗提取频率,二是新取回来的IP也得再校验一遍,等于多跑一轮。所以要先判断失败类型。
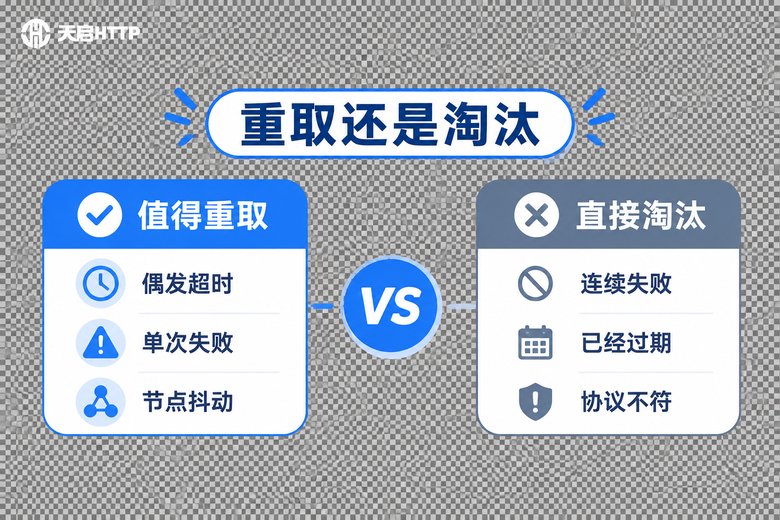
值得重取的情况:单个IP偶发超时、节点瞬时抖动、第一次探测失败但重探成功。这类问题靠重试就能解决,没必要惊动提取接口。
直接淘汰的情况:同一IP连续 3 次以上失败、已超过有效期、协议不匹配(比如业务需要 SOCKS5 但拿到的是 HTTP)。这些属于确定性问题,重试一万次也没用,直接标记淘汰并从池子里移除。
什么时候触发整体重取:当池子里的可用IP数量低于业务所需的阈值时,才去调用提取接口补充。不要每失败一个就取一个,那样提取频率会失控。
另外重取要有退避机制。第一次补充失败后等几秒、再等十几秒、再等更久,避免在服务端本来就繁忙的时候疯狂重试。天启HTTP的提取接口支持按量获取,配合本地池子的水位触发,比定时无脑拉取要稳得多。
四、结果落库:不落库的验证等于没验证
校验结果一定要存下来,否则你永远不知道自己池子的真实质量:可用率多少、平均延迟多少、哪一批IP淘汰最快。这些数据是后续调优的唯一依据。
表结构不用复杂,但下面这些字段建议都留着:
| 字段 | 作用 |
|---|---|
| ip + port + protocol | 联合主键,保证同一个IP不会重复入库 |
| latency_ms | 最近一次校验的耗时 |
| ok_count / fail_count | 累计成功与失败次数,用来算可用率 |
| status | 待校验 / 可用 / 待重取 / 已淘汰 |
| fetched_at / expire_at | 提取时间与过期时间,用于定时清理 |
| checked_at | 最近一次校验时间,避免重复校验 |
CREATE TABLE proxy_pool (
  ip          VARCHAR(64) NOT NULL,
  port        INT         NOT NULL,
  protocol    VARCHAR(10) NOT NULL DEFAULT 'http',
  latency_ms  INT         DEFAULT NULL,
  ok_count    INT         DEFAULT 0,
  fail_count  INT         DEFAULT 0,
  status      TINYINT     DEFAULT 0,  -- 0待校验 1可用 2待重取 3已淘汰
  fetched_at  DATETIME    DEFAULT NULL,
  checked_at  DATETIME    DEFAULT NULL,
  expire_at   DATETIME    DEFAULT NULL,
  PRIMARY KEY (ip, port, protocol)
);
写入时用幂等的方式,避免同一个IP被反复插入成多条:
INSERT INTO proxy_pool
  (ip, port, protocol, latency_ms, ok_count, fail_count, status, checked_at)
VALUES
  (%s, %s, 'http', %s, %s, %s, %s, NOW())
ON DUPLICATE KEY UPDATE
  latency_ms  = VALUES(latency_ms),
  ok_count    = ok_count   + VALUES(ok_count),
  fail_count  = fail_count + VALUES(fail_count),
  status      = VALUES(status),
  checked_at  = NOW();
校验成功时传 ok_count=1, fail_count=0, status=1,失败时反过来传,一条语句就能同时完成新增和更新,不用先查再写。
落库之后还要做两件收尾的事:定期清理(把已淘汰和已过期的记录删掉或归档,避免表越滚越大)和定期统计(按小时或按天算一次可用率与平均延迟,画成曲线)。当你在监控面板上看到某个时间段的可用率突然掉下去,就知道该去查上游节点或者调整阈值了。
五、把三步串成一条稳定链路
完整的节奏其实是一个循环:定时从接口拉取一批IP入池 → 并发批量校验 → 成功标记可用、失败进入待重取 → 可用数低于水位时触发重取 → 所有结果写回数据库 → 统计报表反馈调优。每一环都不复杂,难的是把参数调稳。
最后给三条实践经验:
1. 阈值别定太死。延迟阈值一开始可以放宽,跑几天有了数据再收紧,否则会误杀大量能用的IP。
2. 状态要能回退。标记为可用的IP在后续业务失败时,也要能重新回到待校验状态,形成闭环。
3. 日志留够信息。每次校验至少记录IP、耗时、成功与否、异常类型。出问题的时候,这几列能帮你快速判断是IP坏了还是程序写错了。
代理IP本身是消耗品,真正决定业务稳定性的,是你对这批消耗品的管理能力。选一个提取稳定、类型齐全的服务商是前提,天启HTTP提供的短效代理、隧道代理与独享IP可以覆盖不同的业务节奏;而把校验、重取、落库这套流程搭好,才是让这些IP真正跑得动的关键。
常见问题
Q:每次提取回来的IP都要全部校验一遍吗?
建议首次进入池子的IP都校验一次,这是成本最低的过滤。后续可以只对超过一定时间未校验、或者业务侧刚失败过的IP做复检,节省资源。
Q:校验并发开多少合适?
没有固定答案。一般从 30~50 开始试,观察单请求平均耗时有没有明显上升、本机网络有没有被打满。如果耗时随并发升高而暴涨,说明开太大了,降下来反而整体更快。
Q:为什么有的IP第一次校验成功,实际用起来却失败?
最常见的原因是校验地址和业务目标地址不一样。有些IP访问轻量接口没问题,访问具体业务站时会因为风控、协议差异或者地区线路而失败。条件允许的话,校验地址尽量贴近真实业务场景。
Q:重取频率应该怎么控制?
用"池子水位"来触发,而不是固定时间。可用IP数量低于业务所需阈值时才去补充,同时给补充动作加上退避等待,防止在异常情况下把提取接口打爆。
Q:数据库里的历史校验记录要一直留着吗?
不需要。明细记录保留最近几天足够排查问题,更早的数据可以只保留按天聚合的统计结果,既能看趋势,又不会让表无限膨胀。