先搞清楚:代理IP是怎么“暴露”的
很多做数据采集的朋友都遇到过这样的场景:明明已经挂上了代理IP,爬虫跑得好好的,突然之间验证码满天飞、403接连不断,IP池的消耗速度肉眼可见地加快。这时候大多数人的第一反应是“IP质量不行”,于是疯狂换IP、扩IP池,结果问题依旧。
其实,目标网站的反爬系统从来不是只看IP这一个维度。IP只是你的“门牌号”,而指纹和行为特征才是你的“长相和走路姿势”。门牌号换了,长相没变,照样会被认出来。
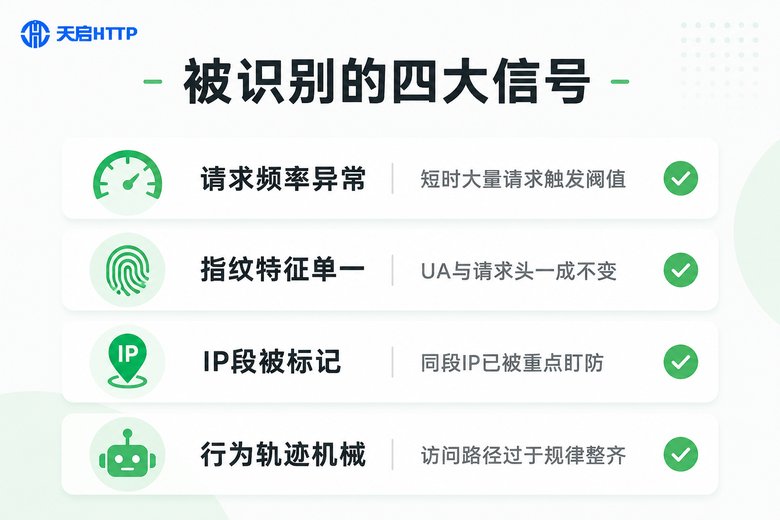
具体来说,常见的识别信号有这几类:
1. 请求频率异常。同一个IP在几秒内发出几十个请求,远超真人点击浏览的速度,风控系统直接拉响警报。
2. 指纹特征单一。User-Agent、请求头组合一成不变——成千上万个“不同IP”却长着同一张脸,这在风控眼里就是同一个爬虫。
3. IP段被标记。某些IP段被大量爬虫反复使用过,早已进入重点监控名单,新IP一上线就自带“前科”。
4. 行为轨迹机械。访问路径完全一致、间隔精确到毫秒、从不加载图片和静态资源,这种“太整齐”的访问模式本身就是最大的破绽。
用一张表对比真人和机械爬虫的区别,你会更直观:
| 维度 | 真人访问 | 机械爬虫 |
|---|---|---|
| 请求间隔 | 忽长忽短,有停顿 | 固定值,均匀分布 |
| 访问路径 | 首页→列表→详情,有回退跳转 | 直奔目标页面 |
| 静态资源 | 正常加载图片、CSS、JS | 只请求HTML |
| 请求头 | 字段完整、顺序自然 | 缺字段、顺序怪异 |
| 时间分布 | 白天为主,有高峰低谷 | 24小时匀速跑 |
指纹伪装:让请求看起来像真实浏览器
指纹伪装的核心思路是:让每一个请求都像是从一台真实的、各不相同的设备上发出的。主要从三个层面入手。
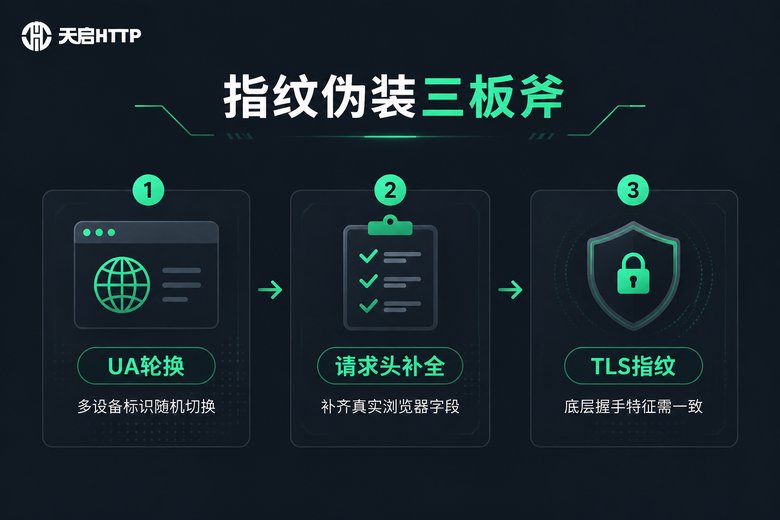
第一层:User-Agent轮换。准备一批主流浏览器和设备的UA,每次请求随机选用。注意UA要与其他信息自洽——如果你声称是手机浏览器,却请求了桌面版的页面结构,同样可疑。
第二层:请求头补全。真实浏览器会带上Accept、Accept-Language、Accept-Encoding、Referer等一整套字段,而且顺序是固定的。很多爬虫库默认只发User-Agent,字段残缺、顺序错乱,一眼就能识别。下面是一套可直接使用的请求头模板:
import random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36",
    # 建议维护20个以上,覆盖不同浏览器和版本
]

def build_headers(referer="https://www.example.com/"):
    return {
        "User-Agent": random.choice(USER_AGENTS),
        "Accept": "text/html,application/xhtml+xml,application/xml;"
                  "q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9",
        "Accept-Encoding": "gzip, deflate, br",
        "Connection": "keep-alive",
        "Referer": referer,
}第三层:TLS指纹。这是更底层的特征。服务器在建立HTTPS连接的握手阶段,就能根据客户端支持的加密算法组合,判断出你用的是Python脚本还是真实Chrome。普通网站一般不查这一层,但风控严格的站点会。如果遇到“请求头都伪装好了还是被拦”,大概率就是栽在TLS指纹上,这时候可以考虑改用能模拟真实浏览器TLS特征的请求方案。
另外还有一条容易被忽视的一致性原则:UA声称是中文环境的浏览器,Accept-Language却写着en-US;IP换了,Cookie和Session却原封不动地带过去——这些自相矛盾的细节都是风控的加分项。所有伪装信息必须互相印证,形成一个可信的“人设”。
拟人化:让行为节奏像真人
指纹解决的是“你是谁”,拟人化解决的是“你怎么行动”。再完美的指纹,配上机器人式的行为节奏,照样露馅。
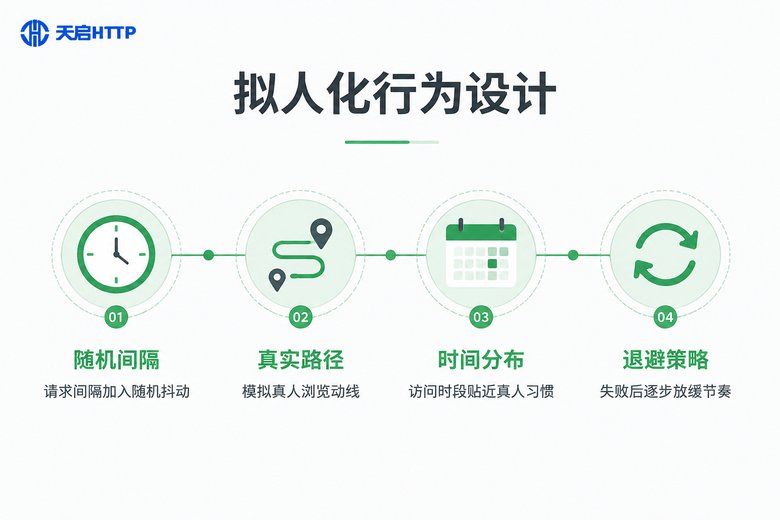
1. 随机间隔。不要用固定的time.sleep(2),而是加入随机抖动,让间隔有长有短:
import time
import random

def human_delay(base=2.0):
    """模拟真人浏览的随机停顿"""
    jitter = random.uniform(0.5, 1.5)
    time.sleep(base * jitter)

def polite_backoff(retry_times):
    """请求失败后指数退避,别硬刚"""
    time.sleep(2 ** retry_times + random.uniform(0, 1))
2. 真实路径。不要每次都直奔详情页。先访问首页,再进列表页,翻几页,最后进入详情——偶尔再点个分类、回个首页。让访问动线像真人“逛”出来的,而不是“抄”出来的。
3. 时间分布。真人不会凌晨三点还在匀速浏览。把采集任务安排在目标网站用户的活跃时段,请求量随时间有起伏,而不是24小时一条直线。
4. 退避策略。遇到验证码或403,正确做法是立即停止、逐步放缓、换IP休整,而不是加大频率硬冲。硬冲只会让IP死得更快,还可能连累整个IP段。
代理IP本身也要“能打”:选对服务商
前面讲的技巧解决的是“怎么用”,但代理IP本身的素质决定了地基牢不牢。如果IP段被大量爬虫用过、被目标网站重点标记,那么再好的伪装也是徒劳。
选择代理服务时,建议关注这几点:高匿名(目标服务器无法识别你在使用代理)、IP池规模与更新频率(有足够的干净IP可轮换)、稳定性与延迟(频繁掉线会让重试逻辑雪上加霜)、API提取方式(方便集成到现有爬虫框架)。
以国内代理服务商天启HTTP为例,其提供高匿名代理IP服务,支持通过API批量提取IP,可以直接对接requests、Scrapy等主流采集框架,配合前面讲的指纹伪装和拟人化策略使用:
import requests

# 通过天启HTTP的API提取到代理IP后
proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

resp = requests.get(
    "https://www.example.com/product/12345",
    headers=build_headers(referer="https://www.example.com/list?page=3"),
    proxies=proxies,
    timeout=10,
)
resp.raise_for_status()把干净的IP池 + 随机指纹 + 拟人化节奏三者组合起来,才是一套完整的应对方案:IP负责换身份,指纹负责换长相,行为负责换走路的姿势。三者缺一,都可能在某个环节被反爬系统抓住把柄。
常见问题
Q: 换了高匿代理还是被封,是IP的问题吗?
A: 不一定。高匿代理只解决“你是谁”的问题。如果请求头特征和行为节奏没变,网站依然能通过其他维度把你认出来。建议先自查UA是否轮换、请求头是否完整、频率是否过高。
Q: 指纹伪装需要做到什么程度?
A: 对大多数网站,做好UA轮换、请求头补全、随机间隔这三件事就够用了。只有风控特别严格的站点才需要关注TLS指纹这类底层特征,可以按需逐步升级。
Q: 拟人化会不会让采集效率变得很低?
A: 单线程确实会比裸跑慢,但换来的是长期稳定。可以通过多IP并发轮换来弥补速度损失——每个IP都保持拟人化的低频率,整体效率靠IP数量堆上去。
Q: IP被识别后,是换IP还是换策略?
A: 两者都要做。先让被识别的IP“休息”或直接淘汰,同时排查指纹和行为上的漏洞。只换IP不改策略,新IP会很快重蹈覆辙。
Q: 天启HTTP的代理IP怎么集成到爬虫里?
A: 通过API提取代理IP,在代码中设置proxies参数即可,requests、Scrapy等主流框架都原生支持,也可以结合IP池管理组件做自动轮换和失效剔除。