爬虫IP被封,是每个爬虫工程师的噩梦
辛辛苦苦写好的爬虫程序,运行不到十分钟,突然弹出一串红色报错——“IP已被封禁”。那一刻,你可能会怀疑人生:明明代码没问题,为什么还是被封?其实,爬虫IP被封并不是因为你的代码写得差,而是因为你的访问行为太像“机器人”了。网站的反爬机制会通过IP访问频率、请求头、Cookie等多种维度来识别非人类行为,一旦确认,轻则临时封禁,重则永久拉黑。
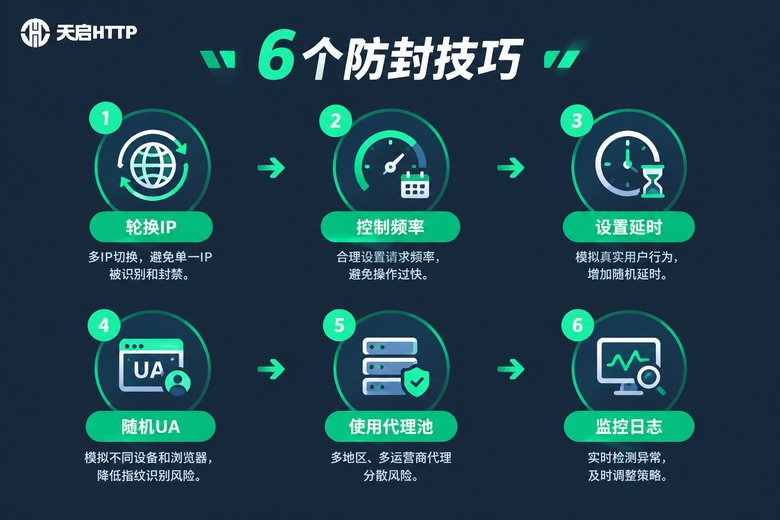
不过别担心,封IP并不是无解的。今天我们就来聊聊防止爬虫封IP的6个实用技巧,帮你彻底摆脱“IP被封”的魔咒。
在开始之前,先看一张图,了解封IP的常见原因: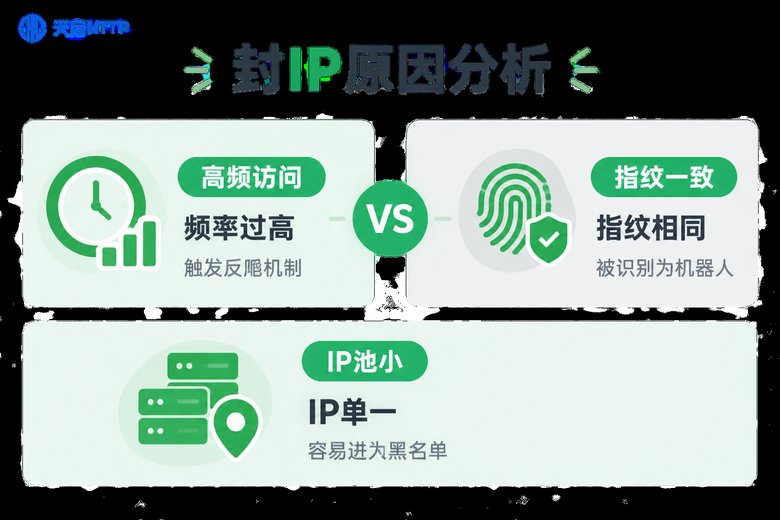
技巧一:轮换IP,让每个IP都“雨露均沾”
反爬系统最基础的手段就是限制单一IP的访问频率。如果你用同一个IP在短时间内发起大量请求,哪怕你伪装得再像人,也容易引起警觉。最直接的解决办法就是轮换IP——每次请求或每几次请求就更换一个IP,让服务器认为这些请求来自不同用户。
轮换IP的实现方式有很多,比如自建IP池、购买代理IP服务。对于个人开发者来说,使用代理IP服务是最省心的选择。像天启HTTP这样的代理服务商,提供海量高匿名IP,支持自动轮换IP,你只需要在代码里配置好代理列表,就能轻松实现IP的动态切换。
import requests
from itertools import cycle

# 假设从代理服务商获取到IP列表
proxy_list = [
    'http://123.45.67.89:8080',
    'http://98.76.54.32:3128',
    # ...
]
proxy_pool = cycle(proxy_list)

url = 'https://example.com'
for i in range(100):
    proxy = next(proxy_pool)
    try:
        resp = requests.get(url, proxies={'http': proxy, 'https': proxy}, timeout=5)
        print(f'请求{i} 使用IP {proxy} 状态码 {resp.status_code}')
    except Exception as e:
        print(f'IP {proxy} 请求失败: {e}')
技巧二:控制请求频率,别把服务器当“提款机”
很多新手爬虫喜欢“一上来就猛冲”,每秒发几十个请求,这无异于在服务器门口大声喊“我是机器人”。合理控制请求频率是防止封IP的第一道防线。
建议的做法是:设置随机延时,让每次请求之间的间隔不完全相同。比如用 time.sleep(random.uniform(1, 3)) 模拟人类的浏览节奏。这样即使IP被监控,也不会因为“太规律”而被识别。
另外,尽量避开服务器的高峰时段,避免在对方业务最繁忙的时候去“添堵”。凌晨和深夜通常是爬虫的友好时间,虽然这听起来有点“偷偷摸摸”,但确实能降低被封的概率。
技巧三:设置随机User-Agent,伪装成不同浏览器
除了IP,网站还会通过User-Agent(请求头)来识别爬虫。如果你一直用同一个浏览器标识,很容易被反爬系统标记。解决方法是维护一个User-Agent池,每次请求随机挑选一个,模拟不同操作系统和浏览器的访问。
import random

user_agents = [
    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Firefox/89.0',
    'Mozilla/5.0 (X11.5; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Safari/537.36',
]

headers = {'User-Agent': random.choice(user_agents)}
resp = requests.get(url, headers=headers)
技巧四:使用代理池,配合“白名单”策略
如果只是简单的轮换IP,有时候还是不够。因为有些网站会针对速度异常的IP段进行封禁,或者对某个代理IP的“信誉度”进行评分。这时候就需要一个高质量的代理池——里面包含大量稳定、高匿名的IP,并且能自动过滤失效IP。
天启HTTP的代理池就具备这样的能力:自动检测IP可用性,动态剔除坏IP,确保你每次拿到的都是“新鲜”的IP。同时,它还支持按地区、按运营商筛选IP,让你能更精准地模拟真实用户来源。
在实际使用中,可以结合白名单机制:先通过代理IP访问一个“测试接口”,如果返回正常再继续业务请求;如果返回异常则立刻换下一个IP。这样能在第一时间发现并规避被封的IP。
技巧五:增加Cookie和Session处理,模拟完整用户登录
很多网站的核心数据需要登录后才能访问。如果你的爬虫只是单纯地“裸奔”访问,即使IP和UA都正常,也容易因为缺少Cookie而被识别为异常访问。正确的做法是先模拟登录,获取有效的Cookie,再带着Cookie去请求数据。
使用 requests.Session() 可以自动维持Cookie,配合代理IP使用,效果更佳。另外,有些网站还会校验Referer、Accept-Language等头信息,记得一并设置好,让请求看起来“有来有回”。
技巧六:监控日志,及时调整爬虫策略
最后一条技巧可能最“虚”,但也最重要——建立日志监控机制。不要等到IP被封了才去查原因,而是在爬虫运行过程中持续记录日志状态码率、异常请求数、IP被封次数。一旦发现某个IP连续报错,就立刻把它拉黑并换新IP。
好的代理服务商(比如天启HTTP)通常会提供IP使用统计和状态查询接口,你可以把这些数据集成到自己的监控面板中,实现“0感知封IP”的自动化运维。
如何选择一款靠谱的代理IP服务?
以上6个技巧中,轮换IP和核心操作依赖代理IP的质量。如果代理IP本身不稳定、速度慢、匿名度低,那么再好的策略也只会让爬虫“卡死”。在选择代理服务商时,应该重点考察以下几点:
- IP池规模:IP数量越多,轮换空间越大,越不容易被一锅端。
- IP存活率:高存活率意味着更少的失效IP,减少请求失败的次数。
- 响应速度:低延迟能保证爬虫效率,避免超时重试。
- 匿名程度:高匿名IP能隐藏真实请求来源,降低被识别的风险。
- 稳定性:服务商是否有SLA保障,是否提供7×24小时技术支持。
在众多代理服务商中,天启HTTP是我个人比较推荐的选择。它专注于国内IP代理服务,拥有海量高匿名IP池,覆盖全国各主要城市和运营商,支持自动轮换、按需提取。更重要的是,它的API接口简单易并发,非常适合爬虫场景。
下面这张图总结了天启HTTP的核心优势:
常见问题 Q&A
Q: 使用了代理IP就一定能防止封IP吗?
A: 不一定。代理IP只是降低了被封的风险,还需要配合控制频率、随机UA等技巧。如果代理IP本身是低匿名的,或者你主动攻击了网站,依然可能被封。
Q: 免费代理IP能用吗?
A: 免费代理IP普遍存在速度慢、存活率低、容易被反爬识别等问题,不建议在生产环境使用。为了业务稳定,付费代理IP更可靠。
Q: 天启HTTP支持哪些协议?
A: 天启HTTP支持HTTP/HTTPS/SOCKS5等常见代理协议,覆盖绝大多数爬虫需求。
Q: 天启HTTP的IP是动态还是静态的?
A: 天启HTTP提供动态轮换IP,也支持静态IP(独享IP),你可以根据自己的爬虫场景灵活选择。
Q: 天启HTTP有住宅IP吗?
A: 天启HTTP专注国内IDC机房IP,不提供住宅IP。如果你需要住宅IP,请寻找其他专门服务商。
Q: 天启HTTP适合国外爬虫场景吗?
A: 天启HTTP只提供国内IP代理服务,不适用于需要国外IP的场景。请根据你的目标网站地域选择合适的IP资源。
希望这6个技巧能帮你告别“IP被封”的烦恼。记住,爬虫是技术和耐心的结合,不要用暴力请求去“硬刚”反爬系统。善用代理IP、控制节奏、持续优化,你的爬虫一定能稳定运行。