

为什么采集规模一大,单隧道就扛不住了
很多采集项目都是这样起步的:一条隧道代理、几十个并发、几个目标站点,跑起来顺顺当当。可随着业务扩张——要采的站点多了、数据量大了、时效要求高了——原本稳定的链路开始频繁超时,成功率一路下滑。这时候很多人第一反应是加机器、加线程,结果往往适得其反。
原因其实很简单:瓶颈不在你的服务器,而在代理链路本身。单隧道模式下,所有请求都挤在一条通道里,会遇到三类典型问题:
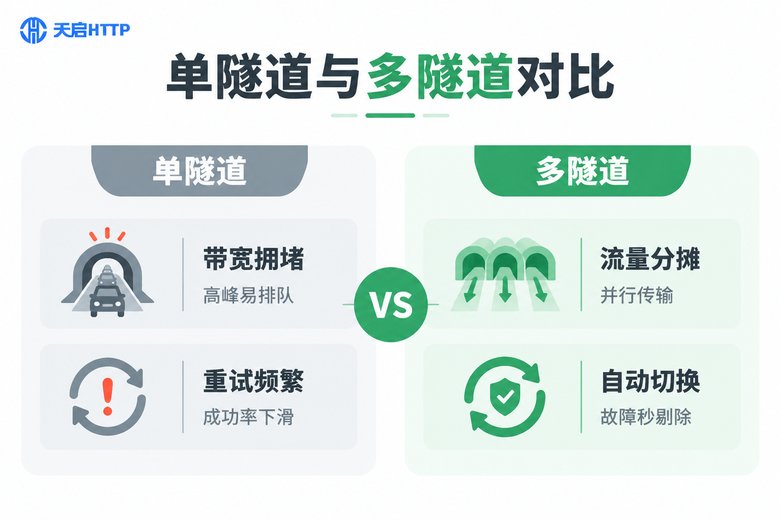
一是带宽拥堵。所有并发请求共享一条隧道的出口带宽,高峰期请求排队,单个请求的响应时间被拉长,整体吞吐量上不去。
二是IP轮换压力大。单条隧道能承载的IP轮换频率有限,同一出口IP在短时间内承载过多请求,容易触发目标站点的访问频率限制,失败率随之上升。
三是故障被放大。隧道一旦出现抖动,整个采集任务跟着卡壳;更麻烦的是,失败请求集中重试,形成"重试风暴",进一步加剧拥堵,陷入恶性循环。
当单机并发超过一定规模后,这些问题会集中爆发。此时继续堆机器意义不大,正确的思路是改造代理链路的架构。
多隧道负载均衡:把一条路扩成多车道
多隧道负载均衡的核心思想,用一句话概括就是:把多条隧道组成一个资源池,由调度器统一分配流量。就像高速公路从单车道扩成多车道,车流被分摊到每条车道上,整体通行能力成倍提升。
具体来说,这套机制包含三个关键环节:
1. 流量分发。所有采集请求先进入统一的调度入口,调度器按照预设策略把请求分配到不同的隧道上。常见策略有三种:轮询(依次分配,最简单)、加权轮询(性能好的隧道多分配一些)、最小连接(谁手里的请求少就给谁)。
2. 健康检查。调度器持续监测每条隧道的状态,一旦发现某条隧道响应变慢或失败率升高,就自动降低它的权重甚至临时剔除,避免"带病上岗"。
3. 失败切换。单个请求失败时,自动换一条隧道重试,而不是在原隧道上反复碰壁。配合合理的重试上限,既能保住成功率,又不会引发重试风暴。
实战:搭建一套多隧道高并发采集架构
理解了原理,落地其实并不复杂。一套实用的多隧道采集架构,通常分为四层:
任务队列层:把待采集的URL放进队列,由工作线程池按需领取,避免瞬时并发失控。
调度层:维护隧道列表和各自的状态,负责负载均衡和故障剔除,是整个方案的大脑。
隧道层:多条隧道并行工作,每条隧道背后由服务商自动轮换IP,采集端无需关心IP细节。
结果处理层:统一处理返回结果,记录失败原因,为后续调优提供数据支撑。
下面用一个简化的Python示例演示核心逻辑(隧道地址以服务商控制台提供的为准):
import requests
import itertools
from concurrent.futures import ThreadPoolExecutor

# 多条隧道地址(示例格式,实际以控制台提供的为准)
TUNNELS = [
    "http://用户名:密码@隧道地址1:端口",
    "http://用户名:密码@隧道地址2:端口",
    "http://用户名:密码@隧道地址3:端口",
]

# 轮询调度器:依次取用下一条隧道
tunnel_cycle = itertools.cycle(TUNNELS)

def fetch(url, max_retry=3):
    for _ in range(max_retry):
        proxy = next(tunnel_cycle)
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=8,
            )
            if resp.status_code == 200:
                return resp.text
        except Exception:
            continue  # 失败自动切换下一条隧道
    return None

urls = ["https://example.com/page/{}".format(i) for i in range(200)]

with ThreadPoolExecutor(max_workers=30) as pool:
    results = list(pool.map(fetch, urls))

ok = sum(1 for r in results if r is not None)
print("成功率: {:.1f}%".format(ok / len(urls) * 100))
这段代码只有几十行,但已经包含了多隧道方案的三个要素:轮询分发、失败切换、并发控制。实际生产中,你可以在此基础上升级调度策略,比如记录每条隧道的实时成功率,动态调整分配权重。

调优经验:让并发效率再上一个台阶
架构搭好只是第一步,参数调优决定了这套方案能发挥几成实力。以下是实践中总结的几条经验:
并发数不是越高越好。并发开太大,请求在隧道侧排队,超时和失败反而增多。正确做法是从一个保守值开始压测,观察成功率和平均耗时,逐步上调到拐点位置。
超时设置要贴合业务。超时太短会误杀慢请求,太长则拖慢整体节奏。一般建议5~10秒起步,再根据目标站点的实际响应情况微调。
重试要有上限和退避。无限重试就是重试风暴的根源。建议最多重试2~3次,并在重试之间加入随机等待,把重试压力在时间上摊开。
监控先行。成功率、平均耗时、各隧道健康度,这三个指标要实时可见。没有监控的调优就是盲调。
几个关键参数的参考起点如下:
| 参数 | 建议起点 | 说明 |
|---|---|---|
| 单机并发数 | 20~50 | 压测后逐步上调 |
| 请求超时 | 5~10秒 | 过长会拖慢整体节奏 |
| 重试次数 | 2~3次 | 配合随机退避使用 |
| 隧道数量 | 按峰值并发估算 | 建议预留20%余量 |
隧道代理服务怎么选
多隧道方案的效果,很大程度上取决于隧道服务本身的质量。选服务商时,建议重点考察四点:IP池的规模与质量(池子够大,轮换才有意义)、隧道的稳定性(延迟和掉线率直接决定成功率)、并发支持能力(是否允许高并发接入)、接入的便捷性(是否提供API提取、多协议支持)。
以天启HTTP为例,它是国内的代理IP服务商,提供隧道代理等动态代理产品:隧道模式下IP自动轮换,采集端只需对接固定的隧道入口,无需自己维护IP池;同时支持API批量提取的接入方式,方便团队按需自建调度逻辑。对于高并发采集这类场景,隧道代理加多隧道负载均衡的组合,是比较省心的落地方案。
需要提醒的是,天启HTTP面向的是国内IP使用场景,如果你的业务需要海外IP,它并不适用——选型前先确认自己的场景需求,再决定是否接入。

常见问题
Q: 多隧道负载均衡一定比单隧道快吗?
不一定。如果你的采集任务只有几十个并发、目标站点不多,单隧道完全够用,多隧道反而增加维护成本。多隧道的价值体现在高并发、多站点、高时效的场景,规模越大优势越明显。
Q: 并发数开得越高,采集就越快吗?
不是。并发超过链路承载能力后,请求会在隧道侧排队,超时和失败率上升,实际有效吞吐反而下降。建议通过压测找到成功率和吞吐量的平衡点,而不是盲目拉高线程数。
Q: 隧道代理和API提取代理应该怎么选?
隧道代理胜在省心,IP自动轮换,接入一个固定入口就能用,适合大多数采集团队;API提取代理胜在灵活,可以自己搭建IP池和调度逻辑,适合有自研能力、需求定制化的团队。两者也可以结合使用。
Q: 天启HTTP适合哪些业务场景?
适合数据采集、电商信息获取、舆情监测等需要国内IP的业务场景。它不提供海外IP,如果你的目标站点在境外且需要境外出口,需要另行选择合适的方案。