
自建代理池,到底在建什么?
做爬虫的人迟早会撞上同一堵墙:单IP跑不了多久就被目标网站限流、弹验证码,甚至直接封禁。于是"自建一个代理池"成了很多团队的选择。但真正动手时你会发现,代理池远不是"把IP存进数据库"那么简单——它是一套小型分布式系统,至少要由IP获取、存储、调度、检测、告警五个模块协作才能稳定运转。这篇文章就把这几个模块一个个拆开讲清楚:每个模块负责什么、常见的实现思路是什么、新手最容易踩的坑在哪里。
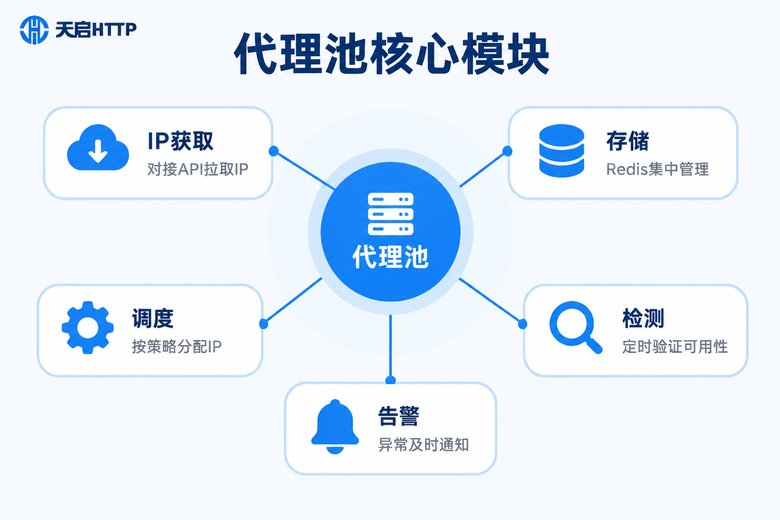
先看全景:代理池的五大核心模块
在写第一行代码之前,先建立整体认知。一个能扛住生产环境考验的代理池,数据流大致是这样的:IP获取模块从上游拉取IP → 存储模块把它们集中放进Redis → 检测模块定时验证每个IP的可用性并打分 → 调度模块根据分数和策略把IP分配给业务请求 → 告警模块全程盯着池子的健康状态,异常时第一时间通知你。
五个模块各司其职,缺了任何一个,池子都会在某个深夜悄悄"死亡"而你毫无察觉。下面重点展开标题里提到的三个核心:调度、检测、告警。
调度模块:代理池的"大脑"
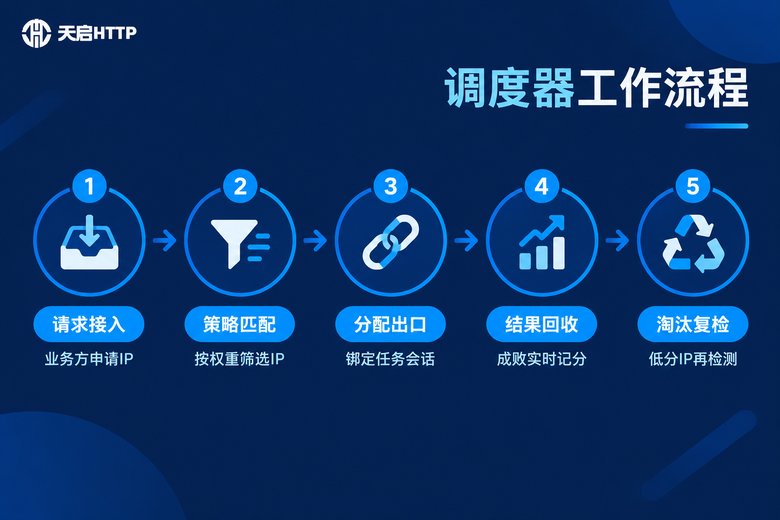
调度模块回答的问题是:某一个请求进来,该把哪个IP给它用?听起来简单,实际上策略选不对,池子利用率会差好几倍。常见的调度策略有四种,一张表看明白:
| 调度策略 | 实现难度 | IP利用率 | 适用场景 |
|---|---|---|---|
| 轮询 | 极低 | 一般 | IP质量均匀的小池子 |
| 随机 | 极低 | 一般 | 快速原型验证 |
| 权重调度 | 中等 | 高 | 生产环境主流选择 |
| 会话粘滞 | 较高 | 中 | 需登录态的长会话任务 |
轮询和随机实现最简单,但对IP质量一视同仁,坏IP会拖低整体成功率;权重调度给每个IP维护一个分数,检测通过加分、请求失败扣分,调度时优先取高分IP,是生产环境的主流方案;会话粘滞则针对需要登录态的采集业务,让同一任务始终绑定同一个IP。
一个基于Redis有序集合的极简权重调度器,核心代码不到30行:
import redis, random

r = redis.Redis(host="127.0.0.1", port=6379, db=0)

def get_proxy():
    """取分数前10的IP随机一个,避免流量全压在第一名身上"""
    top = r.zrevrange("proxy_pool", 0, 9, withscores=True)
    if not top:
        raise Exception("池内无可用IP,请检查采集与检测模块")
    return random.choice(top)[0].decode()

def report(proxy, success):
    """业务回调:成功+1,失败-3,扣到负分就踢进复检队列"""
    r.zincrby("proxy_pool", 1 if success else -3, proxy)
    score = r.zscore("proxy_pool", proxy)
    if score is not None and score < 0:
        r.zrem("proxy_pool", proxy)
r.sadd("proxy_recheck", proxy)这段代码体现了一个重要思想:调度和检测不是孤立的。业务请求的真实成败,是最宝贵的检测数据,必须实时回流到分数体系里。
检测模块:把失效IP挡在业务前面
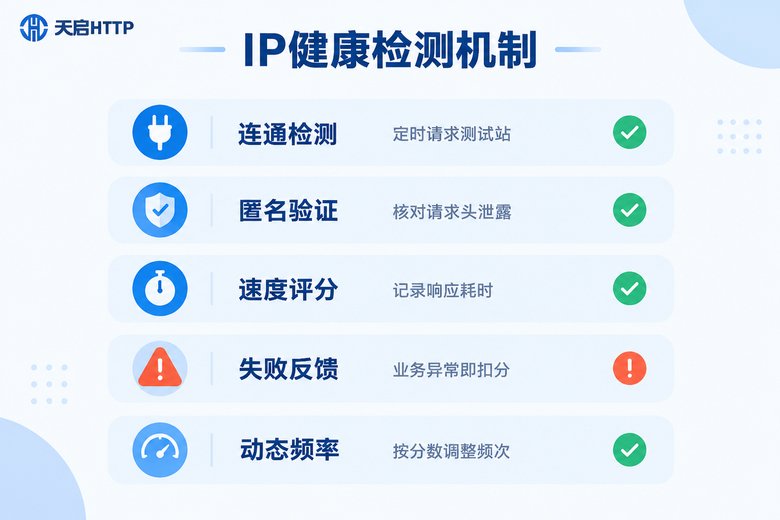
IP是消耗品,质量一般的来源可能几分钟前还能用、几分钟后就失效。如果不做检测,你的池子会变成一个"看起来有很多IP、用起来全是超时"的死池。检测模块要做四件事:
连通性检测:定时用池内IP请求一个稳定的测试地址,通不通、多久通,一测便知。匿名度验证:请求一个能回显请求头的地址,检查有没有泄露真实IP、有没有带着可疑的代理特征头。速度评分:记录每次检测的响应耗时,慢IP自动降权,让调度器自然冷落它们。被动检测:业务方每次请求的成败结果实时回传,这往往比定时检测更灵敏。
import requests, time

TEST_URL = "https://httpbin.org/get"   # 可换成你自己的探测接口
TIMEOUT = 5

def check(proxy):
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        resp = requests.get(TEST_URL, proxies=proxies, timeout=TIMEOUT)
        ok = resp.status_code == 200
    except Exception:
        ok = False
    cost_ms = int((time.time() - start) * 1000)
return ok, cost_ms检测频率是个平衡题:测得太勤,检测流量本身会消耗IP的"寿命";测得太懒,失效IP会在池子里滞留很久。经验值是刚入池的IP全量检测、高分IP低频抽检、低分IP高频复检,让检测频率跟着分数动态走。
告警模块:出问题之前先知道
前两个模块保证池子"正常运行",告警模块保证你"心里有数"。爬虫代理池最怕的不是故障,而是故障发生了半天没人发现——业务方只看到采集量暴跌,排查半天才发现是池子空了。告警模块要盯住四个关键指标:
可用IP数量:池内分数达标的IP总数,跌破阈值(比如低于50个)立即告警,这是最重要的水位线。取IP成功率:业务方请求IP却拿不到的比例,持续走高说明上游出了问题。平均响应时间:整体变慢往往预示着IP质量在批量下滑。上游API状态:如果你从服务商拉IP,提取接口本身的报错和限流也要监控。
告警一定要分级,不要什么动静都轰炸群里:
def alert(level, msg):
    if level == "critical":
        # 可用IP枯竭、上游API连续失败:电话 + 群里@所有人
        send_phone(msg)
        send_dingtalk(f"【严重】{msg}", at_all=True)
    elif level == "warning":
        # 水位偏低、响应时间抬升:群里发一条就够
        send_dingtalk(f"【提醒】{msg}")
绕不开的现实:池子建好了,IP从哪来?
最后说一个很多人想当然的问题。自建代理池解决的是管理问题——调度、检测、告警让IP用得井井有条;但池子里的IP本身从哪来,是另一件事。常见的两条路:
路一:免费代理。网上有大量免费代理列表,配合开源框架一晚上就能采几千个。但免费IP存活时间以分钟计、可用率常常不到一成,检测模块会被跑到满载,只适合学习练手,撑不起生产业务。
路二:接入服务商API作为上游。把服务商的提取API对接到你的"IP获取模块",进池的就是经过筛选的高质量IP,你的调度、检测、告警模块继续发挥价值——这是自建池在生产环境的标准姿势。
选上游服务商时,重点看协议支持、匿名度和IP质量。如果你的采集目标站点在国内,可以看看天启HTTP:国内IP代理服务商,支持HTTP/HTTPS/SOCKS5多协议、高匿名转发,自建机房保障稳定性,IP资源覆盖国内多个城市,并支持免费试用。把天启HTTP的提取接口对接进自建池的IP获取模块,先用你自己的检测脚本实测一轮可用率和响应速度,数据达标再放量——上游稳了,你的调度和告警模块才能真正发挥威力。
常见问题
Q: 自建代理池需要多少服务器资源?
小规模(池内几千个IP、日请求百万级以内)一台4核8G云主机加一个Redis就能起步;检测模块是CPU和网络消耗大户,规模上来后建议把检测服务单独拆一台机器跑,避免和业务互相抢资源。
Q: 检测频率设多少合适?
没有标准答案,参考思路:新入池IP立即全量检测,高分IP每5~10分钟抽检一次,低分IP每1~2分钟复检,连续多次失败直接淘汰。核心原则是检测频率与IP分数挂钩、动态调整。
Q: 调度策略直接用轮询不行吗?
能跑,但浪费。轮询对IP质量一视同仁,坏IP会拉低整体成功率。权重调度只比轮询多一张分数表,却能让好IP多干活、坏IP自动出局,是性价比最高的升级。
Q: 自建代理池和直接调服务商API有什么区别?
直接调API省事,但缺少统一调度、质量评分和水位监控,业务量大后容易失控。自建池相当于在API之上加了一层管理体系。更常见的做法是两者结合:服务商负责供IP,自建池负责管IP。
Q: 天启HTTP能接入自建代理池吗?
可以。天启HTTP提供标准的IP提取API,把接口对接到你自建池的IP获取模块即可,后续的存储、调度、检测、告警全部由你的池子接管。它支持HTTP/HTTPS/SOCKS5多协议、高匿名,覆盖国内多个城市,可以先申请免费试用,用真实业务数据验证质量后再决定是否长期使用。