很多做采集、挂机、接口对接的朋友都遇到过同一个问题:脚本跑着跑着突然报错,日志里写着连接被重置、读取超时、SSL 握手失败,一查发现是代理刚刚换了 IP。换 IP 本来是为了避开限制,结果反而把业务搞断了。
这篇文章不讲虚的,就从连接为什么会断开始,讲到心跳、超时、重试、退避这几个参数到底怎么调,最后给出可以直接抄走的代码和参数基线。
一、先搞明白:换 IP 为什么一定会断线
一条已经建立的 TCP 连接,是靠四个要素唯一确定的:你的 IP、你的端口、目标 IP、目标端口。这四项里任何一项变了,这条连接在双方的系统里就不再是"同一条"连接了。
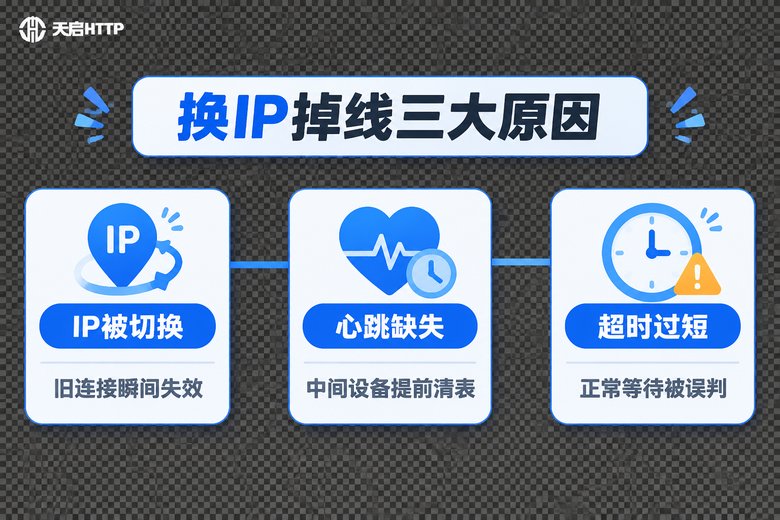
代理换 IP,本质上是把"你出去的那张脸"换掉了。旧连接在代理服务器上绑定的还是旧 IP,新 IP 一上线,旧连接没有归宿,就会被直接清掉。所以你会看到:请求发到一半,突然 Connection reset by peer,或者干脆卡住不动直到超时。
所以要先建立一个正确认知:
换 IP 和长连接天然是矛盾的。如果你的业务必须保持长连接(比如轮询接口、维持会话、挂机在线),那就不该用"每次请求换一个 IP"的方式,而应该用入口固定、出口轮换的隧道代理;如果你的业务本来就是一次性请求,那压根不需要长连接,把连接池和重试配好就行。
搞清楚这一点,后面的参数调整才有意义——很多掉线根本不是参数问题,是代理形态选错了。
二、三个关键参数:心跳、超时、保活
就算代理入口固定了,长连接还是可能断。最常见的"隐形杀手"是链路中间的 NAT 设备、防火墙和负载均衡,它们会维护一张连接状态表,长时间没有数据流动的连接会被判定为死连接并清理掉。常见的空闲清理阈值在 60 秒到 300 秒之间,不同机房差别很大。
你能做的,就是让连接"别闲着":
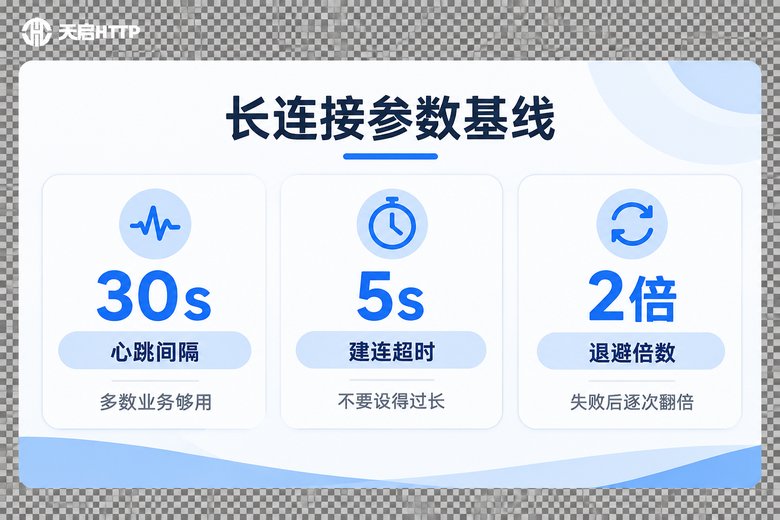
1. 心跳间隔:定期发一个极小的请求(比如 HEAD 请求或者业务上的轻量查询),保持链路活跃。经验值是30 秒左右,如果对方服务器对请求频率敏感,可以放宽到 60 秒,但不建议超过中间设备的最短空闲清理时间。
2. 建连超时(connect timeout):代理 IP 质量参差,建连超时设得太长,会让整个线程池被拖住。建议 3 到 5 秒,超过就换下一个节点。
3. 读取超时(read timeout):这个要按业务定。接口类 20 秒左右够用,下载类可以放到 120 秒。注意读取超时不能比心跳间隔还短,否则正常等待也会被误判成超时。
另外,如果你能控制底层 socket,可以开启 TCP 层的保活探测,让系统帮你发现"对端已经没了但本地还不知道"的半开连接。Linux 下大致是这样设置的:
import socket

sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sock.setsockopt(socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1)

# 空闲多少秒后开始探测
sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 30)
# 每次探测的间隔
sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10)
# 探测失败几次判定为断开
sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 3)
这样 30 + 10×3 = 60 秒内就能发现死连接,比干等着业务超时快得多。
三、重连参数怎么调:四步法
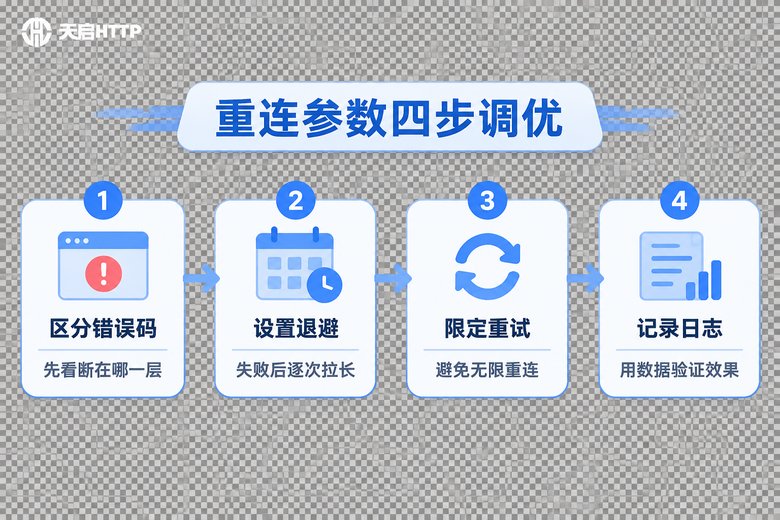
重连不是"失败了就一直重试",那样只会把自己打进对方的风控里。按下面四步调,稳定性提升会很明显。
第一步:先区分错误码,别一股脑重试。代理返回 407 是认证失败,重试一万次也没用,应该立刻告警;502、503、504 是代理侧节点问题,值得重试;连接重置、读取超时属于链路抖动,可以重试;而 403、429 往往是对方已经盯上你了,这时候该做的是换 IP而不是重试。
第二步:设置指数退避。第一次失败等 0.5 秒,第二次等 1 秒,第三次等 2 秒,逐次翻倍。再加一点随机抖动(比如随机浮动 0 到 0.3 秒),可以避免大量线程在同一时刻同时重连,把代理打出一波尖峰。
第三步:限定重试上限。一般 3 次足够。3 次还连不上,说明这个节点或者这个 IP 已经不行了,该做的是切换节点,而不是继续在原地上耗。
第四步:打日志,用数据验证。把每次断连的时间、错误类型、重试次数、当时的 IP 都记下来。跑一天你就能看出规律:是固定每 60 秒断一次(典型的心跳缺失),还是集中在某个 IP 段(典型的节点质量问题),还是只在高峰期断(典型的带宽打满)。
四、代码示例:把参数落到配置里
下面这段是用 requests 做重试和连接池配置的写法,关键参数都带了注释,可以直接改成自己的:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

session = requests.Session()
session.trust_env = False  # 忽略系统环境变量中的代理设置,避免串线

retry = Retry(
    total=3,                      # 最多重试 3 次
    backoff_factor=0.5,           # 退避倍数:0.5s / 1s / 2s
    status_forcelist=[502, 503, 504],  # 只对这些状态码重试
    allowed_methods=["GET", "POST"],
    raise_on_status=False,
)

adapter = HTTPAdapter(
    max_retries=retry,
    pool_connections=30,          # 连接池数量
    pool_maxsize=30,
    pool_block=False,             # 池满时不阻塞,直接新建
)
session.mount("http://", adapter)
session.mount("https://", adapter)

# 隧道代理:入口和端口固定,出口 IP 由服务端轮换
proxies = {
    "http":  "http://账号:密码@隧道域名:端口",
    "https": "http://账号:密码@隧道域名:端口",
}

resp = session.get(
    "http://你的目标站/api/list",
    proxies=proxies,
    timeout=(5, 20),   # (建连超时, 读取超时)
)
print(resp.status_code)
如果用的是异步框架,重点在连接器的保活设置上:
import aiohttp

timeout = aiohttp.ClientTimeout(
    total=None,      # 长连接场景不要设整体超时
    connect=5,       # 建连 5 秒
    sock_read=60,    # 单次读取 60 秒
)

connector = aiohttp.TCPConnector(
    limit=50,
    limit_per_host=10,
    keepalive_timeout=60,      # 空闲连接保留 60 秒
    enable_cleanup_closed=True,
)

async with aiohttp.ClientSession(timeout=timeout, connector=connector) as s:
    async with s.get("http://你的目标站/api/list", proxy="http://账号:密码@隧道域名:端口") as r:
        data = await r.text()
小提醒:账号密码里如果包含 @、#、: 这类特殊字符,一定要先做 URL 编码,否则代理地址会被解析错,报出来的错误往往还是"认证失败",很容易让人误判成掉线。
五、不同业务场景的参数基线
参数没有万能值,要看业务形态。下面这张表可以当作起点,再根据自己日志里的实际断连情况微调:
| 业务场景 | 心跳间隔 | 建连超时 | 读取超时 | 最大重试 | 推荐代理形态 |
|---|---|---|---|---|---|
| 网页采集(短请求) | 不需要 | 5 秒 | 15 秒 | 2 次 | 短效 IP,失败即换 |
| 接口轮询 | 30 秒 | 5 秒 | 20 秒 | 3 次 | 隧道代理(固定入口) |
| 挂机 / 在线保活 | 20 到 30 秒 | 5 秒 | 60 秒 | 3 次 | 隧道代理(固定入口) |
| 大文件下载 | 60 秒 | 10 秒 | 120 秒 | 1 次 | 独享 IP |
| 高频注册 / 抢购 | 不需要 | 3 秒 | 10 秒 | 2 次 | 短效 IP,快速切换 |
六、选对代理形态,比反复调参数更省事
说到底,参数调整解决的是"抖动之后能多快恢复",而代理形态决定的是"到底会不会抖"。如果你的业务需要长时间保持会话,那就应该用固定入口的方式——客户端始终连同一个域名端口,出口 IP 的轮换交给服务端去做,客户端这一侧根本不感知 IP 变化,连接自然不会因为换 IP 而被重置。
天启HTTP 提供的就是这类国内代理 IP 服务,支持 HTTP、HTTPS、SOCKS5 协议,有短效代理、独享代理和隧道代理几种形态,可以通过 API 提取 IP,也可以走隧道转发固定入口,认证支持账密和白名单两种方式。对需要长连接的场景,隧道代理比频繁提取短效 IP 要稳得多;对并发要求高的采集任务,独享代理能避免和别人共用出口带来的互相影响。
实际选型建议很简单:能固定入口就别频繁换 IP,必须换 IP 的请求就别硬上长连接。这两句话能解决八成"换 IP 就掉线"的问题。
常见问题
Q:我的脚本每次请求都换 IP,为什么偶尔会卡住十几秒?
大概率是读取超时设得太长加上没有重试。建议把建连超时压到 5 秒以内,读取超时按业务压缩,并开启 2 到 3 次带退避的重试,卡顿会明显减少。
Q:心跳明明设了 30 秒,还是每 5 分钟断一次,为什么?
先怀疑链路中间设备的空闲清理阈值比 30 秒还短,或者心跳请求被对方服务器限流没真正发出去。把心跳间隔临时改成 15 秒对比一下,如果断连周期变了,说明就是心跳问题;如果周期不变,那更可能是代理节点本身的会话上限。
Q:重试次数是不是越多越稳?
不是。重试次数过多会把一次失败放大成几十次无效请求,既拖慢整体速度,也容易触发对方的风控。3 次是通用上限,超过就切换节点更划算。
Q:用了隧道代理以后,出口 IP 一直在变,会不会还是断?
不会。隧道代理的机制是客户端连接始终落在固定的入口上,出口 IP 变化发生在服务端内部,对客户端而言是一条稳定的连接,不会出现换 IP 导致连接重置的情况。
Q:怎么判断掉线是我的代码问题还是代理 IP 的问题?
做个简单对照:用同一个脚本、同一组参数,分别走代理和不走代理各跑一小时。如果只在走代理时断,看日志里的错误类型——认证类错误是配置问题,连接重置和超时集中在某些 IP 上就是 IP 质量问题,此时把失败 IP 记录下来反馈或直接换一批即可。
Q:天启HTTP 支持长连接场景吗?
支持。通过隧道代理可以保持固定入口长期在线,配合合理的心跳和重试参数,适合接口轮询、在线保活这类需要稳定会话的业务;具体接入方式可以看官网的接口说明文档。