为什么换代理IP不能"一键切换"
很多团队换代理IP的方式很直接:旧的不太好用,就在配置里把新的提取链接贴上去,重启服务,完事。看起来省事,但问题往往在半小时后才爆发——请求大面积超时、目标站点开始返回 403、业务方打电话过来问为什么订单同步停了。这时候你连"是新IP的问题还是业务本身的问题"都分不清。
代理IP本质上是你和业务系统之间的一层通道,通道一换,出口地址、访问频率特征、网络路径全都变了。目标站点对新出现的一批地址往往会先观察一段时间,而你的业务又在同时跑着,任何一边抖动都会互相甩锅。正确的做法是把"换IP"当成一次小型的上线发布:先验证新池子能不能用,再按比例灰度切流,最后准备好随时回滚。
下面这套流程不复杂,一个下午就能跑完一遍,但能挡掉绝大多数翻车场景。
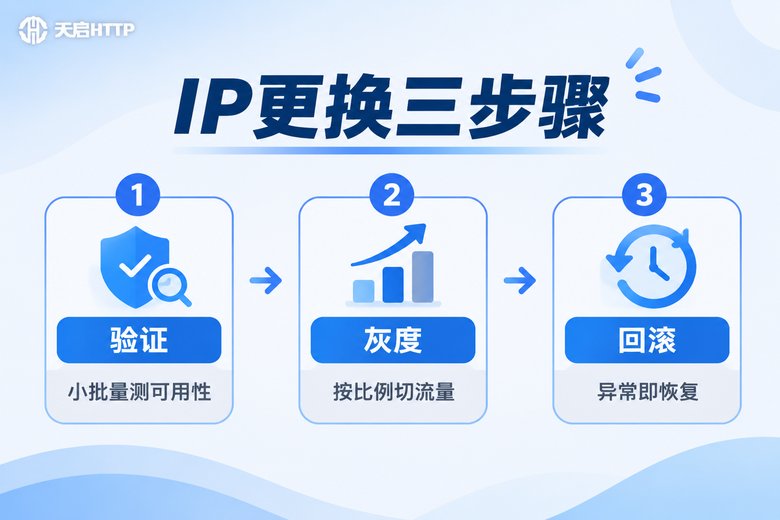
第一步:验证——新IP池先体检再上岗
验证的核心问题是:这批新IP拿到你的真实业务目标上,到底能不能干活?注意"真实业务目标"这几个字,用搜索引擎首页测试通过,不代表你的目标站点也通过,不同站点的风控严格程度差得远。
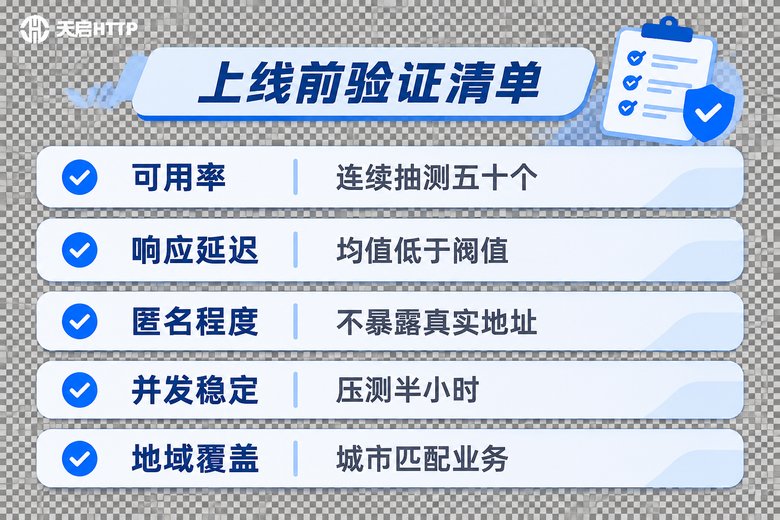
建议抽取 30~50 个 IP 做一轮抽样检测,重点看五个指标:
- 可用率:能正常完成请求的比例,低于 80% 就该找服务商确认了。
- 响应延迟:取平均值和 90 分位,均值突然比旧池高一倍就要警惕。
- 匿名程度:确认目标站点拿到的不是你的真实出口地址,也没有多出奇怪的转发头。
- 并发稳定:单IP连续压测,看会不会跑到一半就掉线。
- 地域覆盖:业务要求哪个城市的地址,就重点验证那个城市,别拿全国池的平均水平糊弄自己。
写个脚本跑一遍最省事:
import time
import requests

EXTRACT_URL = "你的API提取链接"          # 服务商后台可直接复制
TEST_URL = "https://你要访问的业务目标"   # 换成真实目标地址

def check(proxy):
    proxies = {"http": proxy, "https": proxy}
    start = time.time()
    try:
        r = requests.get(TEST_URL, proxies=proxies, timeout=8)
        return r.status_code == 200, round((time.time() - start) * 1000)
    except Exception:
        return False, None

ip_list = requests.get(EXTRACT_URL).text.strip().splitlines()[:50]
ok, costs = 0, []

for ip in ip_list:
    proxy = "http://" + ip.strip()
    success, cost = check(proxy)
    ok += success
    if cost:
        costs.append(cost)
    print(proxy, "可用" if success else "失败", cost, "ms")

costs.sort()
print("可用率:", f"{ok / len(ip_list):.0%}")
print("平均延迟:", sum(costs) // len(costs), "ms")
print("90分位:", costs[int(len(costs) * 0.9)], "ms")
把这份报告和旧池的同期数据摆在一起对比,新池各项指标不低于旧池的 90%,才算通过验证。不达标就别急着往下走,先让服务商换个池子或者调整提取方式。
第二步:灰度——把流量一点一点搬过去
验证通过只说明"能用",不代表"扛得住真实业务量"。灰度就是把新IP放进真实流量里,但只给它很小的一份,边跑边看。
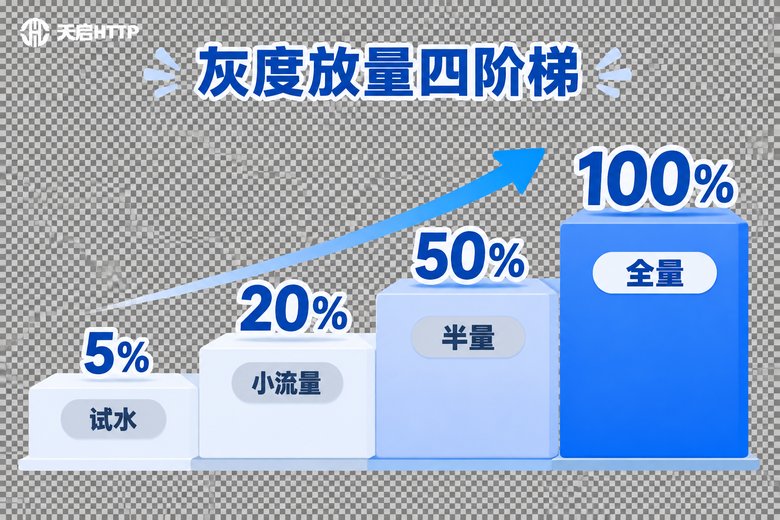
比较稳妥的四级阶梯是 5% → 20% → 50% → 100%。第一级只放 5%,跑半小时看有没有报错;20% 跑一小时,重点盯平均延迟和封禁数量;50% 跑两小时,看业务侧的成功率有没有下滑;全量之后再观察一整天。
实现上不需要改业务代码,在分配代理的那一层加个比例开关就够了:
import random

GRAY_RATIO = 0.2    # 当前灰度比例:0.05 -> 0.2 -> 0.5 -> 1.0
FAIL_LIMIT = 0.05   # 失败率红线

def pick_proxy(new_pool, old_pool):
    """按比例把请求分给新IP池,其余仍然走旧通道"""
    if new_pool and random.random() < GRAY_RATIO:
        return new_pool.pop(), "new"
    return old_pool.pop(), "old"

def need_rollback(fail_rate):
    return fail_rate > FAIL_LIMIT
灰度期间必须保持双通道并行:旧IP池不要提前下线、不要取消订阅,配置里的新旧两套提取链接同时存在。这是回滚能不能做成的物理前提,很多人就是这一步图省事,结果想退都退不回去。
| 阶段 | 新IP承担流量 | 观察时长 | 重点看什么 | 回滚阈值 |
|---|---|---|---|---|
| 试水 | 5% | 30 分钟 | 请求失败率、连接超时 | 失败率 > 5% |
| 小流量 | 20% | 1 小时 | 平均延迟、封禁与 403 数量 | 延迟比旧池翻倍 |
| 半量 | 50% | 2 小时 | 业务成功率、并发承载 | 成功率跌 3 个百分点 |
| 全量 | 100% | 1 天 | 整体稳定性、IP消耗速度 | 触及任一红线 |
第三步:回滚——把退路提前准备好
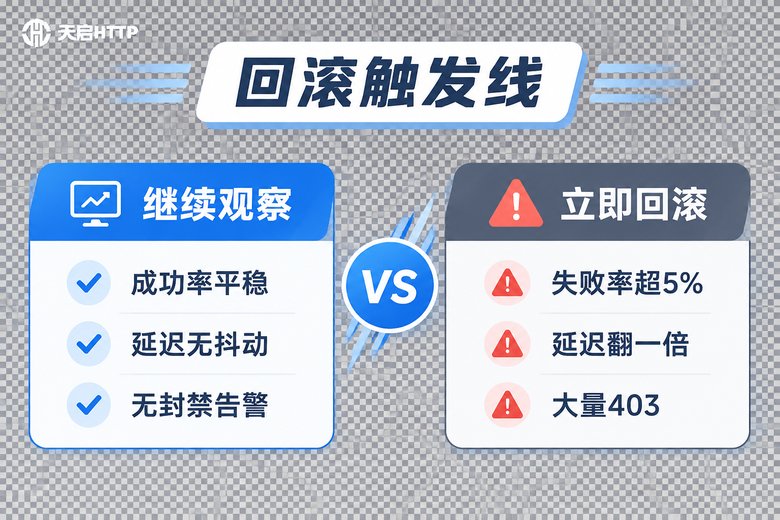
回滚不是"出事了再说",而是在灰度开始前就写好的预案。它至少包含三样东西:一个能秒切的开关、一份旧通道的可用资源、一条明确的触发线。
开关可以是一个配置中心的字段,也可以是一个环境变量,改完立即生效、不用重启服务。旧通道的资源要留够——如果旧IP池只剩几百个IP,切回去照样扛不住,等于没有退路。触发线则要提前跟业务方对齐,写进值班文档,避免出事时还在群里争论"这算不算严重"。
触发线可以参考这组:新池失败率超过 5%、平均延迟比旧池翻倍、短时间内出现大量 403 或验证码、业务侧成功率跌破历史均值。任意一条命中,先回滚,再排查原因——顺序不能反,排查完再切回来也不迟。
回滚动作本身很简单:把灰度比例改回 0,让所有流量回到旧通道,同时冻结新池的提取任务,避免继续消耗。回滚完成后记得记录三件事:回滚时间、触发指标、当时的新池快照。这份记录是下一轮灰度最值钱的参考。
完整流程的时间表
把三步串起来,一次完整的代理IP更换大概是这样的节奏:
T+0        抽 50 个新IP做验证,输出可用率/延迟报告
T+1h       报告达标,新旧池并行,灰度比例设为 5%
T+1.5h     5% 阶段无异常,提到 20%
T+2.5h     20% 阶段指标平稳,提到 50%
T+4.5h     50% 阶段业务成功率无下滑,提到 100%
T+1d       全量观察一天,旧池资源保留 3 天再回收
看起来比"直接替换"多了几个小时,但这几个小时换来的是可控的风险边界。没有灰度的切换,本质上是把事故概率交给运气。
选对IP来源,流程才跑得顺
上面这套流程能顺利执行,前提是手里的代理IP资源本身要稳、要可批量管理。天启HTTP 是国内 HTTP 代理IP服务商,产品覆盖短效动态IP、静态长效IP、隧道代理等多种形态,支持 API 提取,可灵活对接上面的验证脚本和灰度开关;IP 资源覆盖国内主要城市,支持 HTTP / HTTPS / SOCKS5 协议,高匿名访问。
实际操作中建议这样搭配:验证和灰度阶段用短效动态IP可以快速批量抽取样本,全量稳定运行后改用静态长效IP或隧道代理,减少频繁更换带来的抖动。如果你需要独享资源,也可以选择独享IP产品,避免和其他用户共享出口带来的干扰。
关键在于:把IP采购、验证、灰度、回滚当成一套固定动作沉淀下来,换一次IP就跑一遍,跑得多了,这套流程会变成团队的标准操作,而不是每次都靠某个人临场发挥。
常见问题
Q:灰度每个阶段必须卡满时间吗?
不必死守时长,但建议至少覆盖一个业务高峰。低峰期跑一小时没问题,高峰期可能五分钟就暴露问题。如果业务有明显的高峰低谷,灰度尽量安排在高峰期做,更容易发现问题。
Q:灰度期间成功率只掉了一点点,要回滚吗?
看你提前定的红线。如果掉幅在红线内,可以继续观察一个阶段;一旦触及红线就回滚,不要用"再等等看"来说服自己。回滚的代价远小于事故的代价,而且回滚之后重来一遍成本很低。
Q:不写代码,能实现灰度切换吗?
可以。很多团队用配置中心、Nginx 分流规则,或者直接把新IP池配给一部分服务器/一部分账号使用,本质上都是按比例切流量。核心是"比例可调、随时能退",实现形式无所谓。
Q:验证阶段抽多少个IP合适?
30~50 个足够判断池子的整体质量。抽得太少容易被个别坏IP带偏,抽得太多又浪费时间。如果业务对地域敏感,记得每个目标城市都抽几个。
Q:新旧IP池要并存多久?
建议全量稳定运行后至少保留 3 天再回收旧池。前几天往往是"看起来没问题、突然某类请求开始报错"的高发期,留着旧通道随时能退,成本也就是几天资源费用。
Q:更换频率多高比较合适?
取决于业务场景。按请求量消耗快的业务可能需要每天补充新IP,稳定的数据同步类业务可以几周甚至更久换一次。每次更换都按验证、灰度、回滚三步走,频率高也不会乱。